

Planejar uma migração com linhagem de migração
É possível usar o serviço de linhagem de migração para visualizar o fluxo de dados e as conexões no banco de dados de origem ao planejar uma migração de data warehouse do BigQuery.
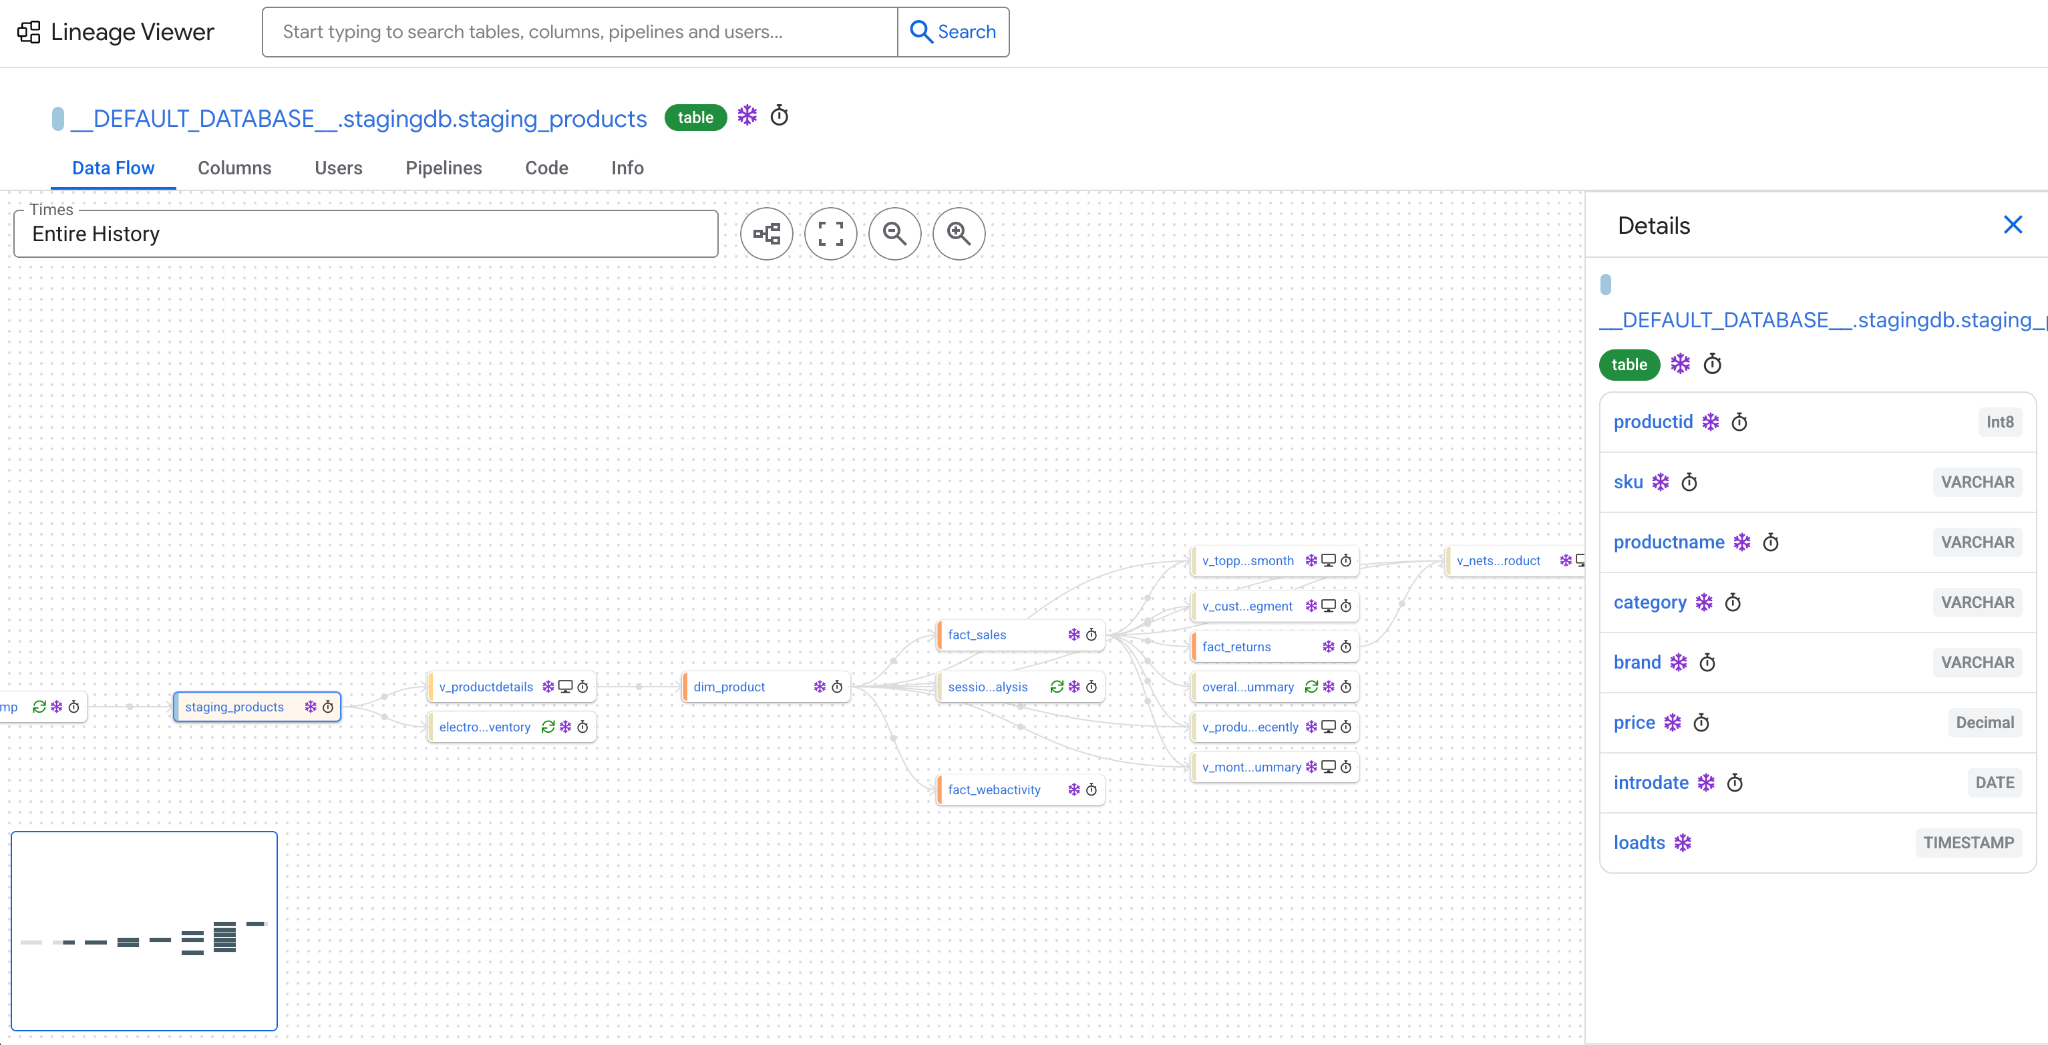
Quando você cria uma linhagem de migração, o serviço de linhagem fornece um gráfico que visualiza como os dados se movem pelo sistema de origem e como cada tabela ou visualização no sistema de origem está conectada, conforme mostrado no diagrama a seguir:
O serviço de linhagem de migração é compatível com os seguintes dialetos SQL:
- SQL do Amazon Redshift
- SQL do Snowflake
- SQL do Teradata
- GoogleSQL (BigQuery)
Limitações
O serviço de linhagem processa os primeiros 5 GB dos registros mais antigos do banco de dados de origem.
Locais suportados
O serviço de linhagem de migração está disponível em alguns locais. Para mais informações, consulte Locais do tradutor de SQL do BigQuery e do serviço de linhagem.
Permissões necessárias
Para receber as permissões necessárias para usar o serviço de linhagem de migração, peça ao administrador para conceder a você o papel do IAM de Editor do MigrationWorkflow (roles/bigquerymigration.editor) no projeto.
Para mais informações sobre a concessão de papéis, consulte Gerenciar o acesso a projetos, pastas e organizações.
Esse papel predefinido contém as permissões necessárias para usar o serviço de linhagem de migração. Para acessar as permissões exatas necessárias, expanda a seção Permissões necessárias:
Permissões necessárias
As seguintes permissões são necessárias para usar o serviço de linhagem de migração:
-
bigquerymigration.workflows.create -
bigquerymigration.workflows.get -
bigquerymigration.lineageDbs.query
Essas permissões também podem ser concedidas com funções personalizadas ou outros papéis predefinidos.
Para mais informações sobre os papéis e as permissões do IAM no BigQuery, consulte Papéis e permissões do BigQuery IAM.
Rastrear uma linhagem de migração
Para rastrear uma linhagem de migração, primeiro execute a ferramenta dwh-migration-dumper para
gerar arquivos de registro SQL de entrada de origem que você faz upload para o Cloud Storage.
Depois de fazer upload dos arquivos de entrada para o Cloud Storage, é possível rastrear a linhagem de migração com o console do Cloud de Confiance ou a API BigQuery Migration.
Execute a ferramenta dwh-migration-dumper
Selecione uma das seguintes opções:
Amazon Redshift
Para rastrear e visualizar uma linhagem de migração em um banco de dados do Amazon Redshift, faça o seguinte:
- Execute a ferramenta
dwh-migration-dumperpara gerar um dump dos arquivos do sistema de origem. - Faça upload dos registros de consulta para o Cloud Storage.
Snowflake
Para rastrear e visualizar uma linhagem de migração em um banco de dados do Snowflake, faça o seguinte:
- Execute a ferramenta
dwh-migration-dumperpara gerar um dump dos arquivos do sistema de origem. - Faça upload dos registros de consulta para o Cloud Storage.
Teradata
Para rastrear e visualizar uma linhagem de migração em um banco de dados do Teradata, faça o seguinte:
- Execute a ferramenta
dwh-migration-dumperpara gerar um dump dos arquivos do sistema de origem. - Faça upload dos registros de consulta para o Cloud Storage.
BigQuery
Para rastrear e visualizar uma linhagem de migração em um banco de dados do BigQuery, faça o seguinte:
- Conceda à conta ou à conta de serviço os seguintes papéis:
- Leitor de metadados do BigQuery (
roles/bigquery.metadataViewer) - Leitor do Data Catalog (
roles/datacatalog.viewer)
- Leitor de metadados do BigQuery (
- Instale a ferramenta
dwh-migration-dumper. Para gerar metadados e registros de consulta, execute a ferramenta
dwh-migration-dumper. Esses metadados e registros de consulta estão contidos em um ou mais arquivos ZIP.dwh-migration-dumper --connector bigquery dwh-migration-dumper --connector bigquery-logs
Faça upload dos arquivos ZIP para um bucket do Cloud Storage. Para mais informações sobre como criar buckets e fazer upload de arquivos para o Cloud Storage, consulte Criar um bucket e Fazer upload de objetos de um sistema de arquivos.
Rastrear linhagem
Depois de fazer upload dos arquivos ZIP que contêm os metadados e os registros de consulta para o Cloud Storage, é possível rastrear a linhagem. Selecione uma das seguintes opções:
Console
Acesse a página Seus serviços de migração.
Em Rastrear linhagem, clique em Rastrear tradução.
Em Configuração de linhagem, insira o seguinte:
- Em Nome de exibição, especifique um nome para o job de linhagem. O nome pode conter letras, números ou sublinhados.
- Em Local de processamento, selecione o local em que você quer que o job de linhagem seja executado.
Em Editar local do diretório de entrada, especifique o caminho para a pasta do Cloud Storage que contém os arquivos ZIP de registro que você enviou anteriormente. É possível digitar o caminho no formato
bucket_name/folder_name/ou clicar em Procurar. Também é possível nomear o subdiretório dos arquivos de saída no campo Nome do subdiretório de saída.Para adicionar mais arquivos de entrada, clique em Adicionar um local de diretório de entrada.
Clique em Trace.
O job de linhagem está em execução. O job pode levar várias horas para ser concluído, dependendo do tamanho da entrada. Depois que o job é concluído, a ferramenta fornece um link para a linhagem de migração rastreada.
API
Para rastrear um job de linhagem, execute o seguinte comando curl:
  curl -d "{
    \"tasks\": {
      \"TASK_NAME\": {
        \"type\": \"Experimental_Lineage\",
        \"translation_details\": {
          \"target_base_uri\": \"BUCKET_PATH\",
          \"source_target_mapping\": {
            \"source_spec\": {
              \"base_uri\": \"BUCKET_PATH\"
            }
          },
          \"target_types\": \"LINEAGE\"
        }
      }
    }
  }
  " \
    -H "Content-Type:application/json" \
    -H "Authorization: Bearer TOKEN" -X POST https://bigquerymigration.googleapis.com/v2/projects/PROJECT_ID/locations/LOCATION/workflows
Substitua:
TASK_NAME: um nome para identificar esse job de linhagem.BUCKET_PATH: o caminho para o bucket do Cloud Storage que contém os arquivos ZIP de entrada.PROJECT_ID: o ID do projeto do Cloud de Confiance .LOCATION: um local de processamento. Esse valor precisa sereuouus.
Essa chamada retorna uma mensagem semelhante a esta:
  {
    "name": "projects/PROJECT_ID/locations/LOCATION/workflows/WORKFLOW_ID",
    "tasks": {
      "task_name": { /*...*/ }
    },
    "state": "RUNNING"
  }
O job de linhagem está em execução. O job pode levar várias horas para ser concluído, dependendo do tamanho da entrada. Para verificar o status do job de linhagem,
execute o seguinte comando curl com o ID do fluxo de trabalho:
  curl \
  -H "Content-Type:application/json" \
  -H "Authorization:Bearer " -X GET https://bigquerymigration.googleapis.com/v2/projects/PROJECT_ID/locations/LOCATION/workflows/WORKFLOW_ID
Depois que o job é concluído, a ferramenta fornece um link para a visualização de linhagem rastreada.
Abrir a linhagem de migração
Depois de rastrear uma linhagem de migração, é possível abri-la usando uma das seguintes opções:
Console
Acesse a página Seus serviços de migração.
Em Rastrear linhagem, clique em Ver recentes.
Na página Linhagem de migração, clique no nome do job para selecionar o job de linhagem completo.
Na página Detalhes da tradução, clique em Linhagem de dados.
API
Para abrir uma linhagem de migração concluída, execute o seguinte comando curl com
a API BigQuery Migration:
  curl \
  -H "Content-Type:application/json" \
  -H "Authorization:Bearer " -X GET https://bigquerymigration.googleapis.com/v2/projects/PROJECT_ID/locations/LOCATION/workflows/WORKFLOW_ID
Substitua:
PROJECT_ID: o ID do projeto do Cloud de Confiance .LOCATION: um local de processamento. Esse valor precisa sereuouus.WORKFLOW_ID: o ID do fluxo de trabalho da linhagem rastreada.
Acesse o link incluído no campo
taskResult.translationTaskResult.consoleUri da mensagem de saída.
Trabalhar com linhagem de migração
As seções a seguir descrevem como usar a linhagem de migração para trabalhar com os dados e o banco de dados de origem.
Entender os termos de linhagem de migração
Os seguintes termos são usados em uma linhagem de migração:
| Termos | Descrição |
|---|---|
| Scripts | Scripts SQL e outros programas visíveis nos registros do banco de dados ingeridos durante a criação da linhagem. Os scripts são compostos por instruções, que geralmente são instruções SQL únicas. |
| Nós | Os vértices do gráfico de linhagem. Eles consistem em tabelas e colunas. |
| Tabelas | Também chamadas de relações, incluindo tabelas comuns, visualizações, arquivos estruturados e outros recursos semelhantes a tabelas. |
| Colunas | Também chamados de atributos, incluindo colunas de tabela, projeções de visualização, pseudocolunas, campos semelhantes a colunas em arquivos e outros recursos, além de subcolunas, como campos de struct. |
| Bordas | Conexões entre nós de linhagem que indicam interações devido a um pipeline que executa um script que leu ou gravou esses nós. As arestas são anotadas com carimbos de data/hora, predicados e outros metadados de quando a aresta foi derivada. Um nó adjacente a outro nó com uma borda é chamado de conexão direta. Um caminho de bordas entre dois nós é chamado de conexão indireta. |
| Arestas de linhagem | Arestas direcionais que indicam que o nó de origem foi incluído em uma cláusula, como FROM, WHERE ou GROUP BY, que influenciou os dados do nó de destino. |
| Usuários e pipelines | Rótulos de metadados fornecidos pelo banco de dados de origem sobre quem e o que executou os scripts. Eles não têm significado inerente para o mecanismo de linhagem, mas são usados para agrupar scripts por origem. |
As seções a seguir descrevem as diferentes páginas em uma linhagem de migração.
Analisar a página de destino
A página de destino da linhagem de migração mostra o ID do job de linhagem, um campo de pesquisa para localizar objetos de linhagem por nome e uma lista de sugestões que destaca alguns objetos de linhagem que podem ser interessantes. A página também inclui as contagens totais de tabelas, pipelines e usuários em toda a linhagem de migração.
Para navegar até uma tabela, visualização ou coluna específica, pesquise o objeto no campo de pesquisa ou clique em um dos objetos sugeridos na página de destino.
Analisar a página do nó
Para analisar os nós na linhagem de migração, clique em uma das guias a seguir.
Guia "Fluxo de dados"
A guia Fluxo de dados mostra uma representação visual de uma parte do gráfico de linhagem. É a página padrão quando você visualiza uma tabela ou coluna pela primeira vez no serviço de linhagem. O gráfico mostra como os dados se movem pelo sistema de origem. Os nós nesse gráfico representam tabelas ou visualizações, enquanto as bordas entre os nós representam dados que fluem dos nós à esquerda para os nós à direita.
Cada tabela no gráfico de fluxo de dados mostra o nome não qualificado. Para ver o nome totalmente qualificado de uma tabela com o prefixo do banco de dados e do esquema, mantenha o ponteiro sobre o nó para mostrar a dica. Cada tabela indica o esquema, conforme indicado pela barra vertical no nó. Todos os esquemas na linhagem são classificados em ordem alfabética e recebem uma cor. Assim, as tabelas no mesmo esquema têm as mesmas barras coloridas, e as tabelas em esquemas com nomes semelhantes têm barras coloridas semelhantes.
Cada nó exibe um ícone que indica as propriedades dele:
- monitor: uma visualização, não uma tabela.
- cached: uma tabela que é sempre totalmente atualizada (truncada e depois reescrita). Clique no ícone para ver os scripts adjacentes a essa tabela.
- cached: uma tabela que nem sempre é totalmente atualizada (truncada e depois reescrita). Clique no ícone para ver os scripts adjacentes a esta tabela.
- timer: é uma tabela que teve vida curta. Mantenha o ponteiro sobre o ícone para ver a duração da tabela.
- snowflake: uma tabela que foi gravada pela última vez há mais de sete dias, o que sugere uma tabela com dados estáticos ou gravados com pouca frequência.
Para analisar os objetos no gráfico Fluxo de dados, faça o seguinte:
- Para ver uma lista de colunas de tabela, clique em uma tabela. Essa visualização inclui o nome de cada coluna e o tipo de dados, conforme determinado por um despejo de metadados fornecido ou deduzido do SQL visto nos registros de consulta.
- Para ver o gráfico de linhagem de uma coluna, clique nela. No gráfico de linhagem no nível da coluna, as arestas representam fluxos de dados que afetam a coluna de destino.
Para conferir detalhes sobre uma aresta, clique nela no gráfico. Essa visualização inclui links para os scripts SQL que induziram a borda.
Uma borda é gerada de um nó de origem para um nó de destino quando uma instrução SQL faz referência ao nó de origem enquanto a instrução está computando dados que são inseridos no nó de destino. Normalmente, isso envolve a transferência de dados da origem para o destino, mas a guia Fluxo de dados também mostra uma borda quando o nó de origem é usado em uma cláusula
WHEREouGROUP BYque afeta o destino. Para filtrar apenas as transferências de dados, ative o botão Mostrar arestas que não são de dados na barra de ferramentas.
Guia "Conexões"
A guia Conexões de um nó de linhagem exibe uma lista de nós próximos no gráfico de linhagem. Por padrão, os nós conectados são classificados pela distância do caminho mais curto do nó atual. Os nós que exigem menos arestas para serem alcançados do nó atual são listados primeiro. É possível mudar a classificação com a opção Classificar.
Por padrão, a lista de conexões inclui os nós upstream (produtor) e downstream (consumidor) do nó atual. É possível mudar esse filtro com o controle Tipo. Na coluna Distância, os nós que estão upstream do nó atual são mostrados com uma seta apontando para cima com a distância do caminho de volta mais curto para esse nó a partir do nó atual. Da mesma forma, os nós que estão downstream do nó atual são mostrados com uma seta apontando para baixo com a distância do caminho de ida mais curto para esse nó a partir do nó atual. Um nó pode ser upstream e downstream do nó atual se fizer parte de um ciclo.
Para fazer o download de um arquivo com todos os nós exibidos, clique em fazer o download do CSV.
Guia Usuários
A guia Usuários de um nó mostra os usuários que executaram scripts que leram ou gravaram o nó ou os nós que estão upstream ou downstream dele. Por padrão, o usuário que realizou o maior número de ações separadas é listado primeiro. É possível mudar a classificação com a opção Classificar.
Para fazer o download de um arquivo com todos os usuários exibidos, clique em fazer o download do CSV.
Guia "Pipelines"
A guia Pipelines de um nó mostra os pipelines que executaram scripts que leram ou gravaram o nó ou os nós que estão upstream ou downstream dele. Por padrão, o pipeline que realizou o maior número de ações separadas é listado primeiro. É possível mudar a classificação com a opção Classificar.
Para fazer o download de um arquivo com todos os pipelines exibidos, clique em Fazer o download do CSV.
Guia "Código"
A guia Código de um nó mostra todos os scripts SQL vistos nos arquivos de entrada que leram ou gravaram dados nesse nó. As menções ao nó são destacadas no texto SQL. Clique em um script para abrir o texto completo. É possível mudar as configurações de filtro para filtrar a lista de scripts exibidos.
Para baixar um arquivo com todos os scripts exibidos, clique em baixar CSV.
Analisar a página de borda
Para analisar as arestas de nó no gráfico de linhagem, clique em uma das guias a seguir.
Guia "Detalhes"
A guia Detalhes de uma aresta mostra predicados e categorias, que descrevem as operações realizadas por scripts que induziram a aresta.
Os predicados são anotados como códigos de três partes separados por hífens. A primeira parte
é r, indicando que a origem da aresta é uma relação, ou a,
indicando que a origem da aresta é um atributo. A segunda parte é uma
das seguintes abreviações que indicam como o nó de origem influenciou
os dados no nó de destino:
has: a relação de origem contém o atributo de destino.dat: a origem copia ou transfere dados para o destino.res: a origem filtra ou restringe a cardinalidade do destino em uma cláusula comoWHERE,HAVINGouJOIN ON.grp: a origem é usada em uma cláusulaGROUP BYque afeta o destino.
A terceira parte também é r ou a, indicando se o destino da
borda é uma relação ou um atributo.
As categorias de borda podem incluir:
datpredicados:AGGREGATE: a origem foi usada em um cálculo agregado que gravou o destino.EXACT_COPY: os dados da origem foram copiados integralmente para o destino.FUNCTION: a origem foi usada para calcular o destino.IDENTITY_COPY: o destino não foi calculado. O destino era uma cópia literal da origem sem transmissões ou conversões.PARTITION_PROMOTION: o destino contém dados da origem como resultado da promoção de uma partição da origem para o destino.WEAK_COPY: os dados da origem foram copiados pelo menos parcialmente para o destino.
respredicados:FILTER: a origem foi usada em uma comparação que gravou o destino.KEY: os dados da origem foram usados como uma chave em uma comparação de mesclagem que gravou o destino.
grppredicados:GROUP: os dados da origem foram usados como chave em uma cláusulaGROUP BYque afeta o destino.
Guia "Código"
A guia Código de uma borda mostra os scripts SQL que induziram essa borda. Os nós de origem e de destino da borda são destacados onde são mencionados no texto SQL.
A seguir
- Execute uma avaliação de migração para avaliar a viabilidade e os possíveis benefícios de migrar seu data warehouse para o BigQuery.
- Use o serviço de tradução de SQL, como o tradutor de SQL interativo, a API de tradução e o tradutor de SQL em lote para automatizar a conversão das suas consultas SQL em GoogleSQL, incluindo a personalização de SQL aprimorada pelo Gemini.