このページの一部またはすべての情報は、S3NS の Cloud de Confiance に適用されない場合があります。詳細については、
Google Cloud との違いをご確認ください。
 Google は AI 技術を使用して、コンテンツをご希望の言語に翻訳しています。AI 翻訳には誤りが含まれる場合があります。
事前構築されたデータの前処理コードを使用したモデルのトレーニング: ノートブック
ノートブックを使用してモデルをローカルでトレーニングする、パラメータをログに記録する、トレーニング時系列の指標を Vertex AI TensorBoard に記録する、評価指標を記録する、という流れは、データ サイエンティストにとって一般的なワークフローです。
しかし、社内の他の人が作成したデータ前処理コードを再利用できれば、煩雑なデータ ラングリングを省力化し、標準化できます。そのために、次のことを可能にする必要があります。
- Python データ前処理ライブラリを使用して、ノートブックのメモリ内データセット(Pandas Dataframe)をクリーンアップする。
- Keras を使用してモデルをトレーニングする(ノートブックで再度トレーニングする)。
ノートブック: 前処理済みデータを使用したモデルのテスト
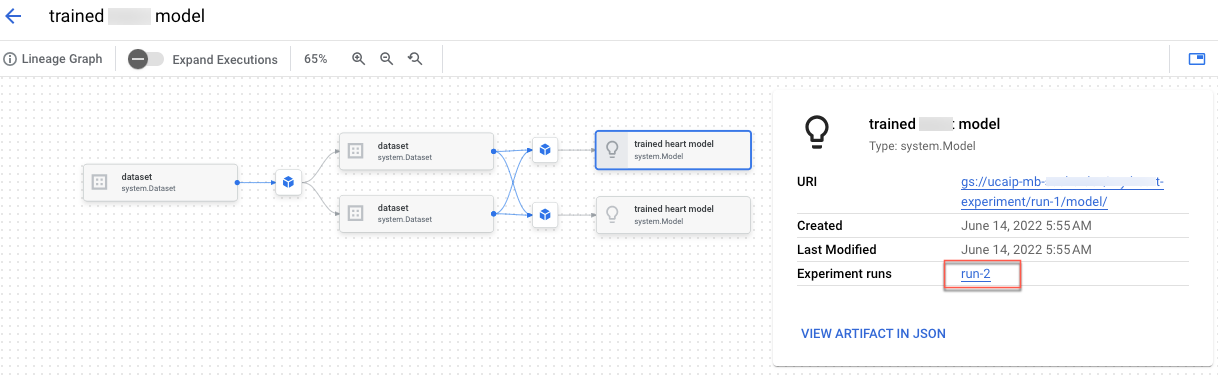
「カスタム トレーニング用の Vertex AI Experiments リネージを作成する」ノートブックでは、Vertex AI Experiments に前処理コードを統合する方法を学習します。また、ML の過程で生成されたメタデータとアーティファクトの記録、分析、デバッグ、監査を行えるテストリネージを構築します。
アーティファクト リネージは、 Cloud de Confiance コンソールで確認できます。
関連性の高いコンテンツ
特に記載のない限り、このページのコンテンツはクリエイティブ・コモンズの表示 4.0 ライセンスにより使用許諾されます。コードサンプルは Apache 2.0 ライセンスにより使用許諾されます。詳しくは、Google Developers サイトのポリシーをご覧ください。Java は Oracle および関連会社の登録商標です。
最終更新日 2026-10-15 UTC。
[[["わかりやすい","easyToUnderstand","thumb-up"],["問題の解決に役立った","solvedMyProblem","thumb-up"],["その他","otherUp","thumb-up"]],[["必要な情報がない","missingTheInformationINeed","thumb-down"],["複雑すぎる / 手順が多すぎる","tooComplicatedTooManySteps","thumb-down"],["最新ではない","outOfDate","thumb-down"],["翻訳に関する問題","translationIssue","thumb-down"],["サンプル / コードに問題がある","samplesCodeIssue","thumb-down"],["その他","otherDown","thumb-down"]],["最終更新日 2026-10-15 UTC。"],[],[]]
