

כברירת מחדל, מודל של Gemini Enterprise Agent Platform נפרס במכונה וירטואלית (VM) משלו. ב-Gemini Enterprise Agent Platform אפשר לארח כמה מודלים באותה מכונה וירטואלית, וליהנות מהיתרונות הבאים:
- שיתוף משאבים בין כמה פריסות.
- פרסום מודלים חסכוני.
- ניצול טוב יותר של הזיכרון ומשאבי המחשוב.
במדריך הזה מוסבר איך לשתף משאבים בין כמה פריסות ב-Gemini Enterprise Agent Platform.
סקירה כללית
התמיכה באירוח משותף של מודלים מציגה את הקונספט של DeploymentResourcePool, שמקבץ פריסות של מודלים שמשתפים משאבים בתוך מכונה וירטואלית אחת. אפשר לפרוס כמה נקודות קצה באותו VM ב-DeploymentResourcePool. לכל נקודת קצה יש מודל אחד או יותר שנפרסו. אפשר לקבץ את המודלים שנפרסו לנקודת קצה (endpoint) מסוימת באותו DeploymentResourcePool או באחר.
בדוגמה הבאה יש ארבעה מודלים ושתי נקודות קצה:
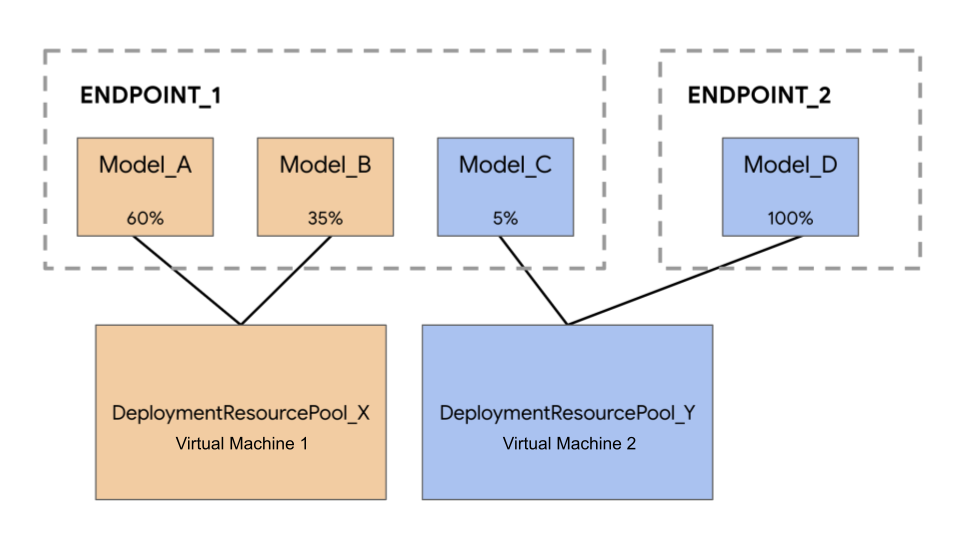
Model_A, Model_B ו-Model_C פרוסים ב-Endpoint_1, והתנועה מנותבת לכולם. Model_D נפרס ב-Endpoint_2, שמקבלת 100% מהתנועה של נקודת הקצה הזו.
במקום להקצות כל מודל למכונה וירטואלית נפרדת, אתם יכולים לקבץ את המודלים באחת מהדרכים הבאות:
- הקבוצות
Model_Aו-Model_Bמשתפות מכונה וירטואלית, ולכן הן חלק מ-DeploymentResourcePool_X. - לקבץ את
Model_Cו-Model_D(שלא נמצאים כרגע באותה נקודת קצה) כדי לשתף מכונה וירטואלית, וכך הם יהפכו לחלק מ-DeploymentResourcePool_Y.
אי אפשר לשתף מכונה וירטואלית בין מאגרי משאבים שונים לפריסה.
לתשומת ליבכם
אין הגבלה על מספר המודלים שאפשר לפרוס במאגר משאבים אחד לפריסה. זה תלוי בצורת ה-VM שנבחרה, בגודלי המודלים ובדפוסי התנועה. אירוח משותף מתאים במיוחד כשיש הרבה מודלים פרוסים עם תנועה דלילה, כך שהקצאת מכונה ייעודית לכל מודל פרוס לא מנצלת את המשאבים בצורה יעילה.
אפשר לפרוס מודלים לאותו מאגר משאבי פריסה בו-זמנית. עם זאת, יש מגבלה של 20 בקשות פריסה בו-זמנית בכל זמן נתון.
מאגר משאבים ריק של פריסה לא צורך את מכסת המשאבים שלכם. המשאבים מוקצים למאגר משאבי פריסה כשהמודל הראשון נפרס, ומשוחררים כשהפריסה של המודל האחרון מבוטלת.
המודלים במאגר משאבים יחיד לפריסה לא מבודדים זה מזה, ויכולים להתחרות על המעבד (CPU) והזיכרון. אם מודל אחד מעבד בקשת הסקה בזמן שמודל אחר מעבד בקשה, הביצועים של אחד מהם עלולים להיות נמוכים יותר.
מגבלות
אלה המגבלות שקיימות כשפורסים מודלים עם שיתוף משאבים:
- התכונה הזו נתמכת רק בהגדרות הבאות:
- פריסות של מודלים ב-TensorFlow שמשתמשות בקונטיינרים מוכנים מראש ל-TensorFlow
- פריסות של מודלים ב-PyTorch שמשתמשות בקונטיינרים מוגדרים מראש ל-PyTorch
- אין תמיכה בקונטיינרים מוגדרים מראש שהוגדרו למסגרות אחרות.
- אין תמיכה בקונטיינרים בהתאמה אישית.
- אפשר להשתמש רק במודלים שעברו אימון בהתאמה אישית ובמודלים מיובאים. אין תמיכה במודלים של AutoML.
- אפשר לפרוס באותו מאגר משאבים לפריסה רק מודלים עם אותו קובץ אימג' של קונטיינר (כולל גרסת ה-framework) של קונטיינרים מוגדרים מראש של Gemini Enterprise Agent Platform להסקת מסקנות ל-TensorFlow או ל-PyTorch.
- אי אפשר להשתמש ב-Vertex Explainable AI.
פריסת מודל
כדי לפרוס מודל ב-DeploymentResourcePool:
- אם צריך, יוצרים מאגר משאבים לפריסה.
- אם צריך, יוצרים נקודת קצה.
- אחזור המזהה של נקודת הקצה.
- פורסים את המודל בנקודת הקצה במאגר המשאבים לפריסה.
יצירת מאגר משאבים לפריסה
אם אתם פורסים מודל ב-DeploymentResourcePool קיים, דלגו על השלב הזה:
משתמשים ב-CreateDeploymentResourcePool כדי ליצור מאגר משאבים.
Cloud Console
נכנסים לדף Deployment Resource Pools של Agent Platform במסוף Cloud de Confiance .
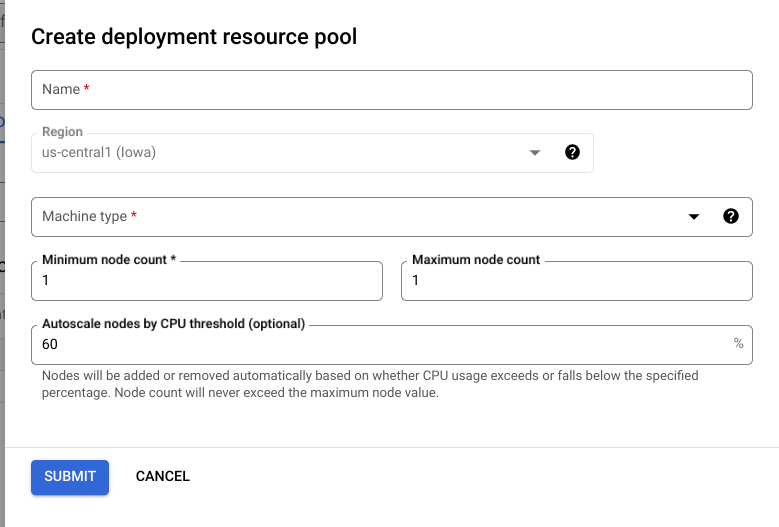
לוחצים על Create וממלאים את הטופס (שמוצג בהמשך).
REST
לפני שמשתמשים בנתוני הבקשה, צריך להחליף את הנתונים הבאים:
- LOCATION_ID: האזור שבו אתם משתמשים ב-Agent Platform.
- PROJECT_ID: מזהה הפרויקט. .
-
MACHINE_TYPE: אופציונלי. משאבי המכונה שמשמשים לכל צומת בפריסה הזו. הגדרת ברירת המחדל היא
n1-standard-2. מידע נוסף על סוגי מכונות - ACCELERATOR_TYPE: סוג המאיץ שרוצים לצרף למכונה. אופציונלי אם לא צוין ACCELERATOR_COUNT או אם הערך שלו הוא אפס. לא מומלץ למודלים של AutoML או למודלים באימון מותאם אישית שמשתמשים בתמונות ללא GPU. מידע נוסף
- ACCELERATOR_COUNT: מספר המאיצים לשימוש בכל רפליקה. זה שינוי אופציונלי. צריך להיות אפס או לא מוגדר במודלים של AutoML או במודלים באימון מותאם אישית שמשתמשים בתמונות ללא GPU.
- MIN_REPLICA_COUNT: המספר המינימלי של הצמתים לפריסה הזו. אפשר להגדיל או להקטין את מספר הצמתים בהתאם לעומס ההסקה, עד למספר המקסימלי של הצמתים, אבל אף פעם לא פחות מהמספר הזה. הערך הזה חייב להיות שווה ל-1 או גדול יותר.
- MAX_REPLICA_COUNT: המספר המקסימלי של הצמתים בפריסה הזו. אפשר להגדיל או להקטין את מספר הצמתים בהתאם לעומס ההסקה, עד למספר הצמתים הזה, ולא פחות ממספר הצמתים המינימלי.
- REQUIRED_REPLICA_COUNT: אופציונלי. מספר הצמתים הנדרש כדי שהפריסה הזו תסומן כפריסה שהושלמה בהצלחה. הערך חייב להיות גדול מ-1 או שווה לו, וקטן ממספר הצמתים המינימלי או שווה לו. אם לא מציינים ערך, ברירת המחדל היא המספר המינימלי של הצמתים.
-
DEPLOYMENT_RESOURCE_POOL_ID: שם ל-
DeploymentResourcePool. האורך המקסימלי הוא 63 תווים, והתווים התקינים הם /^[a-z]([a-z0-9-]{0,61}[a-z0-9])?$/.
ה-method של ה-HTTP וכתובת ה-URL:
POST https://LOCATION_ID-aiplatform.googleapis.com/v1/projects/PROJECT_ID/locations/LOCATION_ID/deploymentResourcePools
תוכן בקשת JSON:
{
  "deploymentResourcePool":{
    "dedicatedResources":{
      "machineSpec":{
        "machineType":"MACHINE_TYPE",
        "acceleratorType":"ACCELERATOR_TYPE",
        "acceleratorCount":"ACCELERATOR_COUNT"
      },
      "minReplicaCount":MIN_REPLICA_COUNT,
      "maxReplicaCount":MAX_REPLICA_COUNT,
      "requiredReplicaCount":REQUIRED_REPLICA_COUNT
    }
  },
  "deploymentResourcePoolId":"DEPLOYMENT_RESOURCE_POOL_ID"
}
כדי לשלוח את הבקשה צריך להרחיב אחת מהאפשרויות הבאות:
אתם אמורים לקבל תגובת JSON שדומה לזו:
{
  "name": "projects/PROJECT_NUMBER/locations/LOCATION_ID/deploymentResourcePools/DEPLOYMENT_RESOURCE_POOL_ID/operations/OPERATION_ID",
  "metadata": {
    "@type": "type.googleapis.com/google.cloud.aiplatform.v1.CreateDeploymentResourcePoolOperationMetadata",
    "genericMetadata": {
      "createTime": "2022-06-15T05:48:06.383592Z",
      "updateTime": "2022-06-15T05:48:06.383592Z"
    }
  }
}
אפשר לדגום את סטטוס הפעולה עד שהתגובה כוללת את "done": true.
Python
# Create a deployment resource pool.
deployment_resource_pool = aiplatform.DeploymentResourcePool.create(
    deployment_resource_pool_id="DEPLOYMENT_RESOURCE_POOL_ID",  # User-specified ID
    machine_type="MACHINE_TYPE",  # Machine type
    min_replica_count=MIN_REPLICA_COUNT,  # Minimum number of replicas
    max_replica_count=MAX_REPLICA_COUNT,  # Maximum number of replicas
)
מחליפים את מה שכתוב בשדות הבאים:
-
DEPLOYMENT_RESOURCE_POOL_ID: שם ל-DeploymentResourcePool. האורך המקסימלי הוא 63 תווים, והתווים החוקיים הם /^[a-z]([a-z0-9-]{0,61}[a-z0-9])?$/. -
MACHINE_TYPE: אופציונלי. משאבי המכונה שמשמשים לכל צומת בפריסה הזו. ערך ברירת המחדל הואn1-standard-2. מידע נוסף על סוגי מכונות -
MIN_REPLICA_COUNT: המספר המינימלי של הצמתים לפריסה הזו. אפשר להגדיל או להקטין את מספר הצמתים בהתאם לעומס ההסקה, עד למספר המקסימלי של הצמתים, אבל לא פחות מהמספר הזה. הערך הזה חייב להיות שווה ל-1 או גדול יותר. -
MAX_REPLICA_COUNT: המספר המקסימלי של הצמתים בפריסה הזו. אפשר להגדיל או להקטין את מספר הצמתים בהתאם לעומס ההסקה, עד למספר הצמתים הזה, ולא פחות ממספר הצמתים המינימלי.
יצירת נקודת קצה (endpoint)
כדי ליצור נקודת קצה, קראו את המאמר יצירת נקודת קצה ציבורית באמצעות ה-CLI של gcloud או Agent Platform API. השלב הזה זהה לפריסה של מודל יחיד.
אחזור של מזהה נקודת הקצה (endpoint)
כדי לאחזר את מזהה נקודת הקצה, קראו את המאמר פריסת מודל באמצעות ה-CLI של gcloud או Agent Platform API. השלב הזה זהה לפריסה של מודל יחיד.
פריסת המודל במאגר משאבים לפריסה
אחרי שיוצרים DeploymentResourcePool ונקודת קצה, אפשר לפרוס באמצעות ה-method DeployModel ב-API. התהליך הזה דומה לפריסה של מודל יחיד. אם יש DeploymentResourcePool, מציינים את shared_resources של DeployModel עם שם המשאב של DeploymentResourcePool שאתם פורסים.
Cloud Console
במסוף Cloud de Confiance , נכנסים לדף מרשם המודלים של Agent Platform.
מוצאים את המודל ולוחצים על Deploy to endpoint.
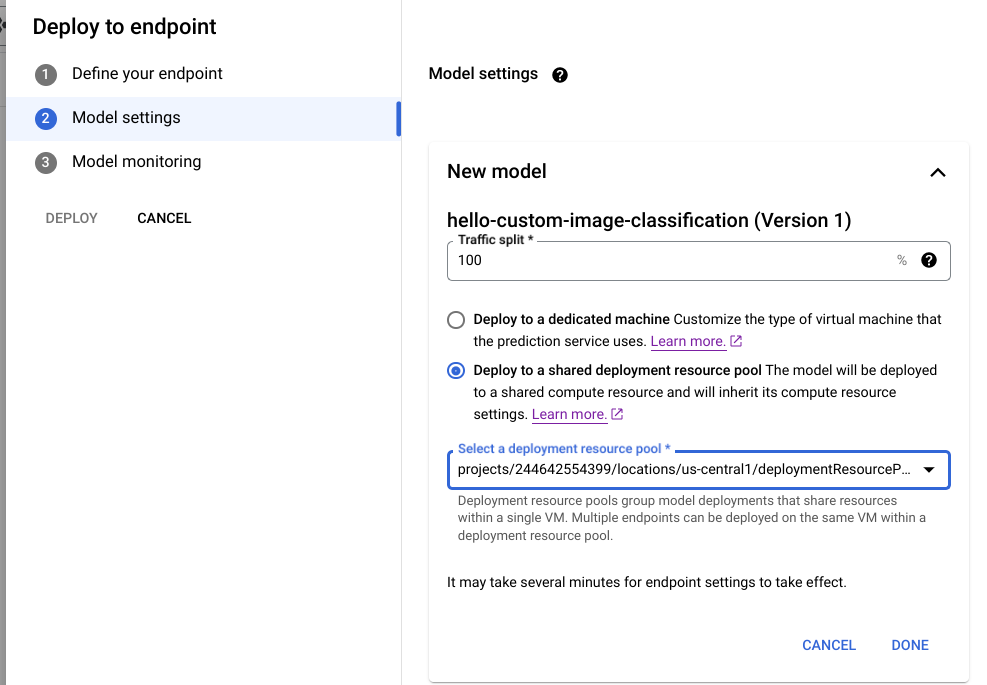
בקטע Model settings (שמוצג למטה), בוחרים באפשרות Deploy to a shared deployment resource pool.
REST
לפני שמשתמשים בנתוני הבקשה, צריך להחליף את הנתונים הבאים:
- LOCATION_ID: האזור שבו אתם משתמשים ב-Agent Platform.
- PROJECT: מזהה הפרויקט. .
- ENDPOINT_ID: המזהה של נקודת הקצה.
- MODEL_ID: המזהה של המודל לפריסה.
-
DEPLOYED_MODEL_NAME: שם ל-
DeployedModel. אפשר להשתמש בשם המוצג שלModelגם בשבילDeployedModel. -
DEPLOYMENT_RESOURCE_POOL_ID: שם ל-
DeploymentResourcePool. האורך המקסימלי הוא 63 תווים, והתווים התקינים הם /^[a-z]([a-z0-9-]{0,61}[a-z0-9])?$/. - TRAFFIC_SPLIT_THIS_MODEL: אחוז תנועת החיזוי לנקודת הקצה הזו שצריך לנתב למודל שנפרס באמצעות הפעולה הזו. ברירת המחדל היא 100. סכום כל אחוזי התנועה צריך להיות 100. מידע נוסף על חלוקת התנועה
- DEPLOYED_MODEL_ID_N: אופציונלי. אם מודלים אחרים נפרסים בנקודת הקצה הזו, צריך לעדכן את אחוזי חלוקת התנועה שלהם כך שכל האחוזים יסתכמו ב-100.
- TRAFFIC_SPLIT_MODEL_N: ערך אחוז חלוקת התנועה של מפתח מזהה המודל שנפרס.
- PROJECT_NUMBER: מספר הפרויקט שנוצר באופן אוטומטי
ה-method של ה-HTTP וכתובת ה-URL:
POST https://LOCATION-aiplatform.googleapis.com/v1/projects/PROJECT/locations/LOCATION/endpoints/ENDPOINT_ID:deployModel
תוכן בקשת JSON:
{
  "deployedModel": {
    "model": "projects/PROJECT/locations/us-central1/models/MODEL_ID",
    "displayName": "DEPLOYED_MODEL_NAME",
    "sharedResources":"projects/PROJECT/locations/us-central1/deploymentResourcePools/DEPLOYMENT_RESOURCE_POOL_ID"
  },
  "trafficSplit": {
    "0": TRAFFIC_SPLIT_THIS_MODEL,
    "DEPLOYED_MODEL_ID_1": TRAFFIC_SPLIT_MODEL_1,
    "DEPLOYED_MODEL_ID_2": TRAFFIC_SPLIT_MODEL_2
  },
}
כדי לשלוח את הבקשה צריך להרחיב אחת מהאפשרויות הבאות:
אתם אמורים לקבל תגובת JSON שדומה לזו:
{
  "name": "projects/PROJECT_NUMBER/locations/LOCATION/endpoints/ENDPOINT_ID/operations/OPERATION_ID",
  "metadata": {
    "@type": "type.googleapis.com/google.cloud.aiplatform.v1.DeployModelOperationMetadata",
    "genericMetadata": {
      "createTime": "2022-06-19T17:53:16.502088Z",
      "updateTime": "2022-06-19T17:53:16.502088Z"
    }
  }
}
Python
# Deploy model in a deployment resource pool.
model = aiplatform.Model("MODEL_ID")
model.deploy(deployment_resource_pool=deployment_resource_pool)
מחליפים את MODEL_ID במזהה של המודל שרוצים לפרוס.
כדי לפרוס כמה מודלים לאותו מאגר משאבים לפריסה, חוזרים על הבקשה הקודמת עם מודלים שונים שיש להם את אותם משאבים משותפים.
קבלת מסקנות
אתם יכולים לשלוח בקשות להסקת מסקנות למודל ב-DeploymentResourcePool, כמו לכל מודל אחר שנפרס ב-Gemini Enterprise Agent Platform.