

Nesta página, explicamos como a Capacidade de Processamento Provisionada funciona, como controlar o excesso ou ignorar a Capacidade de Processamento Provisionada e como monitorar o uso.
Como funciona a capacidade de processamento provisionada
Nesta seção, explicamos como a Capacidade de Processamento Provisionada funciona usando a verificação de cotas durante o período de aplicação de cotas.
Verificação de cota da Capacidade de Processamento Provisionada
A cota máxima de capacidade de processamento provisionada é um múltiplo do número de unidades de escala de IA generativa (GSUs, na sigla em inglês) compradas e da capacidade de processamento por GSU. Ela é verificada sempre que você faz uma solicitação dentro do período de aplicação da cota, que é a frequência com que a cota máxima de Capacidade de Processamento Provisionada é aplicada.
No momento em que uma solicitação é recebida, o tamanho real da resposta é desconhecido. Como priorizamos a velocidade de resposta para aplicativos em tempo real, a Capacidade de Processamento Provisionada estima o tamanho do token de saída. Se a estimativa inicial exceder a cota máxima disponível de capacidade de processamento provisionada, a solicitação será processada como pagamento por uso. Caso contrário, ela será processada como capacidade de processamento provisionada. Para isso, compare a estimativa inicial com a cota máxima da Capacidade de Processamento Provisionada.
Quando a resposta é gerada e o tamanho real do token de saída é conhecido, o uso e a cota reais são reconciliados adicionando a diferença entre a estimativa e o uso real ao valor da cota de Capacidade de Processamento Provisionada disponível.
Janelas de aplicação da cota de capacidade de processamento provisionada
A Agent Platform aplica uma janela dinâmica ao aplicar a cota de capacidade de processamento provisionada para modelos do Gemini. Isso oferece estabilidade ideal para tráfego propenso a picos. Em vez de uma janela fixa, a Agent Platform aplica a cota em uma janela flexível que se ajusta automaticamente, dependendo do tipo de modelo e do número de GSUs que você provisionou. Como resultado, talvez você tenha temporariamente um tráfego priorizado que exceda o valor da cota por segundo em alguns casos. No entanto, não exceda sua cota durante o período da janela. Esses períodos são baseados no horário do relógio interno da plataforma do agente e são independentes de quando as solicitações são feitas.
Como funciona a janela de aplicação de cotas
A janela de aplicação determina o quanto você pode exceder ou "estourar" o limite por segundo antes de ser limitado. Essa janela é aplicada automaticamente. Essas janelas estão sujeitas a mudanças para otimizar o desempenho e a confiabilidade.
Alocações pequenas de GSUs (3 GSUs ou menos): a janela pode variar de 40 a 120 segundos para permitir que solicitações individuais maiores sejam processadas sem interrupção.
Por exemplo, se você comprar 1 GSU de
gemini-2.5-flash, vai receber uma média de 2.690 tokens por segundo de capacidade de processamento contínua. Seu uso total em qualquer período de 120 segundos não pode exceder 322.800 tokens (2.690 tokens por segundo * 120 segundos). Portanto, se você enviar uma solicitação que use 70.000 tokens por segundo, mas o uso total em 120 segundos permanecer abaixo de 322.800 tokens, o pico de 70.000 tokens por segundo ainda será considerado como Capacidade de Processamento Provisionada, já que o uso médio não excede 2.690 tokens por segundo.Alocações de GSU padrão (médias) (mais de 3 GSUs): para implantações de GSU médias (por exemplo, menos de 50 GSUs), a janela pode variar de 5 a 30 segundos. Os limites de GSU e as janelas de contexto variam de acordo com o modelo.
Por exemplo, se você comprar 25 GSUs de
gemini-2.5-flash, vai receber uma média de 67.250 tokens por segundo (2.690 tokens por segundo * 25) de capacidade de processamento contínua. Seu uso total em qualquer período de 30 segundos não pode exceder 2.017.500 tokens (67.250 tokens por segundo * 30 segundos). Portanto, se você enviar uma solicitação que use 1.000.000 de tokens por segundo, mas o uso total em 30 segundos permanecer dentro de 2.017.500 tokens, o pico de 1.000.000 de tokens por segundo ainda será contabilizado como Capacidade de Processamento Provisionada, já que o uso médio não excede 67.250 tokens por segundo.Alocações de GSU de alta precisão (em grande escala): para implantações de GSU em grande escala (por exemplo, 50 GSUs ou mais), a janela pode variar de 1 a 5 segundos para garantir que as solicitações de alta frequência sejam processadas com máxima precisão em toda a infraestrutura.
Por exemplo, se você comprar 250 GSUs de
gemini-2.5-flash, vai receber uma média de 672.500 tokens por segundo (2.690 tokens por segundo * 250) de capacidade de processamento contínua. O uso total em qualquer período de 5 segundos não pode exceder 3.362.500 tokens (672.500 tokens por segundo * 5 segundos). Portanto, se você enviar uma solicitação que use 5.000.000 de tokens por segundo, ela não será processada como Capacidade de Processamento Provisionada, porque o uso total de 5.000.000 de tokens excede o limite de 3.362.500 tokens em uma janela de 5 segundos. Por outro lado, uma solicitação que usa 1.000.000 de tokens por segundo pode ser processada como capacidade de processamento provisionada se o uso médio na janela de 5 segundos não exceder 672.500 tokens por segundo.
Controlar excedentes ou ignorar a capacidade de processamento provisionada
Use a API para controlar excedentes quando você exceder a capacidade de processamento comprada ou para ignorar a capacidade de processamento provisionada por solicitação.
Leia cada opção para determinar o que você precisa fazer para atender ao seu caso de uso.
Comportamento padrão
Se uma solicitação exceder a cota restante de Capacidade de Processamento Provisionada, toda a solicitação será processada como uma solicitação on demand por padrão e será faturada de acordo com a taxa de pagamento por uso. Quando isso ocorre, o tráfego aparece como transbordamento nos painéis de monitoramento. Para mais informações sobre como monitorar o uso da capacidade de processamento provisionada, consulte Monitorar a capacidade de processamento provisionada.
Depois que o pedido de capacidade de processamento provisionada estiver ativo, o comportamento padrão vai ocorrer automaticamente. Não é preciso alterar o código para começar a consumir seu pedido, desde que você o consuma na região provisionada.
Usar apenas a capacidade de processamento provisionada
Se você estiver gerenciando custos evitando cobranças sob demanda, use apenas a capacidade de processamento provisionada. Solicitações que excedem o valor do pedido de capacidade de processamento provisionada retornam com um erro 429.
Ao enviar solicitações para a API, defina o cabeçalho HTTP X-Vertex-AI-LLM-Request-Type como dedicated.
Usar apenas o pagamento por uso
Isso também é chamado de uso sob demanda. As solicitações ignoram a capacidade de processamento provisionada e são enviadas diretamente para o pagamento por uso. Isso pode ser útil para experimentos ou aplicativos que estão em desenvolvimento.
Ao enviar solicitações para a API, defina o cabeçalho HTTP X-Vertex-AI-LLM-Request-Type como shared.
Exemplo
Python
Instalar
pip install --upgrade google-genai
Para saber mais, consulte a documentação de referência do SDK.
Defina variáveis de ambiente para usar o SDK de IA generativa do Google com a Vertex AI:
# Replace the `GOOGLE_CLOUD_PROJECT` and `GOOGLE_CLOUD_LOCATION` values
# with appropriate values for your project.
export GOOGLE_CLOUD_PROJECT=GOOGLE_CLOUD_PROJECT
export GOOGLE_CLOUD_LOCATION=global
export GOOGLE_GENAI_USE_ENTERPRISE=True
Go
Saiba como instalar ou atualizar a Go.
Para saber mais, consulte a documentação de referência do SDK.
Defina variáveis de ambiente para usar o SDK de IA generativa do Google com a Vertex AI:
# Replace the `GOOGLE_CLOUD_PROJECT` and `GOOGLE_CLOUD_LOCATION` values
# with appropriate values for your project.
export GOOGLE_CLOUD_PROJECT=GOOGLE_CLOUD_PROJECT
export GOOGLE_CLOUD_LOCATION=global
export GOOGLE_GENAI_USE_ENTERPRISE=True
Node.js
Instalar
npm install @google/genai
Para saber mais, consulte a documentação de referência do SDK.
Defina variáveis de ambiente para usar o SDK de IA generativa do Google com a Vertex AI:
# Replace the `GOOGLE_CLOUD_PROJECT` and `GOOGLE_CLOUD_LOCATION` values
# with appropriate values for your project.
export GOOGLE_CLOUD_PROJECT=GOOGLE_CLOUD_PROJECT
export GOOGLE_CLOUD_LOCATION=global
export GOOGLE_GENAI_USE_ENTERPRISE=True
Java
Saiba como instalar ou atualizar a Java.
Para saber mais, consulte a documentação de referência do SDK.
Defina variáveis de ambiente para usar o SDK de IA generativa do Google com a Vertex AI:
# Replace the `GOOGLE_CLOUD_PROJECT` and `GOOGLE_CLOUD_LOCATION` values
# with appropriate values for your project.
export GOOGLE_CLOUD_PROJECT=GOOGLE_CLOUD_PROJECT
export GOOGLE_CLOUD_LOCATION=global
export GOOGLE_GENAI_USE_ENTERPRISE=True
REST
curl -X POST \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  -H "X-Vertex-AI-LLM-Request-Type: dedicated" \ # Options: dedicated, shared
  $URL \
  -d '{"contents": [{"role": "user", "parts": [{"text": "Hello."}]}]}'
Usar a capacidade de processamento provisionada com uma chave de API
Se você comprou a Capacidade de Processamento Provisionada para um projeto, modelo do Google e região específicos e quer usá-la para enviar uma solicitação com uma chave de API, inclua o ID do projeto, o modelo, o local e a chave de API como parâmetros na solicitação.
Para saber como criar uma chave de API do Cloud de Confiance by S3NS vinculada a uma conta de serviço, consulte Receber uma chave de API do Cloud de Confiance by S3NS . Para saber como enviar solicitações à API Gemini usando uma chave de API, consulte Conectar-se ao servidor MCP de conhecimento.
Por exemplo, o exemplo a seguir mostra como enviar uma solicitação com uma chave de API ao usar a capacidade de processamento provisionada:
REST
curl \
-X POST \
-H "Content-Type: application/json" \
"https://aiplatform.googleapis.com/v1/projects/PROJECT_ID/locations/LOCATION/publishers/google/models/MODEL_ID:generateContent?key=YOUR_API_KEY" \
-d $'{
  "contents": [
    {
      "role": "user",
      "parts": [
        {
          "text": "Explain how AI works in a few words"
        }
      ]
    }
  ]
}'
Receba notificações por e-mail
É possível receber notificações por e-mail sobre seus pedidos de Capacidade de Processamento Provisionada usando a API Essential Contacts. Depois de ativar, clique em Notificações na parte de cima da página de pedidos de Capacidade de Processamento Provisionada. Em seguida, na caixa de diálogo que aparece, clique em Contatos essenciais e siga as instruções na tela.
-
Ative a API Essential Contacts, se ainda não estiver ativada.
Funções necessárias para ativar APIs
Para ativar APIs, você precisa da permissão
serviceusage.services.enable. Se você criou o projeto, provavelmente já tem essa permissão pelo papel de proprietário (roles/owner). Caso contrário, é possível conseguir essa permissão pelo papel de administrador do Service Usage (roles/serviceusage.serviceUsageAdmin). Saiba como conceder papéis. Acesse a página "Capacidade de processamento provisionada".
Clique em Notificações.
Na caixa de diálogo Notificações, clique em Contatos essenciais.
A página "Contatos essenciais" é aberta.
Clique em Adicionar contato.
Na caixa de diálogo Adicionar um contato, insira o endereço de e-mail do contato nos campos E-mail e Confirmar e-mail.
Selecione Atualizações de produtos.
Clique em Salvar.
O endereço de e-mail para contato é notificado sobre os seguintes eventos de capacidade de processamento provisionada:
| Evento | Quando o contato é notificado |
|---|---|
| Pedido enviado | Em alguns minutos |
| Pedido ativado | Em alguns minutos |
| Atualização do pedido enviada | Em alguns minutos |
| Atualização do pedido ativada | Em alguns minutos |
| Validade do pedido de 1 mês, 3 meses ou 1 ano | Duas semanas antes da data de validade |
| O pedido expira em 1 semana. | 3 dias antes da data de validade |
| Renovação automática de 1 mês, 3 meses ou 1 ano | Duas semanas antes da data de renovação automática |
Monitorar a capacidade de processamento provisionada
É possível monitorar o uso da capacidade de processamento provisionada usando um conjunto
de métricas que são medidas no tipo de recurso
aiplatform.googleapis.com/PublisherModel.
O monitoramento de tráfego da Capacidade de Processamento Provisionada é um recurso de pré-lançamento público.
Dimensões
É possível filtrar as métricas usando as seguintes dimensões:
| Dimensão | Valores |
|---|---|
type |
inputoutput |
request_type |
|
Prefixo do caminho
O prefixo do caminho de uma métrica é
aiplatform.googleapis.com/publisher/online_serving.
Por exemplo, o caminho completo da métrica /consumed_throughput é
aiplatform.googleapis.com/publisher/online_serving/consumed_throughput.
Métricas
As seguintes métricas do Cloud Monitoring estão disponíveis no recurso aiplatform.googleapis.com/PublisherModel para os modelos do Gemini. Use os tipos de solicitação dedicated para filtrar o uso da capacidade de processamento provisionada.
| Métrica | Nome de exibição | Descrição |
|---|---|---|
/dedicated_gsu_limit |
Limite (GSU) | Limite dedicado em GSUs. Use essa métrica para entender sua cota máxima de capacidade de processamento provisionada em GSUs. |
/tokens |
Tokens | Distribuição da contagem de tokens de entrada e saída. |
/token_count |
Contagem de tokens | Contagem acumulada de tokens de entrada e saída. |
/consumed_token_throughput |
Capacidade de processamento de tokens | Uso da capacidade de processamento, que considera a taxa de burndown em tokens e incorpora a reconciliação de cotas. Consulte Verificação de cota da capacidade de processamento provisionada. Use essa métrica para entender como sua cota da capacidade de processamento provisionada foi usada. |
/dedicated_token_limit |
Limite (tokens por segundo) | Limite dedicado em tokens por segundo. Use essa métrica para entender sua cota máxima de capacidade de processamento provisionada para modelos baseados em tokens. |
/characters |
Caracteres | Distribuição de contagem de caracteres de entrada e saída. |
/character_count |
Contagem de caracteres | Contagem de caracteres de entrada e saída acumulados. |
/consumed_throughput |
Capacidade de processamento de caracteres | Uso da capacidade de processamento, que considera a taxa de burndown em caracteres e incorpora a reconciliação de cotas Verificação de cotas da capacidade de processamento provisionada. Use essa métrica para entender como sua cota de capacidade de processamento provisionada foi usada. Para modelos baseados em tokens, essa métrica equivale à capacidade consumida em tokens multiplicada por 4. |
/dedicated_character_limit |
Limite (caracteres por segundo) | Limite dedicado em caracteres por segundo. Use essa métrica para entender sua cota máxima de capacidade de processamento provisionada para modelos baseados em caracteres. |
/model_invocation_count |
Contagem de invocações de modelo | Número de invocações de modelo (solicitações de previsão). |
/model_invocation_latencies |
Latências de invocação de modelo | Latências de invocação de modelo (latências de previsão). |
/first_token_latencies |
Latências do primeiro token | Duração da solicitação recebida até o primeiro token retornado. |
Os modelos da Anthropic também têm um filtro para capacidade de processamento provisionada, mas
apenas para tokens e token_count.
Painéis
Os painéis de monitoramento padrão da Capacidade de Processamento Provisionada oferecem métricas que permitem entender melhor o uso e a utilização da Capacidade de Processamento Provisionada. Para acessar os painéis, faça o seguinte:
No console do Cloud de Confiance , acesse a página Capacidade de Processamento Provisionada.
Para conferir o uso da capacidade de processamento provisionada de cada modelo nos seus pedidos, selecione a guia Resumo de uso.
Na tabela Utilização da capacidade de processamento provisionada por modelo, é possível conferir o seguinte para o período selecionado:
Número total de GSUs que você tinha.
Uso máximo da capacidade de processamento em termos de GSUs.
A utilização média de GSU.
O número de vezes que você atingiu o limite de capacidade de processamento provisionada.
Selecione um modelo na tabela Uso da capacidade de processamento provisionada por modelo para ver mais métricas específicas do modelo selecionado.
Como interpretar painéis de monitoramento
A Capacidade de Processamento Provisionada verifica a cota disponível em tempo real no nível de milissegundos para as solicitações conforme elas são feitas, mas compara esses dados com um período de aplicação de cota contínuo, com base no horário do relógio interno da plataforma de agentes. Essa comparação é independente do momento em que as solicitações são feitas. Os painéis de monitoramento informam as métricas de uso após a reconciliação da cota. No entanto, essas métricas são agregadas para fornecer médias para períodos de alinhamento do painel, com base no período selecionado. A menor granularidade possível que os painéis de monitoramento aceitam é no nível de minuto. Além disso, o horário dos painéis de monitoramento é diferente do horário da Agent Platform.
Essas diferenças de tempo podem, ocasionalmente, resultar em discrepâncias entre os dados nos painéis de monitoramento e o desempenho em tempo real. Isso pode ocorrer por um dos seguintes motivos:
A cota é aplicada em tempo real, mas os gráficos de monitoramento agregam dados em períodos de alinhamento de painel de média de um minuto ou mais, dependendo do período especificado nos painéis de monitoramento.
A plataforma de agentes e os painéis de monitoramento são executados em relógios de sistema diferentes.
Durante um segundo, se um pico de tráfego exceder sua cota de capacidade de processamento provisionada com base na janela de aplicação, toda a solicitação será processada como tráfego excedente. No entanto, a utilização geral da Capacidade de Processamento Provisionada pode parecer baixa quando os dados de monitoramento desse segundo são calculados como média no período de alinhamento de 1 minuto, porque a utilização média em todo o período de alinhamento pode não exceder 100%. Se você notar tráfego excedente, isso confirma que sua cota de Capacidade de Processamento Provisionada foi totalmente utilizada durante o período de aplicação da cota em que essas solicitações específicas foram feitas. Isso ocorre independentemente da utilização média mostrada nos painéis de monitoramento.
Exemplo de possível discrepância nos dados de monitoramento
Este exemplo ilustra algumas das discrepâncias resultantes do desalinhamento de janelas. A Figura 1 representa o uso da capacidade de processamento em um período específico. Nesta figura:
As barras azuis representam o tráfego admitido como Capacidade de Processamento Provisionada.
A barra laranja representa o tráfego que ultrapassa o limite de GSU e é processado como transbordamento.
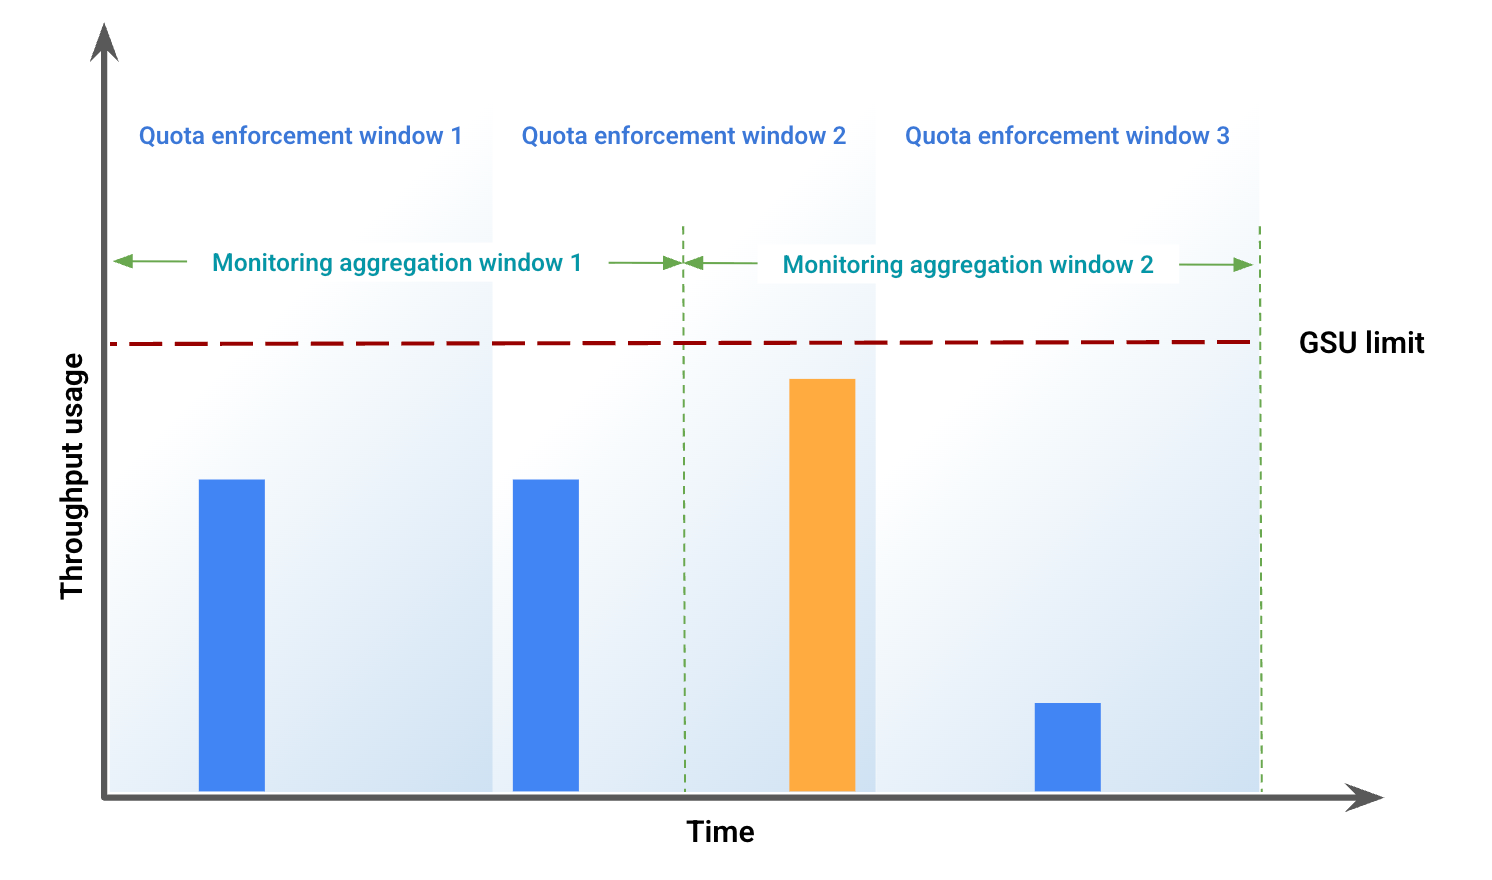
Com base no uso da capacidade de processamento, a Figura 2 representa possíveis discrepâncias visuais devido ao desalinhamento de janelas. Nesta figura:
A linha azul representa o tráfego da Capacidade de Processamento Provisionada.
A linha laranja representa o tráfego excedente.
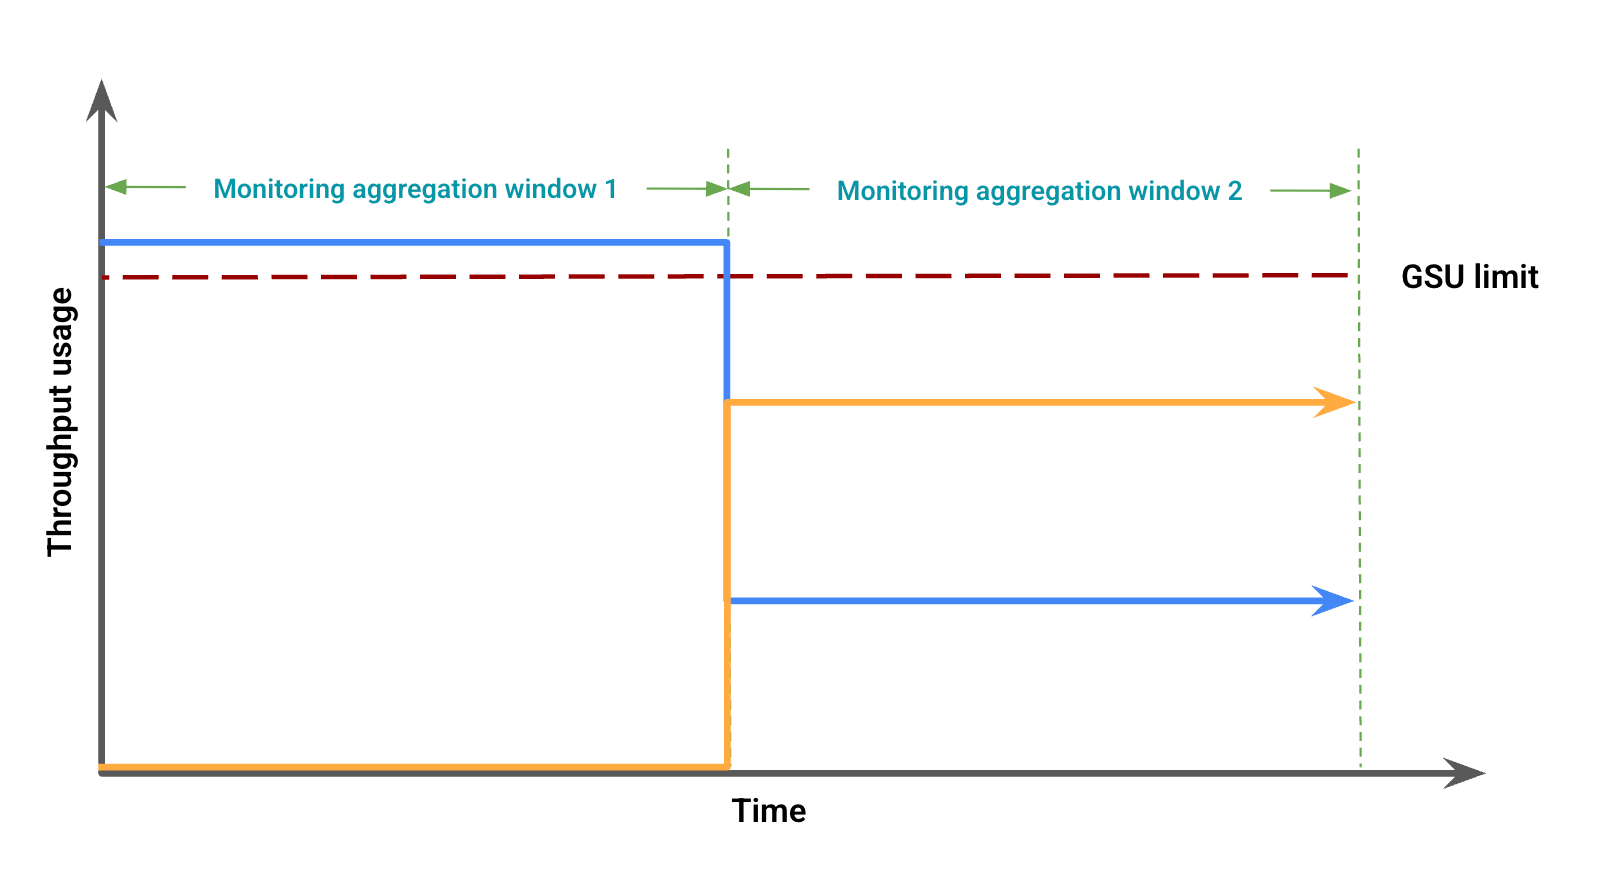
Nesse caso, os dados de monitoramento podem mostrar o uso da Capacidade de Processamento Provisionada sem transbordamento em um período de agregação de monitoramento, enquanto observam simultaneamente o uso da Capacidade de Processamento Provisionada abaixo do limite de GSU coincidindo com um transbordamento em outro período de agregação de monitoramento.
Resolver problemas em painéis de monitoramento
Para resolver problemas de transbordamento inesperado nos painéis ou erros 429, siga estas etapas:
Ampliar: defina o período do painel como 12 horas ou menos para fornecer o período de alinhamento mais granular de 1 minuto. Períodos grandes suavizam picos que causam limitação e aumentam as médias do período de alinhamento.
Verifique o tráfego total: os painéis específicos do modelo mostram o tráfego dedicado e o excedente como duas linhas separadas, o que pode levar à conclusão incorreta de que a cota de capacidade de processamento provisionada não está sendo totalmente utilizada e está transbordando prematuramente. Se o tráfego exceder a cota disponível, toda a solicitação será processada como spillover. Para outra visualização útil, adicione uma consulta ao painel usando o Metrics Explorer e inclua a capacidade de processamento de tokens para o modelo e a região específicos. Não inclua outras agregações ou filtros para ver o tráfego total em todos os tipos de tráfego (dedicado, excedente e compartilhado).
Monitorar modelos da Genmedia
O monitoramento da capacidade de processamento provisionada não está disponível nos modelos do Veo.
Alertas
Depois de ativar os alertas, defina alertas padrão para ajudar a gerenciar o uso do tráfego.
Ativar alertas
Para ativar os alertas no painel, faça o seguinte:
No console do Cloud de Confiance , acesse a página Capacidade de Processamento Provisionada.
Para conferir o uso da capacidade de processamento provisionada de cada modelo nos seus pedidos, selecione a guia Resumo de uso.
Selecione Alertas recomendados para ver os seguintes alertas:
Provisioned Throughput Usage Reached LimitProvisioned Throughput Utilization Exceeded 80%Provisioned Throughput Utilization Exceeded 90%
Verifique os alertas que ajudam a gerenciar o tráfego.
Ver mais detalhes do alerta
Para ver mais informações sobre os alertas, faça o seguinte:
Acesse a página Integrações.
Digite Agent Platform no campo Filtro e pressione Enter. A Plataforma de Agentes do Google é exibida.
Para mais informações, clique em Ver detalhes. O painel Detalhes da plataforma de agentes do Google é exibido.
Selecione a guia Alertas e escolha um modelo de Política de alertas.
A seguir
- Resolva o código do erro
429.