

本頁說明佈建輸送量的運作方式、如何控管超額用量或略過佈建輸送量,以及如何監控用量。
佈建輸送量的運作方式
本節說明佈建輸送量的運作方式,包括配額檢查和配額強制執行期間。
佈建輸送量配額檢查
佈建輸送量配額上限是購買的生成式 AI 擴充單元 (GSU) 數量,乘以每個 GSU 的輸送量。每次在配額強制執行期間提出要求時,系統都會檢查這項配額。配額強制執行期間是指強制執行佈建輸送量配額上限的頻率。
收到要求時,系統無法得知實際的回應大小。由於我們優先考量即時應用程式的回應速度,因此佈建輸送量會估算輸出詞元大小。如果初始預估值超過可用的佈建輸送量配額上限,系統會以即付即用模式處理要求,否則會以佈建輸送量模式處理。方法是比較初始預估值和佈建輸送量配額上限。
生成回覆並得知實際輸出詞元數量後,系統會將預估用量與實際用量的差額,加到可用的佈建輸送量配額,藉此調整實際用量和配額。
佈建輸送量配額強制執行時間
Agent Platform 會套用動態視窗,同時強制執行 Gemini 模型的佈建輸送量配額。這可為容易出現尖峰的流量提供最佳穩定性。Agent Platform 不會採用固定時間範圍,而是根據模型類型和您佈建的 GSU 數量,自動調整配額時間範圍。因此,在某些情況下,您可能會暫時遇到每秒優先流量超過配額的情況。不過,您在時間範圍內不得超過配額。這些期間是根據 Agent Platform 內部時鐘時間計算,與提出要求的時間無關。
配額強制執行時間範圍的運作方式
強制執行時間範圍會決定您在受到節流限制之前,可以超過每秒限制的程度或「爆發」程度。系統會自動套用這個時間範圍。請注意,這些時間範圍可能會有所變動,以盡可能提高效能和可靠性。
小型 GSU 分配 (3 個 GSU 以下):時間範圍可介於 40 到 120 秒之間,以便處理較大的個別要求,而不會中斷。
舉例來說,如果您購買 1 個
gemini-2.5-flash的 GSU,平均每秒可獲得 2,690 個詞元的持續處理量。在任何 120 秒的時間範圍內,總用量不得超過 322,800 個詞元 (每秒 2,690 個詞元 * 120 秒)。因此,如果您傳送的要求每秒使用 70,000 個詞元,但 120 秒內的總用量仍低於 322,800 個詞元,則每秒 70,000 個詞元的突發用量仍會計入佈建輸送量,因為平均用量並未超過每秒 2,690 個詞元。標準 (中型) GSU 分配 (超過 3 個 GSU):如果是中型 GSU 部署作業 (例如少於 50 個 GSU),時間範圍可以介於 5 秒到 30 秒之間。GSU 門檻和脈絡窗口會因模型而異。
舉例來說,如果您購買 25 個
gemini-2.5-flash的 GSU,平均每秒可獲得 67,250 個詞元 (每秒 2,690 個詞元 * 25) 的連續處理量。任何 30 秒內的總用量不得超過 2,017,500 個詞元 (每秒 67,250 個詞元 * 30 秒)。因此,如果您傳送的要求每秒使用 1,000,000 個詞元,但 30 秒內的總用量仍不超過 2,017,500 個詞元,則每秒 1,000,000 個詞元的突發用量仍會計入佈建輸送量,因為平均用量並未超過每秒 67,250 個詞元。高精確度 (大規模) GSU 分配:對於大規模 GSU 部署 (例如 50 個以上 GSU),時間範圍可介於 1 到 5 秒之間,確保整個基礎架構能以最高精確度處理高頻率要求。
舉例來說,如果您購買 250 個
gemini-2.5-flash的 GSU,平均每秒可獲得 672,500 個詞元 (每秒 2,690 個詞元 * 250) 的連續處理量。在任何 5 秒的時間範圍內,總用量不得超過 3,362,500 個詞元 (每秒 672,500 個詞元 * 5 秒)。因此,如果您傳送的要求每秒使用 5,000,000 個詞元,系統就不會以佈建輸送量處理,因為 5,000,000 個詞元的總用量超過 5 秒內 3,362,500 個詞元的限制。另一方面,如果每秒使用 1,000,000 個詞元的要求,在 5 秒時間範圍內的平均用量不超過每秒 672,500 個詞元,則可做為佈建輸送量處理。
控管超額用量或略過佈建輸送量
使用 API 控制超出購買處理量的用量,或依要求略過佈建輸送量。
請詳閱每個選項,判斷必須採取哪些行動才能滿足您的用途。
預設行為
如果要求超出剩餘的佈建輸送量配額,系統預設會將整個要求視為隨選要求處理,並按即付即用費率計費。發生這種情況時,流量會在監控資訊主頁中顯示為「溢出」。如要進一步瞭解如何監控佈建輸送量用量,請參閱「監控佈建輸送量」。
佈建輸送量訂單生效後,系統會自動執行預設行為。只要在佈建的區域使用訂單,就不必變更程式碼,即可開始使用訂單。
僅使用佈建輸送量
如要避免隨選費用,請只使用佈建輸送量。如果要求超出佈建輸送量訂單數量,則會傳回錯誤 429。
向 API 傳送要求時,請將 X-Vertex-AI-LLM-Request-Type HTTP 標頭設為 dedicated。
僅使用即付即用
這也稱為使用隨選。要求會略過佈建輸送量訂單,直接傳送至即付即用。這項功能適用於實驗或開發中的應用程式。
向 API 傳送要求時,請將 X-Vertex-AI-LLM-Request-Type HTTP 標頭設為 shared。
範例
Python
安裝
pip install --upgrade google-genai
詳情請參閱 SDK 參考文件。
設定環境變數,以便透過 Vertex AI 使用 Google Gen AI SDK:
# Replace the `GOOGLE_CLOUD_PROJECT` and `GOOGLE_CLOUD_LOCATION` values
# with appropriate values for your project.
export GOOGLE_CLOUD_PROJECT=GOOGLE_CLOUD_PROJECT
export GOOGLE_CLOUD_LOCATION=global
export GOOGLE_GENAI_USE_ENTERPRISE=True
Go
詳情請參閱 SDK 參考文件。
設定環境變數,以便透過 Vertex AI 使用 Google Gen AI SDK:
# Replace the `GOOGLE_CLOUD_PROJECT` and `GOOGLE_CLOUD_LOCATION` values
# with appropriate values for your project.
export GOOGLE_CLOUD_PROJECT=GOOGLE_CLOUD_PROJECT
export GOOGLE_CLOUD_LOCATION=global
export GOOGLE_GENAI_USE_ENTERPRISE=True
Node.js
安裝
npm install @google/genai
詳情請參閱 SDK 參考文件。
設定環境變數,以便透過 Vertex AI 使用 Google Gen AI SDK:
# Replace the `GOOGLE_CLOUD_PROJECT` and `GOOGLE_CLOUD_LOCATION` values
# with appropriate values for your project.
export GOOGLE_CLOUD_PROJECT=GOOGLE_CLOUD_PROJECT
export GOOGLE_CLOUD_LOCATION=global
export GOOGLE_GENAI_USE_ENTERPRISE=True
Java
詳情請參閱 SDK 參考文件。
設定環境變數,以便透過 Vertex AI 使用 Google Gen AI SDK:
# Replace the `GOOGLE_CLOUD_PROJECT` and `GOOGLE_CLOUD_LOCATION` values
# with appropriate values for your project.
export GOOGLE_CLOUD_PROJECT=GOOGLE_CLOUD_PROJECT
export GOOGLE_CLOUD_LOCATION=global
export GOOGLE_GENAI_USE_ENTERPRISE=True
REST
curl -X POST \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  -H "X-Vertex-AI-LLM-Request-Type: dedicated" \ # Options: dedicated, shared
  $URL \
  -d '{"contents": [{"role": "user", "parts": [{"text": "Hello."}]}]}'
搭配使用佈建輸送量和 API 金鑰
如果您已為特定專案、Google 模型和區域購買佈建輸送量,並想使用該輸送量透過 API 金鑰傳送要求,則必須在要求中加入專案 ID、模型、位置和 API 金鑰做為參數。
如要瞭解如何建立繫結至服務帳戶的 Cloud de Confiance by S3NS API 金鑰,請參閱「取得 Cloud de Confiance by S3NS API 金鑰」。如要瞭解如何使用 API 金鑰傳送要求至 Gemini API,請參閱「連線至 Knowledge MCP 伺服器」。
舉例來說,下列範例說明如何在使用佈建輸送量時,提交含有 API 金鑰的要求:
REST
curl \
-X POST \
-H "Content-Type: application/json" \
"https://aiplatform.googleapis.com/v1/projects/PROJECT_ID/locations/LOCATION/publishers/google/models/MODEL_ID:generateContent?key=YOUR_API_KEY" \
-d $'{
  "contents": [
    {
      "role": "user",
      "parts": [
        {
          "text": "Explain how AI works in a few words"
        }
      ]
    }
  ]
}'
接收電子郵件通知
您可以使用 Essential Contacts API,接收佈建輸送量訂單的電子郵件通知。啟用後,請按一下「佈建輸送量訂單」頁面頂端的「通知」。接著,在開啟的對話方塊中,按一下「重要聯絡人」,然後按照畫面上的指示操作。
-
啟用 Essential Contacts API (如果尚未啟用)。
啟用 API 所需的角色
您必須具備
serviceusage.services.enable權限,才能啟用 API。如果您建立了專案,可能已透過「擁有者」角色 (roles/owner) 取得這項權限。否則,您可以透過「Service Usage 管理員」角色 (roles/serviceusage.serviceUsageAdmin) 取得這項權限。瞭解如何授予角色。 前往「佈建輸送量」頁面。
按一下 [通知]。
在「Notifications」(通知) 對話方塊中,按一下「Essential contacts」(重要聯絡人)。
「重要聯絡人」頁面隨即開啟。
按一下「新增聯絡人」。
在「Add a contact」(新增聯絡人) 對話方塊中,將聯絡人的電子郵件地址輸入「Email」(電子郵件) 和「Confirm email」(確認電子郵件地址) 欄位。
選取「產品更新」。
按一下 [儲存]。
發生下列佈建輸送量事件時,系統會通知聯絡電子郵件地址:
| 事件 | 聯絡人收到通知時 |
|---|---|
| 訂單已提交 | 幾分鐘內 |
| 訂單已啟用 | 幾分鐘內 |
| 已提交訂單更新 | 幾分鐘內 |
| 訂單更新已生效 | 幾分鐘內 |
| 1 個月、3 個月或 1 年 | 到期日前 2 週 |
| 訂單效期為 1 週。 | 到期日前 3 天 |
| 1 個月、3 個月或 1 年自動續訂 | 自動續訂日期前 2 週 |
監控佈建輸送量
您可以根據 aiplatform.googleapis.com/PublisherModel 資源類型的一組指標,自行監控佈建輸送量用量。
佈建輸送量流量監控功能目前為公開預先發布版。
維度
您可以使用下列維度篩選指標:
| 維度 | 值 |
|---|---|
type |
inputoutput |
request_type |
|
路徑前置字串
指標的路徑前置字串為 aiplatform.googleapis.com/publisher/online_serving。
舉例來說,/consumed_throughput 指標的完整路徑為 aiplatform.googleapis.com/publisher/online_serving/consumed_throughput。
指標
Gemini 模型的 aiplatform.googleapis.com/PublisherModel 資源提供下列 Cloud Monitoring 指標。使用 dedicated 要求類型,篩選佈建輸送量用量。
| 指標 | 顯示名稱 | 說明 |
|---|---|---|
/dedicated_gsu_limit |
限制 (GSU) | 專屬限制 (以 GSU 為單位)。這項指標可讓您瞭解佈建輸送量配額上限 (以 GSU 為單位)。 |
/tokens |
權杖 | 輸入和輸出詞元數量分布。 |
/token_count |
符記數量 | 累積的輸入和輸出詞元數量。 |
/consumed_token_throughput |
詞元處理量 | 處理量用量,會考量詞元消耗率,並納入配額調節。請參閱「佈建輸送量配額檢查」。 這項指標可協助您瞭解佈建輸送量配額的使用情形。 |
/dedicated_token_limit |
上限 (每秒詞元數) | 每秒詞元數的專屬限制。這項指標可讓您瞭解詞元型模型的佈建輸送量配額上限。 |
/characters |
字元 | 輸入和輸出字元數分布。 |
/character_count |
字元數 | 累積的輸入和輸出字元數。 |
/consumed_throughput |
字元處理量 | 處理量用量:以字元為單位計算消耗率,並納入配額調節佈建輸送量配額檢查。 這項指標可用來瞭解佈建輸送量配額的使用情形。 如果是以詞元為基礎的模型,這項指標相當於以詞元計算的處理量乘以 4。 |
/dedicated_character_limit |
上限 (每秒字元數) | 每秒字元數的專屬限制。這項指標可用來瞭解字元型模型的佈建輸送量配額上限。 |
/model_invocation_count |
模型叫用次數 | 模型叫用 (預測要求) 次數。 |
/model_invocation_latencies |
模型叫用延遲時間 | 模型叫用延遲時間 (預測延遲時間)。 |
/first_token_latencies |
首個權杖延遲時間 | 從收到要求到傳回第一個詞元的時間長度。 |
Anthropic 模型也有佈建輸送量篩選器,但僅適用於 tokens 和 token_count。
資訊主頁
佈建輸送量的預設監控資訊主頁提供指標,可讓您進一步瞭解用量和佈建輸送量使用率。如要存取資訊主頁,請按照下列步驟操作:
前往 Cloud de Confiance 控制台的「Provisioned Throughput」(佈建輸送量) 頁面。
如要查看訂單中各模型的佈建輸送量使用率,請選取「Utilization summary」(使用率摘要) 分頁標籤。
在「Provisioned Throughput utilization by model」(各模型的佈建輸送量使用情形) 表格中,您可以查看所選日期範圍內的下列資訊:
您擁有的 GSU 總數。
以 GSU 表示的處理量尖峰用量。
平均 GSU 使用率。
達到佈建輸送量上限的次數。
從「Provisioned Throughput utilization by model」(依模型顯示的佈建輸送量使用率) 表格中選取模型,即可查看所選模型的更多指標。
如何解讀監控資訊主頁
佈建輸送量會以毫秒為單位,即時檢查可用配額,但會根據 Agent Platform 內部時鐘時間,將這項資料與滾動式配額強制執行期間進行比較。這項比較與提出要求的時間無關。監控資訊主頁會在配額協調後回報用量指標。不過,系統會根據所選日期範圍,匯總這些指標,提供資訊主頁校正週期的平均值。監控資訊主頁支援的最低精細程度為分鐘。此外,監控資訊主頁的時間與 Agent Platform 不同。
這些時間差異有時可能會導致監控資訊主頁中的資料與即時效能不一致。可能原因如下:
配額會即時強制執行,但監控圖表會將資料匯總至 1 分鐘或更長的平均資訊主頁校正週期,具體取決於監控資訊主頁中指定的日期範圍。
Agent Platform 和監控資訊主頁在不同的系統時鐘上執行。
在一秒內,如果流量突增,超過強制執行時間範圍內的佈建輸送量配額,整個要求就會視為溢出流量處理。不過,如果將該秒的監控資料在 1 分鐘的校正週期內平均計算,整體佈建輸送量使用率可能會偏低,因為整個校正週期的平均使用率可能不會超過 100%。如果看到溢出流量,代表在提出這些特定要求的配額強制執行期間,佈建輸送量配額已用盡。無論監控資訊主頁顯示的平均使用率為何,都是如此。
監控資料可能不一致的範例
這個範例說明瞭因時間範圍不一致而導致的部分差異。圖 1 顯示特定時間範圍內的輸送量用量。圖中:
藍色長條代表佈建輸送量允許的流量。
橘色長條代表用量超過 GSU 限制的流量,會以溢出流量處理。
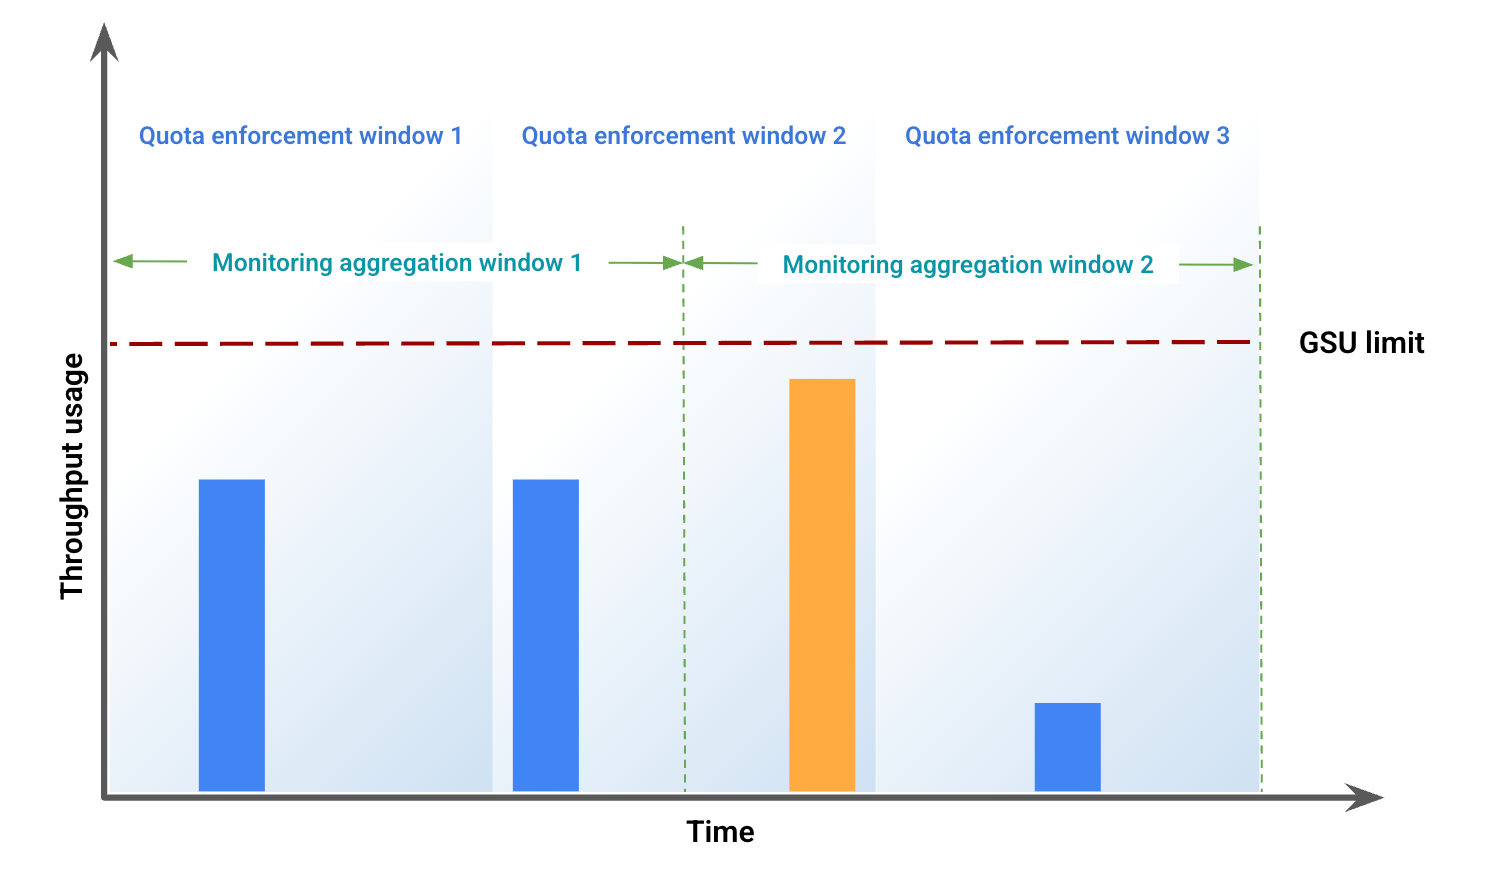
圖 2 根據處理量用量,呈現因視窗不一致而可能出現的視覺差異。圖中:
藍線代表佈建輸送量流量。
橘色線代表溢出流量。
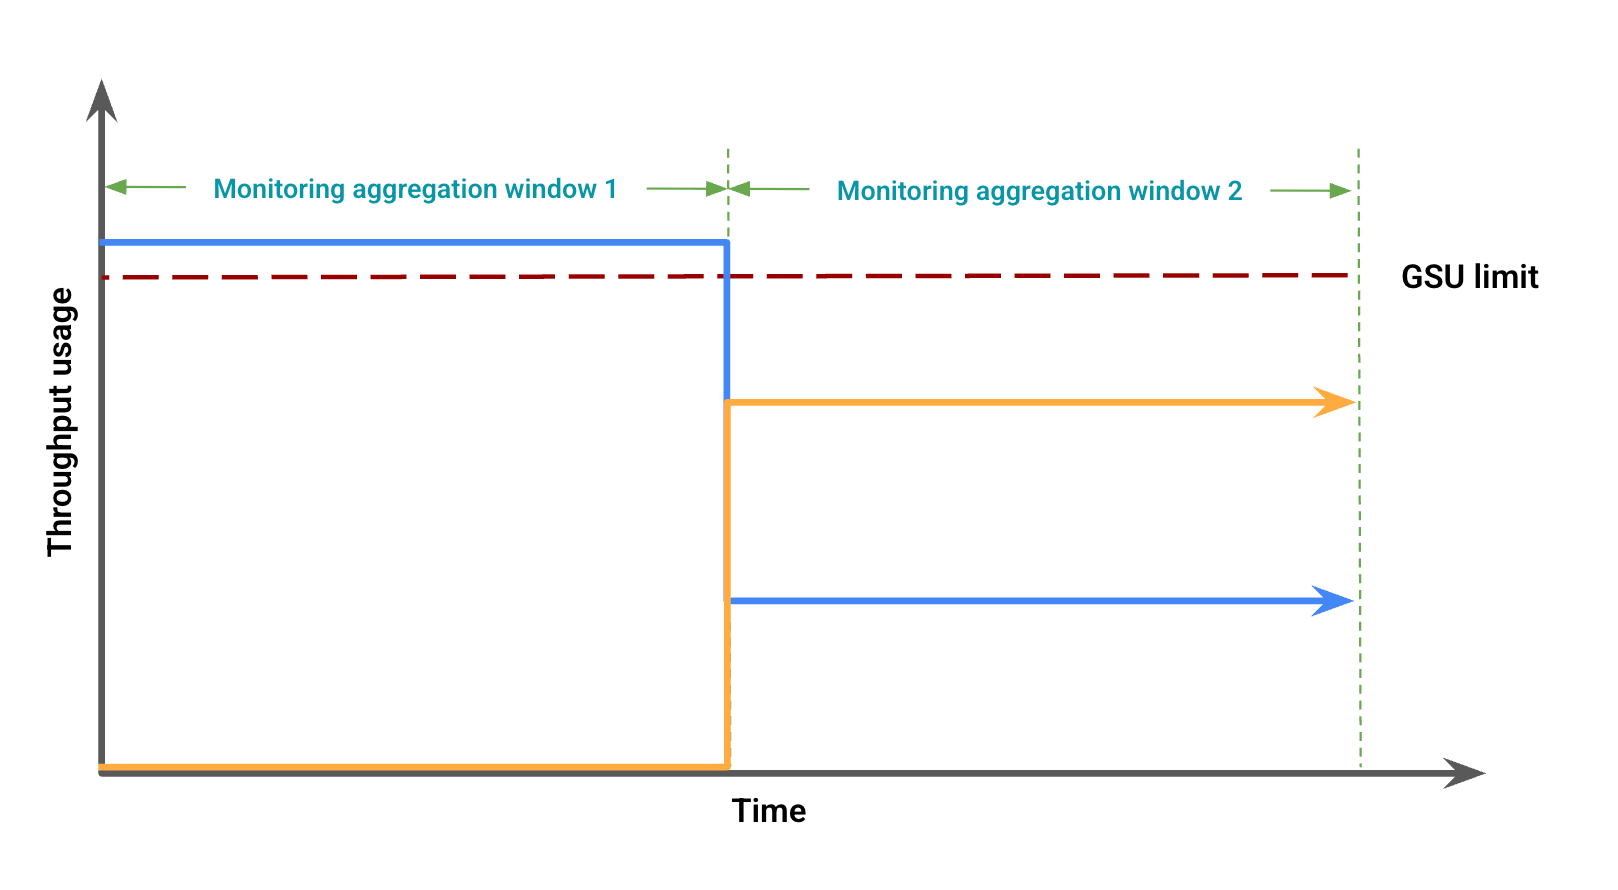
在這種情況下,監控資料可能會顯示佈建輸送量用量,但在監控匯總時間範圍內沒有溢出,同時觀察到佈建輸送量用量低於 GSU 限制,且在另一個監控匯總時間範圍內溢出。
疑難排解監控資訊主頁問題
如要排解資訊主頁中非預期的溢出問題或 429 錯誤,請按照下列步驟操作:
放大:將資訊主頁日期範圍設為 12 小時或更短,即可提供最精細的 1 分鐘校正週期。較大的時間範圍可平滑造成節流的尖峰,並提高對齊週期平均值。
查看總流量:模型專屬資訊主頁會將專用流量和溢出流量顯示為兩條不同的線,這可能會導致您誤以為佈建輸送量配額未充分利用,且過早溢出。如果流量超過可用配額,整個要求會視為溢出流量處理。如要查看其他實用的圖表,請使用 Metrics Explorer 在資訊主頁中新增查詢,並加入特定模型和區域的權杖處理量。請勿加入任何額外的匯總或篩選條件,以便查看所有流量類型 (專屬、溢出和共用) 的總流量。
監控 Genmedia 模型
Veo 模型不支援佈建輸送量監控功能。
警告
啟用快訊後,請設定預設快訊,協助管理流量用量。
啟用警告
如要在資訊主頁中啟用快訊,請按照下列步驟操作:
前往 Cloud de Confiance 控制台的「Provisioned Throughput」(佈建輸送量) 頁面。
如要查看訂單中各模型的佈建輸送量使用率,請選取「Utilization summary」(使用率摘要) 分頁標籤。
選取「建議快訊」,系統會顯示下列快訊:
Provisioned Throughput Usage Reached LimitProvisioned Throughput Utilization Exceeded 80%Provisioned Throughput Utilization Exceeded 90%
查看有助於管理流量的快訊。
查看更多快訊詳細資料
如要查看快訊的詳細資訊,請按照下列步驟操作:
前往「Integrations」(整合) 頁面。
在「篩選器」欄位中輸入 Agent Platform,然後按下 Enter 鍵。Google Agent Platform 隨即顯示。
如要查看更多資訊,請按一下「查看詳細資料」。系統隨即會顯示「Google Agent Platform details」(Google Agent Platform 詳細資料) 窗格。
選取「警告」分頁標籤,然後選取「警告政策」範本。
後續步驟
- 排解錯誤代碼
429。