

En esta página, se explica cómo funciona la capacidad de procesamiento aprovisionada, cómo controlar los excedentes o cómo omitirla, y cómo supervisar el uso.
Cómo funciona la capacidad de procesamiento aprovisionada
En esta sección, se explica cómo funciona la capacidad de procesamiento aprovisionada con la verificación de cuotas durante el período de aplicación de la cuota.
Verificación de la cuota de capacidad de procesamiento aprovisionada
Tu cuota máxima de capacidad de procesamiento aprovisionada es un múltiplo de la cantidad de unidades de escalamiento de IA generativa (GSU) compradas y la capacidad de procesamiento por GSU. Se verifica cada vez que realizas una solicitud dentro de tu período de aplicación de la cuota, que es la frecuencia con la que se aplica la cuota máxima de capacidad de procesamiento aprovisionada.
En el momento en que se recibe una solicitud, se desconoce el tamaño real de la respuesta. Debido a que priorizamos la velocidad de respuesta para las aplicaciones en tiempo real, la capacidad de procesamiento aprovisionada estima el tamaño del token de salida. Si la estimación inicial supera la cuota máxima disponible de capacidad de procesamiento aprovisionada, la solicitud se procesa como pago por uso. De lo contrario, se procesa como capacidad de procesamiento aprovisionada. Para ello, se compara la estimación inicial con tu cuota máxima de capacidad de procesamiento aprovisionada.
Cuando se genera la respuesta y se conoce el tamaño real del token de salida, el uso y la cuota reales se concilian agregando la diferencia entre el uso estimado y el real al importe de la cuota de capacidad de procesamiento aprovisionada disponible.
Períodos de aplicación de cuotas de capacidad de procesamiento aprovisionada
Agent Platform aplica una ventana dinámica mientras aplica la cuota de capacidad de procesamiento aprovisionada para los modelos de Gemini. Esto proporciona una estabilidad óptima para el tráfico propenso a picos. En lugar de una ventana fija, Agent Platform aplica la cuota en una ventana flexible que se ajusta automáticamente, según el tipo de modelo y la cantidad de GSU que hayas aprovisionado. Como resultado, es posible que, en algunos casos, experimentes de forma temporal un tráfico priorizado que supere el importe de tu cuota por segundo. Sin embargo, no debes exceder tu cuota durante la duración de la ventana. Estos períodos se basan en la hora del reloj interno de Agent Platform y son independientes de cuándo se realizan las solicitudes.
Cómo funciona la ventana de aplicación de cuotas
La ventana de aplicación de medidas por incumplimiento determina cuánto puedes exceder, o "ampliar", por encima de tu límite por segundo, antes de que se limite. Esta ventana se aplica automáticamente. Ten en cuenta que estas ventanas están sujetas a cambios para optimizar el rendimiento y la confiabilidad.
Asignaciones de GSU pequeñas (3 GSU o menos): La ventana puede variar de 40 a 120 segundos para permitir que se procesen solicitudes individuales más grandes sin interrupciones.
Por ejemplo, si compras 1 GSU de
gemini-2.5-flash, obtienes un promedio de 2,690 tokens por segundo de capacidad de procesamiento continua. Tu uso total durante cualquier período de 120 segundos no puede superar los 322,800 tokens (2,690 tokens por segundo * 120 segundos). Por lo tanto, si envías una solicitud que usa 70,000 tokens por segundo, pero el uso total durante 120 segundos se mantiene por debajo de 322,800 tokens, la ráfaga de 70,000 tokens por segundo se sigue contando como capacidad de procesamiento aprovisionada, ya que el uso promedio no supera los 2,690 tokens por segundo.Asignaciones de GSU estándar (tamaño mediano) (más de 3 GSU): Para implementaciones de GSU de tamaño mediano (por ejemplo, menos de 50 GSU), la ventana puede variar de 5 a 30 segundos. Los umbrales de GSU y las ventanas de contexto varían según el modelo.
Por ejemplo, si compras 25 GSU de
gemini-2.5-flash, obtienes un promedio de 67,250 tokens por segundo (2,690 tokens por segundo * 25) de capacidad de procesamiento continua. Tu uso total durante cualquier período de 30 segundos no puede superar los 2,017,500 tokens (67,250 tokens por segundo * 30 segundos). Por lo tanto, si envías una solicitud que usa 1,000,000 de tokens por segundo, pero el uso total durante 30 segundos permanece dentro de los 2,017,500 tokens, la ráfaga de 1,000,000 de tokens por segundo aún se cuenta como capacidad de procesamiento aprovisionada, ya que el uso promedio no supera los 67,250 tokens por segundo.Asignaciones de GSU de alta precisión (a gran escala): Para las implementaciones de GSU a gran escala (por ejemplo, 50 GSU o más), la ventana puede variar de 1 a 5 segundos para garantizar que las solicitudes de alta frecuencia se procesen con la máxima precisión en toda la infraestructura.
Por ejemplo, si compras 250 GSU de
gemini-2.5-flash, obtienes un promedio de 672,500 tokens por segundo (2,690 tokens por segundo * 250) de capacidad de procesamiento continua. Tu uso total durante cualquier período de 5 segundos no puede superar los 3,362,500 tokens (672,500 tokens por segundo * 5 segundos). Por lo tanto, si envías una solicitud que usa 5,000,000 de tokens por segundo, no se procesará como capacidad de procesamiento aprovisionada, ya que el uso total de 5,000,000 de tokens supera el límite de 3,362,500 tokens en un período de 5 segundos. Por otro lado, una solicitud que usa 1,000,000 de tokens por segundo se puede procesar como capacidad de procesamiento aprovisionada si el uso promedio durante la ventana de 5 segundos no supera los 672,500 tokens por segundo.
Controla los excedentes o evita la capacidad de procesamiento aprovisionada
Usa la API para controlar los excedentes cuando superes la capacidad de procesamiento que compraste o para omitir la capacidad de procesamiento aprovisionada por solicitud.
Lee cada opción para determinar qué debes hacer para cumplir con tu caso de uso.
Comportamiento predeterminado
Si una solicitud supera la cuota de Capacidad de procesamiento aprovisionada restante, toda la solicitud se procesa como una solicitud a pedido de forma predeterminada y se factura con la tarifa de pago por uso. Cuando esto sucede, el tráfico aparece como desbordamiento en los paneles de supervisión. Para obtener más información sobre cómo supervisar el uso de la capacidad de procesamiento aprovisionada, consulta Supervisa la capacidad de procesamiento aprovisionada.
Una vez que se activa tu pedido de capacidad de procesamiento aprovisionada, el comportamiento predeterminado se produce automáticamente. No es necesario que cambies tu código para comenzar a consumir tu pedido, siempre y cuando lo consumas en la región aprovisionada.
Usa solo la capacidad de procesamiento aprovisionada
Si administras los costos evitando los cargos a pedido, usa solo la capacidad de procesamiento aprovisionada. Las solicitudes que superan el importe del pedido de capacidad de procesamiento aprovisionada devuelven un error 429.
Cuando envíes solicitudes a la API, configura el encabezado HTTP X-Vertex-AI-LLM-Request-Type como dedicated.
Usa solo el pago por uso
Esto también se conoce como uso on demand. Las solicitudes omiten el pedido de capacidad de procesamiento aprovisionada y se envían directamente al pago por uso. Esto puede ser útil para experimentos o aplicaciones que están en desarrollo.
Cuando envíes solicitudes a la API, establece el encabezado HTTP X-Vertex-AI-LLM-Request-Type en shared.
Ejemplo
Python
Instalar
pip install --upgrade google-genai
Para obtener más información, consulta la documentación de referencia del SDK.
Establece variables de entorno para usar el SDK de IA generativa de Google con Vertex AI:
# Replace the `GOOGLE_CLOUD_PROJECT` and `GOOGLE_CLOUD_LOCATION` values
# with appropriate values for your project.
export GOOGLE_CLOUD_PROJECT=GOOGLE_CLOUD_PROJECT
export GOOGLE_CLOUD_LOCATION=global
export GOOGLE_GENAI_USE_ENTERPRISE=True
Go
Obtén información para instalar o actualizar el Go.
Para obtener más información, consulta la documentación de referencia del SDK.
Establece variables de entorno para usar el SDK de IA generativa de Google con Vertex AI:
# Replace the `GOOGLE_CLOUD_PROJECT` and `GOOGLE_CLOUD_LOCATION` values
# with appropriate values for your project.
export GOOGLE_CLOUD_PROJECT=GOOGLE_CLOUD_PROJECT
export GOOGLE_CLOUD_LOCATION=global
export GOOGLE_GENAI_USE_ENTERPRISE=True
Node.js
Instalar
npm install @google/genai
Para obtener más información, consulta la documentación de referencia del SDK.
Establece variables de entorno para usar el SDK de IA generativa de Google con Vertex AI:
# Replace the `GOOGLE_CLOUD_PROJECT` and `GOOGLE_CLOUD_LOCATION` values
# with appropriate values for your project.
export GOOGLE_CLOUD_PROJECT=GOOGLE_CLOUD_PROJECT
export GOOGLE_CLOUD_LOCATION=global
export GOOGLE_GENAI_USE_ENTERPRISE=True
Java
Obtén información para instalar o actualizar el Java.
Para obtener más información, consulta la documentación de referencia del SDK.
Establece variables de entorno para usar el SDK de IA generativa de Google con Vertex AI:
# Replace the `GOOGLE_CLOUD_PROJECT` and `GOOGLE_CLOUD_LOCATION` values
# with appropriate values for your project.
export GOOGLE_CLOUD_PROJECT=GOOGLE_CLOUD_PROJECT
export GOOGLE_CLOUD_LOCATION=global
export GOOGLE_GENAI_USE_ENTERPRISE=True
REST
curl -X POST \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  -H "X-Vertex-AI-LLM-Request-Type: dedicated" \ # Options: dedicated, shared
  $URL \
  -d '{"contents": [{"role": "user", "parts": [{"text": "Hello."}]}]}'
Usa la capacidad de procesamiento aprovisionada con una clave de API
Si compraste la capacidad de procesamiento aprovisionada para un proyecto, un modelo de Google y una región específicos, y quieres usarla para enviar una solicitud con una clave de API, debes incluir el ID del proyecto, el modelo, la ubicación y la clave de API como parámetros en tu solicitud.
Para obtener información sobre cómo crear una clave de API de Cloud de Confiance by S3NS vinculada a una cuenta de servicio, consulta Obtén una clave de API de Cloud de Confiance by S3NS . Para aprender a enviar solicitudes a la API de Gemini con una clave de API, consulta Conéctate al servidor de MCP de Knowledge.
Por ejemplo, en la siguiente muestra, se indica cómo enviar una solicitud con una clave de API mientras se usa la capacidad de procesamiento aprovisionada:
REST
curl \
-X POST \
-H "Content-Type: application/json" \
"https://aiplatform.googleapis.com/v1/projects/PROJECT_ID/locations/LOCATION/publishers/google/models/MODEL_ID:generateContent?key=YOUR_API_KEY" \
-d $'{
  "contents": [
    {
      "role": "user",
      "parts": [
        {
          "text": "Explain how AI works in a few words"
        }
      ]
    }
  ]
}'
Recibe notificaciones por correo electrónico
Puedes recibir notificaciones por correo electrónico sobre tus pedidos de Capacidad de procesamiento aprovisionada con la API de Essential Contacts. Después de habilitar, haz clic en Notificaciones en la parte superior de la página Pedidos de capacidad de procesamiento aprovisionada. Luego, en el diálogo que se abre, haz clic en Contactos esenciales y sigue las instrucciones en pantalla.
-
Habilita la API de Contactos esenciales si aún no está habilitada.
Roles necesarios para habilitar las APIs
Para habilitar las APIs, necesitas el permiso
serviceusage.services.enable. Si creaste el proyecto, es probable que ya tengas este permiso a través del rol de propietario (roles/owner). De lo contrario, puedes obtenerlo a través del rol de administrador de Service Usage (roles/serviceusage.serviceUsageAdmin). Obtén información para otorgar roles. Ve a la página Capacidad de procesamiento aprovisionada.
Haga clic en Notificaciones.
En el cuadro de diálogo Notificaciones, haz clic en Contactos esenciales.
Se abrirá la página Contactos esenciales.
Haz clic en Agregar contacto.
En el cuadro de diálogo Agregar un contacto, ingresa la dirección de correo electrónico del contacto en los campos Correo electrónico y Confirmar correo electrónico.
Selecciona Actualizaciones de productos.
Haz clic en Guardar.
Se notifica a la dirección de correo electrónico de contacto sobre los siguientes eventos de capacidad de procesamiento aprovisionada:
| Evento | Cuándo se notifica al contacto |
|---|---|
| Pedido enviado | En cuestión de minutos |
| Se activó el pedido | En cuestión de minutos |
| Se envió la actualización del pedido | En cuestión de minutos |
| Se activó la actualización del pedido | En cuestión de minutos |
| Vencimiento de pedidos de 1 mes, 3 meses o 1 año | 2 semanas antes de la fecha de vencimiento |
| Vencimiento del pedido en 1 semana | 3 días antes de la fecha de vencimiento |
| Renovación automática de 1 mes, 3 meses o 1 año | 2 semanas antes de la fecha de renovación automática |
Supervisa la capacidad de procesamiento aprovisionada
Puedes supervisar tu uso de la capacidad de procesamiento aprovisionada con un conjunto
de métricas que se miden en el tipo de recurso
aiplatform.googleapis.com/PublisherModel.
La supervisión del tráfico de la capacidad de procesamiento aprovisionada es una función de versión preliminar pública.
Dimensiones
Puedes filtrar las métricas con las siguientes dimensiones:
| Dimensión | Valores |
|---|---|
type |
inputoutput |
request_type |
|
Prefijo de ruta de acceso
El prefijo de la ruta de acceso para una métrica es
aiplatform.googleapis.com/publisher/online_serving.
Por ejemplo, la ruta de acceso completa para la métrica /consumed_throughput es
aiplatform.googleapis.com/publisher/online_serving/consumed_throughput.
Métricas
Las siguientes métricas de Cloud Monitoring están disponibles en el
recurso aiplatform.googleapis.com/PublisherModel para los
modelos de Gemini. Usa los tipos de solicitud dedicated para filtrar el uso de la capacidad de procesamiento aprovisionada.
| Métrica | Nombre visible | Descripción |
|---|---|---|
/dedicated_gsu_limit |
Límite (GSU) | Es el límite dedicado en GSU. Usa esta métrica para comprender tu cuota máxima de capacidad de procesamiento aprovisionada en GSU. |
/tokens |
Tokens | Distribución del recuento de tokens de entrada y salida. |
/token_count |
Recuento de tokens | Cantidad acumulada de tokens de entrada y salida. |
/consumed_token_throughput |
Capacidad de procesamiento de tokens | Uso de la capacidad de procesamiento, que considera la tasa de consumo en tokens y, además, incorpora la conciliación de cuotas. Consulta Verificación de la cuota de capacidad de procesamiento aprovisionada. Usa esta métrica para comprender cómo se usó tu cuota de capacidad de procesamiento aprovisionada. |
/dedicated_token_limit |
Límite (tokens por segundo) | Límite dedicado en tokens por segundo. Usa esta métrica para comprender tu cuota máxima de capacidad de procesamiento aprovisionada para los modelos basados en tokens. |
/characters |
Caracteres | Distribución del recuento de caracteres de entrada y salida. |
/character_count |
Recuento de caracteres | Es el recuento acumulado de caracteres de entrada y salida. |
/consumed_throughput |
Capacidad de procesamiento de caracteres | Uso de la capacidad de procesamiento, que considera la tasa de consumo en caracteres y, además, incorpora la conciliación de cuotas Verificación de la cuota de capacidad de procesamiento aprovisionada. Usa esta métrica para comprender cómo se usó tu cuota de capacidad de procesamiento aprovisionada. En el caso de los modelos basados en tokens, esta métrica equivale a la capacidad de procesamiento consumida en tokens multiplicada por 4. |
/dedicated_character_limit |
Límite (caracteres por segundo) | Es el límite dedicado en caracteres por segundo. Usa esta métrica para comprender tu cuota máxima de capacidad de procesamiento aprovisionada para los modelos basados en caracteres. |
/model_invocation_count |
Recuento de invocaciones de modelos | Cantidad de invocaciones de modelos (solicitudes de predicción). |
/model_invocation_latencies |
Latencias de invocación de modelos | Latencias de invocación del modelo (latencia de predicción) |
/first_token_latencies |
Latencias del primer token | Es la duración desde que se recibe la solicitud hasta que se muestra el primer token. |
Los modelos de Anthropic también tienen un filtro para la capacidad de procesamiento aprovisionada, pero
solo para tokens y token_count.
Paneles
Los paneles de supervisión predeterminados para la capacidad de procesamiento aprovisionada proporcionan métricas que te permiten comprender mejor tu uso y la utilización de la capacidad de procesamiento aprovisionada. Para acceder a los paneles, haz lo siguiente:
En la consola de Cloud de Confiance , ve a la página Capacidad de procesamiento aprovisionada.
Para ver el uso de la capacidad de procesamiento aprovisionada de cada modelo en tus pedidos, selecciona la pestaña Resumen de uso.
En la tabla Uso de la capacidad de procesamiento aprovisionada por modelo, puedes ver lo siguiente para el período seleccionado:
Cantidad total de GSU que tenías.
Uso máximo de la capacidad de procesamiento en términos de GSU.
Es el uso promedio de GSU.
La cantidad de veces que alcanzaste el límite de capacidad de procesamiento aprovisionada.
Selecciona un modelo de la tabla Uso de la capacidad de procesamiento aprovisionada por modelo para ver más métricas específicas del modelo seleccionado.
Cómo interpretar los paneles de supervisión
La capacidad de procesamiento aprovisionada verifica la cuota disponible en tiempo real a nivel de milisegundos para las solicitudes a medida que se realizan, pero compara estos datos con un período de aplicación de cuota móvil, según la hora del reloj interno de Agent Platform. Esta comparación es independiente del momento en que se realizan las solicitudes. Los paneles de supervisión informan las métricas de uso después de que se realiza la conciliación de cuotas. Sin embargo, estas métricas se agregan para proporcionar promedios de los períodos de alineación del panel, según el intervalo de tiempo seleccionado. El nivel de detalle más bajo posible que admiten los paneles de supervisión es el nivel de minutos. Además, la hora de los paneles de supervisión es diferente de la de Agent Platform.
Estas diferencias en los tiempos pueden generar, en ocasiones, discrepancias entre los datos de los paneles de supervisión y el rendimiento en tiempo real. Esto puede deberse a cualquiera de los siguientes motivos:
La cuota se aplica en tiempo real, pero los gráficos de supervisión agregan datos en períodos de alineación del panel de 1 minuto o más, según el intervalo de tiempo especificado en los paneles de supervisión.
Agent Platform y los paneles de supervisión se ejecutan en diferentes relojes del sistema.
Durante un período de un segundo, si un aumento repentino de tráfico supera tu cuota de capacidad de procesamiento aprovisionada según la ventana de aplicación de política, toda la solicitud se procesa como tráfico de desbordamiento. Sin embargo, el uso general de la capacidad de procesamiento aprovisionada puede parecer bajo cuando los datos de supervisión de ese segundo se promedian dentro del período de alineación de 1 minuto, ya que el uso promedio en todo el período de alineación puede no superar el 100%. Si ves tráfico de desbordamiento, se confirma que tu cuota de Capacidad de procesamiento aprovisionada se utilizó por completo durante el período de aplicación de la cuota cuando se realizaron esas solicitudes específicas. Esto es independiente del uso promedio que se muestra en los paneles de supervisión.
Ejemplo de una posible discrepancia en los datos de supervisión
En este ejemplo, se ilustran algunas de las discrepancias que se producen por la desalineación de las ventanas. En la Figura 1, se representa el uso de la capacidad de procesamiento durante un período específico. En esta figura, se muestra lo siguiente:
Las barras azules representan el tráfico admitido como capacidad de procesamiento aprovisionada.
La barra naranja representa el tráfico que supera el límite de GSU y se procesa como desbordamiento.
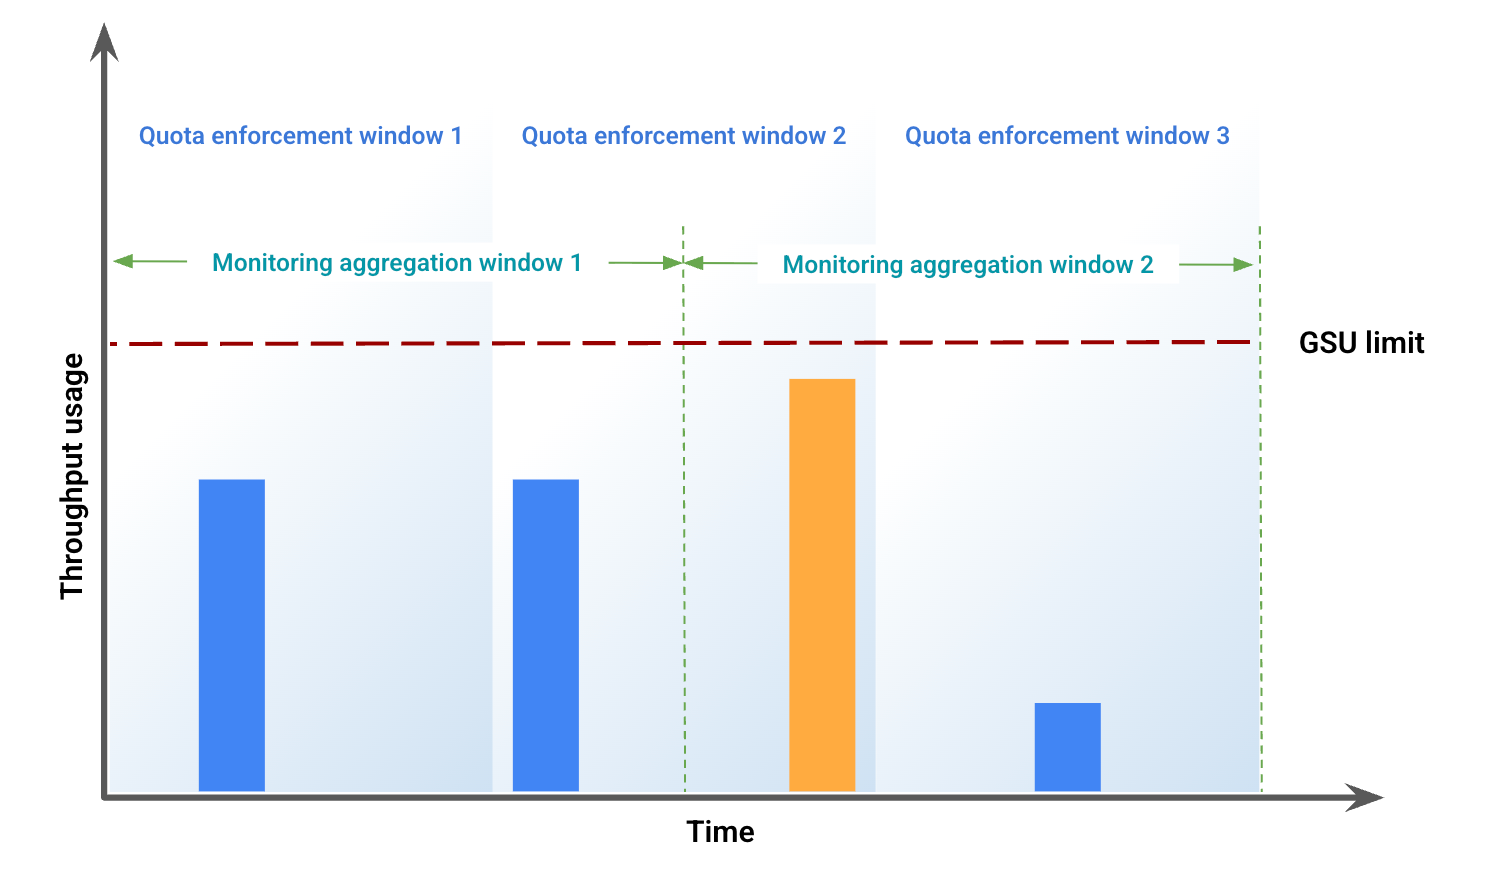
Según el uso de la capacidad de procesamiento, la figura 2 representa posibles discrepancias visuales debido a la desalineación de las ventanas. En esta figura, se muestra lo siguiente:
La línea azul representa el tráfico de capacidad de procesamiento aprovisionada.
La línea naranja representa el tráfico de desbordamiento.
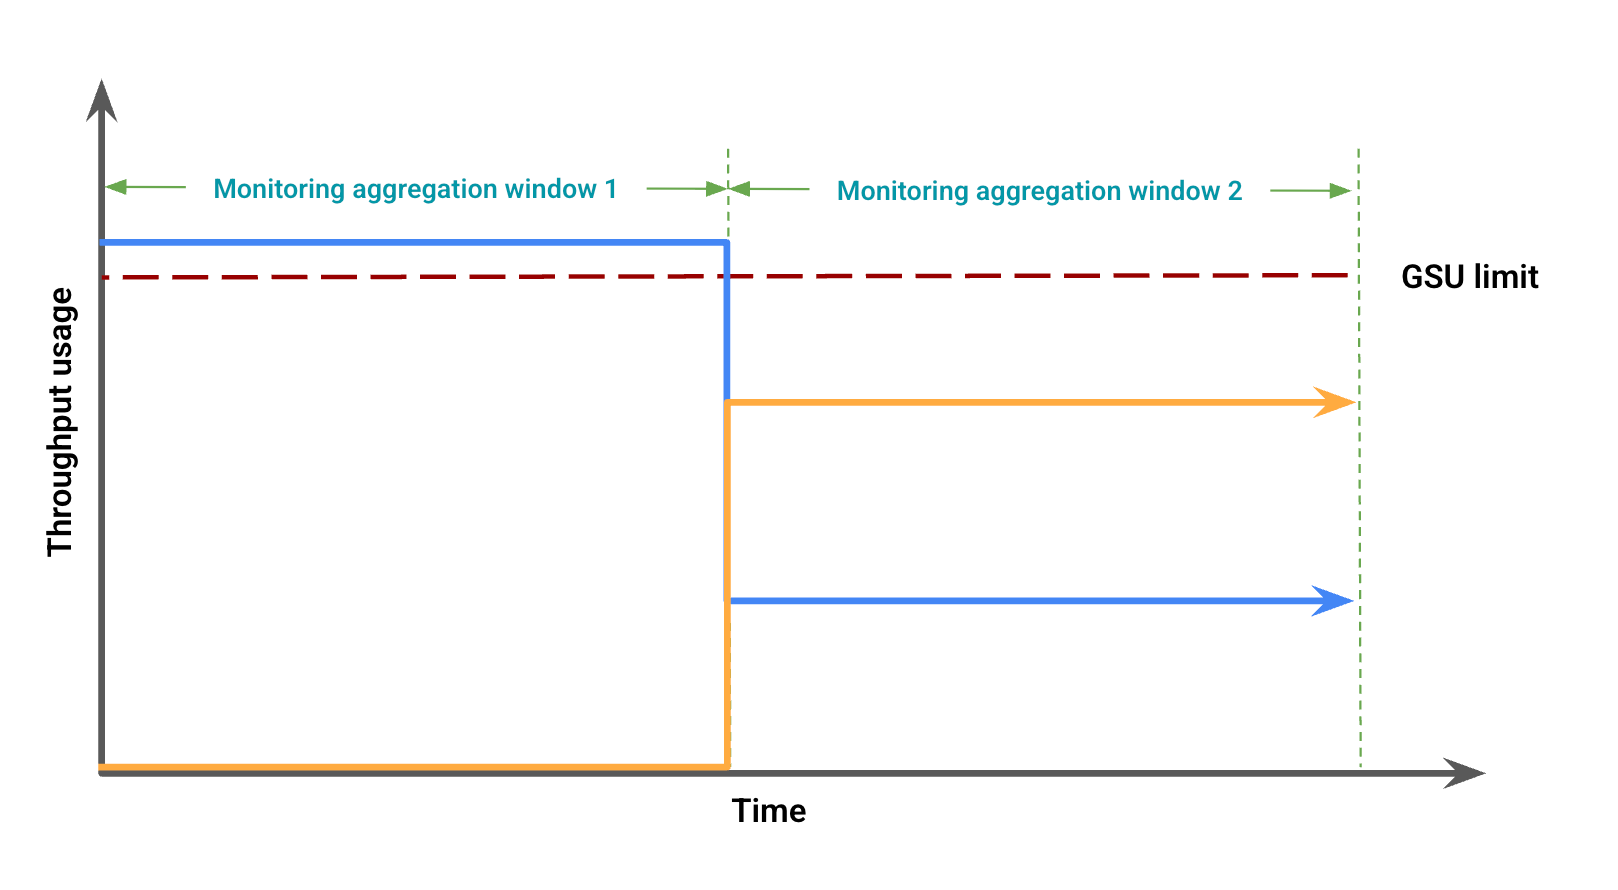
En este caso, los datos de supervisión pueden mostrar el uso de la capacidad de procesamiento aprovisionada sin desbordamiento para un período de agregación de supervisión, mientras se observa de forma simultánea el uso de la capacidad de procesamiento aprovisionada por debajo del límite de GSU, lo que coincide con un desbordamiento en otro período de agregación de supervisión.
Soluciona problemas de paneles de supervisión
Para solucionar problemas de desbordamiento inesperado en tus paneles o errores 429, sigue estos pasos:
Acercar: Establece el período del panel en 12 horas o menos para proporcionar el período de alineación más detallado de 1 minuto. Los períodos grandes suavizan los picos que causan la limitación y aumentan los promedios del período de alineación.
Verifica el tráfico total: Tus paneles específicos del modelo muestran el tráfico dedicado y el tráfico de desbordamiento como dos líneas separadas, lo que podría llevar a la conclusión incorrecta de que la cuota de capacidad de procesamiento aprovisionada no se utiliza por completo y se desborda de forma prematura. Si tu tráfico supera la cuota disponible, toda la solicitud se procesa como desbordamiento. Para obtener otra visualización útil, agrega una consulta al panel con el Explorador de métricas y, luego, incluye la capacidad de procesamiento de tokens para el modelo y la región específicos. No incluyas agregaciones ni filtros adicionales para ver el tráfico total en todos los tipos de tráfico (dedicado, de desbordamiento y compartido).
Supervisa los modelos de Genmedia
La supervisión de la capacidad de procesamiento aprovisionada no está disponible en los modelos de Veo.
Alertas
Después de habilitar las alertas, establece alertas predeterminadas para ayudarte a administrar el uso del tráfico.
Habilitar alertas
Para habilitar las alertas en el panel, haz lo siguiente:
En la consola de Cloud de Confiance , ve a la página Capacidad de procesamiento aprovisionada.
Para ver el uso de la capacidad de procesamiento aprovisionada de cada modelo en tus pedidos, selecciona la pestaña Resumen de uso.
Selecciona Alertas recomendadas y se mostrarán las siguientes alertas:
Provisioned Throughput Usage Reached LimitProvisioned Throughput Utilization Exceeded 80%Provisioned Throughput Utilization Exceeded 90%
Consulta las alertas que te ayudan a administrar tu tráfico.
Ver más detalles de la alerta
Para ver más información sobre las alertas, haz lo siguiente:
Ve a la página Integraciones.
Ingresa Agent Platform en el campo Filtro y presiona Intro. Aparecerá Google Agent Platform.
Para ver más información, haz clic en Ver detalles. Aparecerá el panel Detalles de Google Agent Platform.
Selecciona la pestaña Alertas y, luego, una plantilla de política de alertas.
¿Qué sigue?
- Soluciona el código de error
429.