

강화 학습은 대규모 언어 모델(LLM)을 적응시켜 사용자가 정의한 보상 함수에서 제공하는 피드백 보상을 극대화하는 강력한 기법입니다. 모델은 가능한 여러 답변을 탐색하고 각 답변에 대한 숫자 보상을 관찰하며 보상이 높은 답변이 더 많이 나오고 보상이 낮은 답변이 덜 나오도록 점진적으로 행동을 바꿉니다. 이 접근 방식은 다단계 추론, 복잡한 의사 결정 또는 프롬프트의 미묘한 뉘앙스 이해가 필요한 시나리오에서 뛰어난 성능을 발휘합니다.
Gemini의 강화 학습 미세 조정을 사용하면 자체 프롬프트와 자체 정의 보상 함수를 사용하여 Gemini를 미세 조정할 수 있습니다. 이를 사용하여 자체 사용 사례 및 에이전트형 워크플로를 위한 Gemini 모델의 추론 기능과 출력 품질을 향상할 수 있습니다.
작동 방식
강화 학습 미세 조정은 LLM의 동작을 개선하기 위해 반복적으로 작동합니다. 각 반복에서 모델은 프롬프트 세트에 대한 응답을 생성합니다. 그런 다음 이러한 대답은 사용자 정의 보상 함수에 의해 평가되며, 이 함수는 원하는 기준에 따라 생성된 출력의 품질을 정량화합니다. 이 서비스는 이 보상 신호를 사용하여 강화 학습 알고리즘을 통해 모델의 매개변수를 업데이트하여 보상이 더 높은 행동을 장려합니다. 생성, 평가, 업데이트의 반복적인 프로세스를 통해 모델은 특정 사용 사례를 학습하고 이에 적응할 수 있습니다.
다음 다이어그램은 전체 강화 학습 미세 조정 워크플로를 보여줍니다.
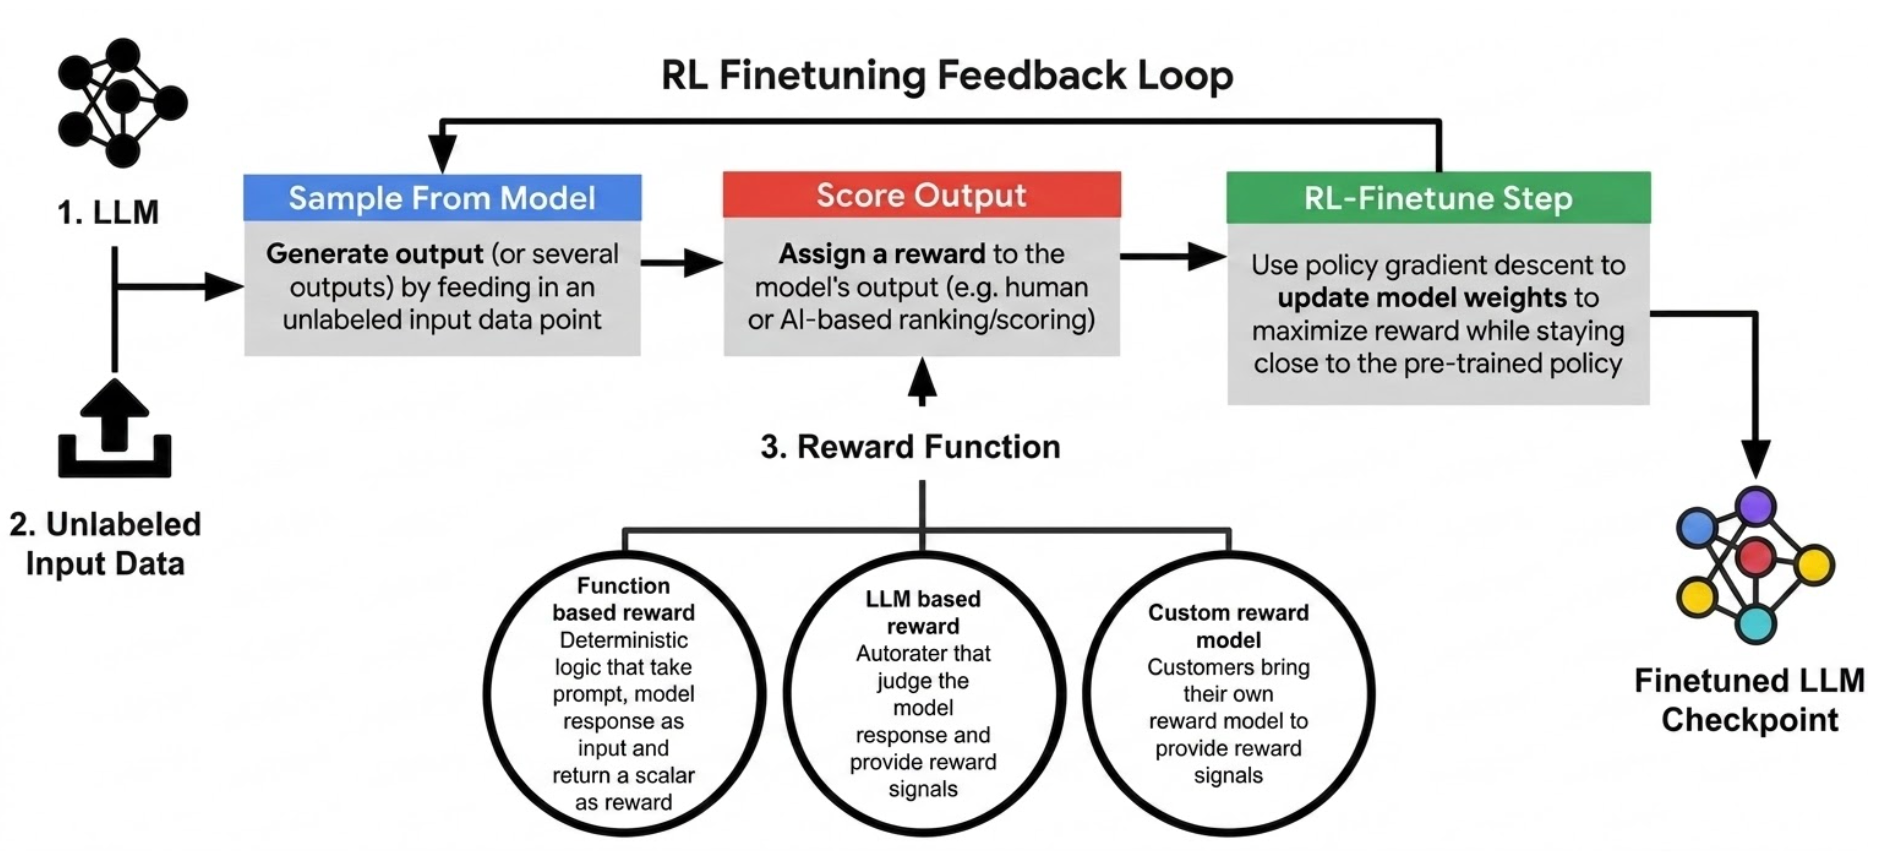
주요 특징
맞춤설정 가능한 보상 함수: 다양한 맞춤 사용 사례에 맞게 정확하게 최적화하고 모델의 동작을 특정 목표에 맞추기 위해 자체 보상 함수를 정의합니다. 지원되는 보상 유형에 대한 자세한 내용은 보상 함수 페이지를 참고하세요.
효율적인 조정을 위한 어댑터: 강화 학습 미세 조정은 어댑터를 사용하므로 기존 서비스 인프라를 재사용하면서 효과적으로 적응할 수 있습니다.
다양한 사고 수준: 이 서비스는 두 가지 사고 수준인
MINIMAL및HIGH(동적 사고)에서 조정 기능을 지원하므로 모델의 학습 목표와 원하는 응답 생성 패턴에 가장 적합한 접근 방식을 선택할 수 있습니다. 자세한 내용은 하이퍼파라미터 페이지를 참고하세요.지속적 조정: 추가 학습 예시 또는 에포크를 통합하여 이전에 조정된 모델을 추가로 미세 조정합니다. 기존 조정된 모델이나 체크포인트를 기반으로 사용하면 조정 실험을 더 효율적으로 진행할 수 있습니다. 자세한 내용은 지속적인 조정 페이지를 참고하세요.
멀티모달 데이터 세트: 텍스트, 이미지, 동영상 (Gemini 3.5 Flash만 해당), 오디오 데이터 모달리티를 지원합니다.
강화 학습 미세 조정을 사용해야 하는 경우
강화 학습 미세 조정은 지도 학습을 통해 최적의 전략이 명확하지 않은 상황에서 LLM을 미세 조정하는 데 적합합니다. 여기에는 정답 라벨을 쉽게 사용할 수 없는 상황에서 특정 측정항목을 최적화하는 것이 목표인 작업, 사람의 선호도와의 정렬이 중요하고 판단 방법이 있는 작업, 반복적인 개선과 탐색의 이점을 얻는 추론 중심 작업이 포함됩니다.
다음은 강화 학습 미세 조정이 선호되는 몇 가지 시나리오입니다.
복잡한 안내 따르기: '올바른' 출력이 단일 대답이 아니라 일련의 검사가 필요한 복잡한 안내를 모델이 따라야 하는 경우입니다. 강화 학습은 모델이 이러한 복잡한 명령어 세트를 탐색하는 방법을 학습하는 데 도움이 될 수 있습니다.
창의적인 콘텐츠 생성: 객관적인 측정항목을 정의하기 어려운 창의적인 글쓰기, 시, 고도로 전문화된 코드 생성과 같은 작업에 적합합니다. 잘 설계된 보상 함수(인간 피드백 또는 전문가 평가 포함 가능)를 사용한 강화 학습은 모델이 더 바람직하고 혁신적인 출력을 생성하도록 유도할 수 있습니다.
추론 작업: 단어 퍼즐이나 수학 문제 풀이와 같이 추론이 많이 필요한 작업의 경우 강화 학습을 통해 모델이 다양한 '사고' 시퀀스를 탐색하여 문제 해결에 가장 효과적인 추론 패턴을 학습하도록 유도할 수 있습니다.
지원되는 모델 및 지역
다음 Gemini 모델은 강화 학습 미세 조정을 지원합니다.
Gemini 3.5 Flash
| 사양 | 값 |
|---|---|
| 모델 조정에 지원되는 엔드포인트 |
|
| 조정된 모델 서빙을 위해 지원되는 엔드포인트 |
|
| API 버전 | v1beta1만 해당 |
Gemini 3.1 Flash-Lite
| 사양 | 값 |
|---|---|
| 모델 조정에 지원되는 엔드포인트 |
|
| 조정된 모델 서빙을 위해 지원되는 엔드포인트 |
|
| API 버전 | v1beta1만 해당 |
지원되는 조정 모달리티
강화 학습 미세 조정은 조정 데이터 세트에서 다음 데이터 모달리티를 지원합니다.
- 텍스트
- 오디오
- 이미지
- 동영상 (Gemini 3.5 Flash에서만 지원)
모달리티별 데이터 세트 제한 (예: 프롬프트당 최대 파일 수, 최대 파일 크기, 최대 총 길이)은 조정 데이터 세트 페이지를 참고하세요.
지속적 조정
이전 조정 작업의 출력을 새로운 강화 학습 미세 조정 작업의 기반으로 사용할 수 있습니다. 다음과 같은 지속적 조정 패턴이 지원됩니다.
- 지도 미세 조정 → 강화 학습 미세 조정
- 강화 학습 미세 조정 → 강화 학습 미세 조정
구성 세부정보는 지속적 조정 페이지를 참고하세요.
조정된 모델 제공
기본 Gemini 모델에서 강화 학습 미세 조정 작업이 완료되면 마지막 체크포인트를 기반으로 조정된 모델이 프로젝트의 엔드포인트에 배포됩니다. 조정된 모델은 기본 모델과 동일한 서빙 엔드포인트 전략을 사용합니다. 예를 들어 us-central1에서 미세 조정 작업을 실행하면 조정된 모델이 us 멀티 리전 엔드포인트(mREP)에 배포됩니다.
배포된 조정된 모델 엔드포인트를 검색하고 추론을 실행하려면 Cloud de Confiance 콘솔 빠른 시작 또는 API 빠른 시작을 참고하세요.
가격 책정
튜닝 가격
Gemini의 강화 학습 미세 조정은 샘플링 단계와 학습 단계의 두 단계로 토큰을 생성합니다. 학습 단계에서 생성된 토큰은 Gemini Enterprise Agent Platform 가격 책정 페이지의 '모델 미세 조정' 섹션에 따라 청구됩니다.
추론 가격 책정
조정 후에도 조정된 모델의 추론 (예측 요청) 비용이 계속 적용됩니다. Gemini 3부터 모델 추론의 경우 조정된 모델 엔드포인트 예측 가격은 기본 모델 가격의 1.5배입니다. 자세한 내용은 사용 가능한 Gemini 안정화 모델 버전을 참고하세요.
조정 중에 Gen AI Evaluation Service가 자동으로 실행되도록 구성하면 평가 비용이 일괄 예측 작업으로 청구됩니다. 자세한 내용은 Gemini Enterprise Agent Platform 가격 책정 페이지의 '모델 미세 조정' 섹션을 참고하세요.
다음 단계
- Cloud de Confiance 콘솔 빠른 시작 또는 API 빠른 시작에 따라 첫 번째 강화 학습 미세 조정 작업을 만듭니다.
- 조정 데이터 세트를 준비하고 보상 함수를 구성하는 방법을 알아봅니다.
- 조정된 Gemini 모델 배포에 대해 알아보기