

使用 ARIMA_PLUS 單變數模型預測階層式時間序列
本教學課程說明如何使用 ARIMA_PLUS 單變數時間序列模型預測階層式時間序列。這項功能會根據指定資料欄的歷來值,預測該資料欄的未來值,並計算該資料欄一或多個感興趣維度的匯總值。
系統會針對每個時間點,以及指定相關維度的一或多個資料欄中的每個值,計算預測值。舉例來說,如果您想預測每日交通事故,並指定包含州資料的維度欄,則預測資料會包含州 A 每天的值、州 B 每天的值,依此類推。舉例來說,如果您想預測每日交通事件,並指定包含州和城市資料的維度欄,預測資料就會包含州 A 和城市 A 每天的值,然後是州 A 和城市 B 每天的值,依此類推。在階層式時間序列模型中,階層式協調用於匯總及協調每個子時間序列與其父項。舉例來說,A 州所有城市的預測值總和必須等於 A 州的預測值。
在本教學課程中,您將使用相同資料建立兩個時間序列模型,一個使用階層式預測,另一個則不使用。這樣一來,您就能比較模型傳回的結果。
本教學課程使用公開 bigquery-public-data.iowa_liquor.sales.sales 資料表中的資料。這個資料表包含愛荷華州公開酒類銷售資料,涵蓋不同商店超過 100 萬種酒類產品的資訊。
強烈建議您先閱讀「使用單變數模型預測多個時間序列」,再閱讀本教學課程。
所需權限
如要建立資料集,您必須具備
bigquery.datasets.createIAM 權限。如要建立模型,您必須具備下列權限:
bigquery.jobs.createbigquery.models.createbigquery.models.getDatabigquery.models.updateData
如要執行推論,您必須具備下列權限:
bigquery.models.getDatabigquery.jobs.create
如要進一步瞭解 BigQuery 的 IAM 角色和權限,請參閱「IAM 簡介」。
目標
在本教學課程中,您會使用下列項目:
- 使用
CREATE MODEL陳述式建立多個時間序列模型和多個階層式時間序列模型,預測瓶裝酒銷售值。 - 使用
ML.FORECAST函式,從模型擷取預測的瓶裝銷售值。
費用
本教學課程使用 Cloud de Confiance by S3NS的計費元件,包括:
- BigQuery
- BigQuery ML
如要進一步瞭解 BigQuery 費用,請參閱「BigQuery 定價」頁面。
如要進一步瞭解 BigQuery ML 費用,請參閱「BigQuery ML 定價」。
-
In the Cloud de Confiance console, on the project selector page, select or create a Cloud de Confiance project.
Roles required to select or create a project
- Select a project: Selecting a project doesn't require a specific IAM role—you can select any project that you've been granted a role on.
-
Create a project: To create a project, you need the Project Creator role
(
roles/resourcemanager.projectCreator), which contains theresourcemanager.projects.createpermission. Learn how to grant roles.
-
Verify that billing is enabled for your Cloud de Confiance project.
- 新專案會自動啟用 BigQuery。如要在現有專案中啟用 BigQuery,請前往
啟用 BigQuery API (如果尚未啟用)。
啟用 API 所需的角色
您必須具備
serviceusage.services.enable權限,才能啟用 API。如果您建立了專案,可能已透過擁有者角色 (roles/owner) 取得這項權限。否則,您可以透過 Service Usage 管理員角色 (roles/serviceusage.serviceUsageAdmin) 取得這項權限。瞭解如何授予角色。
建立資料集
如要建立 BigQuery 資料集,請選取下列其中一個選項:
控制台
前往 Cloud de Confiance 控制台的「BigQuery」頁面。
點選左側窗格中的 「Explorer」。

如果沒有看到左側窗格,請按一下 「Expand left pane」(展開左側窗格),開啟窗格。
在「Explorer」中展開專案,然後按一下「資料集」。
在「Datasets」(資料集) 頁面,按一下「Create dataset」(建立資料集)。
在「建立資料集」窗格中,執行下列操作:
在「Dataset ID」(資料集 ID) 中輸入
bqml_tutorial。在「資料位置」部分,選取「US」。
其餘預設設定則保持不變。
點選「建立資料集」。
bq
如要建立新的資料集,請使用 bq mk --dataset 指令。
建立名為
bqml_tutorial的資料集,並將資料位置設為US:bq mk --dataset \ --location=US \ --description "BigQuery ML tutorial dataset." \ bqml_tutorial
確認資料集已建立:
bq ls
API
使用定義的資料集資源呼叫 datasets.insert 方法:
{
  "datasetReference": {
     "datasetId": "bqml_tutorial"
  }
}
建立時間序列模型
使用愛荷華州酒類銷售資料,建立時間序列模型。
下列 GoogleSQL 查詢會建立模型,預測 2015 年 Polk、Linn 和 Scott 郡每日售出的酒瓶總數。
在下列查詢中,OPTIONS(model_type='ARIMA_PLUS', time_series_timestamp_col='date', ...) 子句表示您正在建立以 ARIMA 為基礎的時間序列模型。您可以使用 CREATE MODEL 陳述式的 TIME_SERIES_ID 選項,指定輸入資料中要取得預測的一或多個資料欄。CREATE MODEL 陳述式的 auto_arima_max_order 選項,可控制 auto.ARIMA 演算法中超參數調整的搜尋空間。CREATE MODEL 陳述式的 decompose_time_series 選項預設為 TRUE,因此在下一個步驟評估模型時,系統會傳回時間序列資料的相關資訊。
OPTIONS(model_type='ARIMA_PLUS', time_series_timestamp_col='date', ...) 子句表示您正在建立以 ARIMA 為基礎的時間序列模型。根據預設,auto_arima=TRUE,因此 auto.ARIMA 演算法會自動調整 ARIMA_PLUS 模型中的超參數。演算法會擬合數十個候選模型,並選擇最佳模型,也就是赤池資訊準則 (AIC) 最低的模型。如果時間序列中有美國節日模式,將 holiday_region 選項設為 US,即可在這些美國節日時間點進行更準確的模擬。
請按照下列步驟建立模型:
前往 Cloud de Confiance 控制台的「BigQuery」頁面。
在查詢編輯器中貼上以下查詢,然後點選「執行」:
CREATE OR REPLACE MODEL `bqml_tutorial.liquor_forecast`
  OPTIONS (
    MODEL_TYPE = 'ARIMA_PLUS',
    TIME_SERIES_TIMESTAMP_COL = 'date',
    TIME_SERIES_DATA_COL = 'total_bottles_sold',
    TIME_SERIES_ID_COL = ['store_number', 'zip_code', 'city', 'county'],
    HOLIDAY_REGION = 'US')
AS
SELECT
  store_number,
  zip_code,
  city,
  county,
  date,
  SUM(bottles_sold) AS total_bottles_sold
FROM
  `bigquery-public-data.iowa_liquor_sales.sales`
WHERE
  date BETWEEN DATE('2015-01-01') AND DATE('2015-12-31')
  AND county IN ('POLK', 'LINN', 'SCOTT')
GROUP BY store_number, date, city, zip_code, county;
查詢約需 37 秒才能完成,完成後即可存取
liquor_forecast模型。由於查詢使用CREATE MODEL陳述式建立模型,因此不會有查詢結果。
使用模型預測資料
使用 ML.FORECAST 函式預測未來時間序列值。
在下列查詢中,STRUCT(20 AS horizon, 0.8 AS confidence_level) 子句表示查詢會預測 20 個未來時間點,並產生信賴水準為 80% 的預測區間。
請按照下列步驟,使用模型預測資料:
前往 Cloud de Confiance 控制台的「BigQuery」頁面。
在查詢編輯器中貼上以下查詢,然後點選「執行」:
SELECT *
FROM
  ML.FORECAST(
    MODEL `bqml_tutorial.liquor_forecast`,
    STRUCT(20 AS horizon, 0.8 AS confidence_level))
ORDER BY store_number, county, city, zip_code, forecast_timestamp;
結果應大致如下:
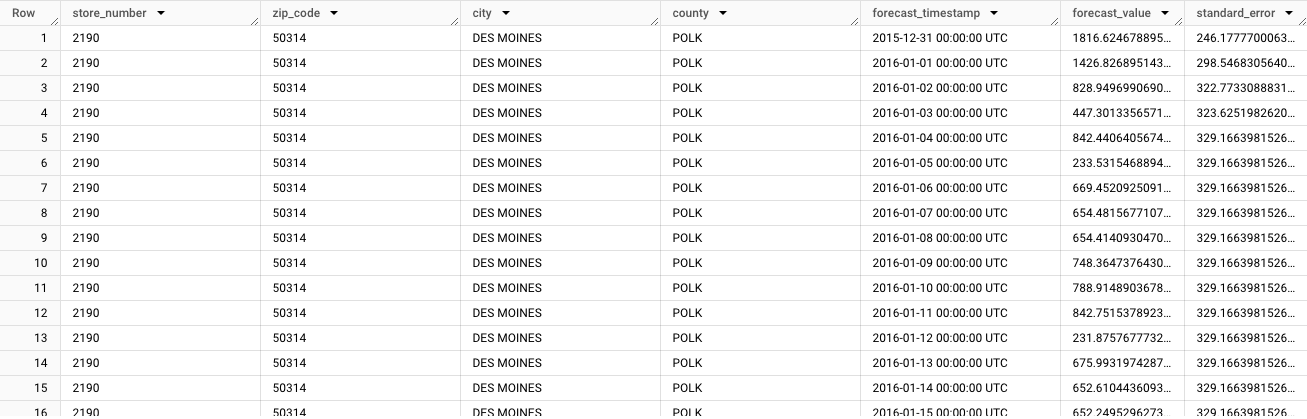
輸出內容會從第一個時間序列的預測資料開始:
store_number=2190、zip_code=50314、city=DES MOINES、county=POLK。捲動資料時,您會看到每個後續不重複時間序列的預測。如要產生匯總不同維度總計的預測,例如特定郡縣的預測,您必須產生階層式預測。
建立階層式時間序列模型
使用愛荷華州酒類銷售資料,建立階層式時間序列預測。
下列 GoogleSQL 查詢會建立模型,針對 2015 年 Polk、Linn 和 Scott 郡每日售出的瓶裝酒總數,生成階層式預測。
在下列查詢中,CREATE MODEL 陳述式中的 HIERARCHICAL_TIME_SERIES_COLS 選項表示您要根據指定的一組資料欄建立階層式預測。這些資料欄都會匯總。舉例來說,從先前的查詢來看,這表示 store_number 資料欄值會匯總,顯示每個 county、city 和 zip_code 值的預測。此外,zip_code 和 store_number 值也會分別匯總,顯示每個 county 和 city 值的預測結果。資料欄順序會決定階層結構,因此十分重要。
請按照下列步驟建立模型:
前往 Cloud de Confiance 控制台的「BigQuery」頁面。
在查詢編輯器中貼上以下查詢,然後點選「執行」:
CREATE OR REPLACE MODEL `bqml_tutorial.liquor_forecast_hierarchical`
  OPTIONS (
    MODEL_TYPE = 'ARIMA_PLUS',
    TIME_SERIES_TIMESTAMP_COL = 'date',
    TIME_SERIES_DATA_COL = 'total_bottles_sold',
    TIME_SERIES_ID_COL = ['store_number', 'zip_code', 'city', 'county'],
    HIERARCHICAL_TIME_SERIES_COLS = ['zip_code', 'store_number'],
    HOLIDAY_REGION = 'US')
AS
SELECT
  store_number,
  zip_code,
  city,
  county,
  date,
  SUM(bottles_sold) AS total_bottles_sold
FROM
  `bigquery-public-data.iowa_liquor_sales.sales`
WHERE
  date BETWEEN DATE('2015-01-01') AND DATE('2015-12-31')
  AND county IN ('POLK', 'LINN', 'SCOTT')
GROUP BY store_number, date, city, zip_code, county;
查詢大約需要 45 秒才能完成,完成後,您可以在「Explorer」窗格中存取
bqml_tutorial.liquor_forecast_hierarchical模型。由於查詢使用CREATE MODEL陳述式建立模型,因此沒有查詢結果。
使用階層模型預測資料
使用 ML.FORECAST 函式,從模型擷取階層式預測資料。
請按照下列步驟,使用模型預測資料:
前往 Cloud de Confiance 控制台的「BigQuery」頁面。
在查詢編輯器中貼上以下查詢,然後點選「執行」:
SELECT
  *
FROM
  ML.FORECAST(
    MODEL `bqml_tutorial.liquor_forecast_hierarchical`,
    STRUCT(30 AS horizon, 0.8 AS confidence_level))
WHERE city = 'LECLAIRE'
ORDER BY county, city, zip_code, store_number, forecast_timestamp;
結果應大致如下:
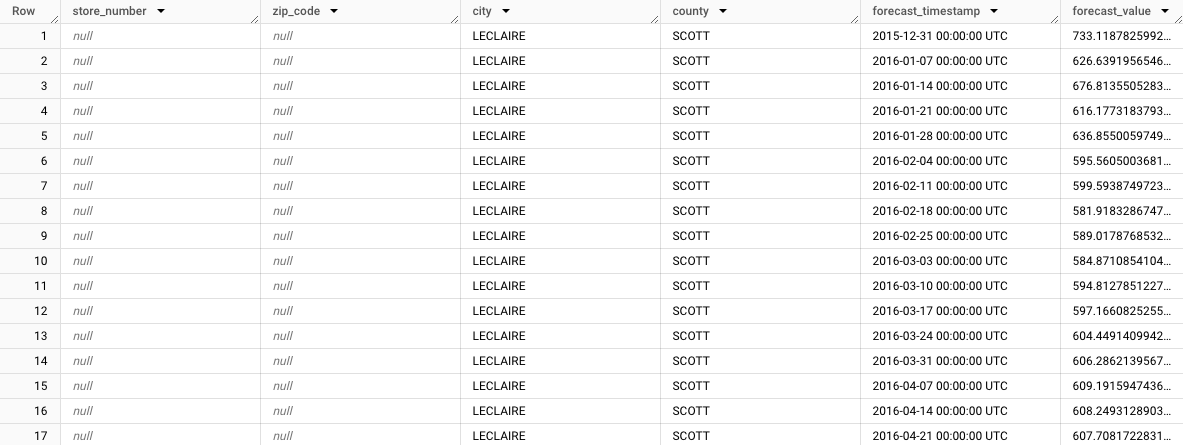
請注意,系統會顯示 LeClaire 市、
store_number=NULL、zip_code=NULL、city=LECLAIRE、county=SCOTT的匯總預測。查看其餘資料列時,請注意其他子群組的預測結果。舉例來說,下圖顯示郵遞區號52753、store_number=NULL、zip_code=52753、city=LECLAIRE、county=SCOTT的匯總預測: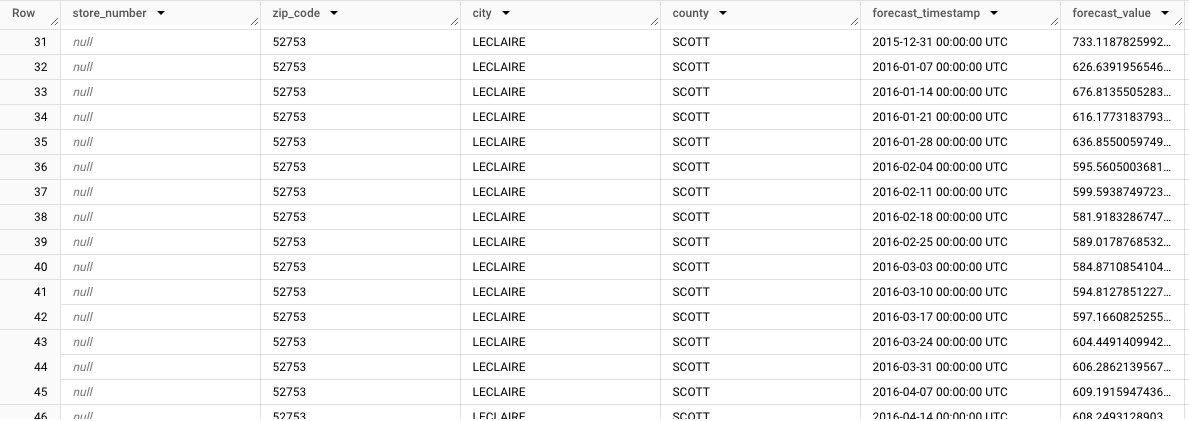
清除所用資源
如要避免系統向您的 Cloud de Confiance by S3NS 帳戶收取本教學課程所用資源的費用,請刪除含有相關資源的專案,或者保留專案但刪除個別資源。
- 您可以刪除建立的專案。
- 或者您可以保留專案並刪除資料集。
刪除資料集
刪除專案將移除專案中所有的資料集與資料表。若您希望重新使用專案,您可以刪除本教學課程中所建立的資料集。
如有需要,請在Cloud de Confiance 控制台開啟 BigQuery 頁面。
在導覽窗格中,按一下您建立的 bqml_tutorial 資料集。
按一下視窗右側的「刪除資料集」。這個動作將會刪除資料集、資料表,以及所有資料。
在「Delete dataset」(刪除資料集) 對話方塊中,輸入資料集名稱 (
bqml_tutorial) 來確認刪除指令,然後點選「Delete」(刪除)。
刪除專案
如要刪除專案,請進行以下操作:
- 前往 Cloud de Confiance 控制台的「Manage resources」(管理資源) 頁面。
- 在專案清單中選取要刪除的專案,然後點選「Delete」(刪除)。
- 在對話方塊中輸入專案 ID,然後按一下 [Shut down] (關閉) 以刪除專案。
後續步驟
- 瞭解如何使用單變數模型預測單一時間序列
- 瞭解如何使用單變數模型預測多個時間序列
- 瞭解如何在預測多個資料列的多個時間序列時,擴充單變數模型。
- 瞭解如何使用多變數模型預測單一時間序列
- 如要瞭解 BigQuery ML,請參閱「BigQuery AI 和機器學習簡介」。