

Esegui la migrazione del codice con il traduttore SQL batch
Questo documento descrive come utilizzare il traduttore SQL batch in BigQuery per tradurre script scritti in altri dialetti SQL in query GoogleSQL. Puoi inviare e rivedere i risultati di un job di traduzione dalla console Cloud de Confiance o dalla riga di comando.
Per un elenco dei dialetti SQL supportati da questo traduttore SQL, consulta Dialetti SQL supportati.
Per un elenco delle località di elaborazione supportate, consulta Località.
Prima di iniziare
Prima di inviare un lavoro di traduzione, segui questi passaggi.
Abilitare le traduzioni SQL
Abilita l'API richiesta e ottieni le autorizzazioni necessarie per utilizzare un traduttore SQL BigQuery. Per saperne di più, consulta Attivare le traduzioni SQL.
Autorizzazioni obbligatorie
Per ottenere le autorizzazioni necessarie per creare job di traduzione con il traduttore interattivo, l'API Translation o il traduttore SQL batch, chiedi all'amministratore di concederti i seguenti ruoli IAM sulla risorsa parent:
-
Visualizzazione e monitoraggio dei job di migrazione:
Visualizzatore MigrationWorkflow (
roles/bigquerymigration.viewer) -
Invio di job di migrazione:
Editor MigrationWorkflow (
roles/bigquerymigration.editor) -
Accedi ai bucket Cloud Storage per l'input e i file:
Storage Object Admin (
roles/storage.objectAdmin) sul bucket Cloud Storage di origine e di destinazione.
Per saperne di più sulla concessione dei ruoli, consulta Gestisci l'accesso a progetti, cartelle e organizzazioni.
Questi ruoli predefiniti contengono le autorizzazioni necessarie per creare job di traduzione con il traduttore interattivo, l'API Translation o il traduttore SQL batch. Per vedere quali sono esattamente le autorizzazioni richieste, espandi la sezione Autorizzazioni obbligatorie:
Autorizzazioni obbligatorie
Per creare job di traduzione con il traduttore interattivo, l'API Translation o il traduttore SQL batch sono necessarie le seguenti autorizzazioni:
-
bigquerymigration.workflows.create -
bigquerymigration.workflows.get -
bigquerymigration.workflows.list -
bigquerymigration.workflows.delete -
bigquerymigration.subtasks.get -
bigquerymigration.subtasks.list -
storage.objects.get -
storage.objects.list -
storage.objects.create
Potresti anche ottenere queste autorizzazioni con ruoli personalizzati o altri ruoli predefiniti.
Raccogliere i file di origine
I file di origine devono essere file di testo contenenti SQL valido per il dialetto di origine. I file di origine possono includere anche commenti. Fai del tuo meglio per assicurarti che l'SQL sia valido, utilizzando tutti i metodi a tua disposizione.
Creare file di metadati
Per aiutare il servizio a generare risultati di traduzione più accurati, ti consigliamo di fornire file di metadati. Tuttavia, non è obbligatorio.
Puoi utilizzare lo strumento di estrazione da riga di comando dwh-migration-dumper per generare le informazioni sui metadati. Dopo aver preparato i file di metadati, puoi includerli insieme ai file di origine nella cartella di origine della traduzione. Il traduttore li rileva automaticamente e li utilizza
per tradurre i file di origine, quindi non devi configurare impostazioni aggiuntive per attivare questa funzionalità.
Per generare informazioni sui metadati utilizzando lo
strumento dwh-migration-dumper, consulta
Generare metadati per la traduzione.
Crea file YAML di configurazione
Se vuoi, puoi creare e utilizzare file YAML di configurazione per personalizzare le traduzioni batch. Questi file possono essere utilizzati per trasformare l'output della traduzione in vari modi. Ad esempio, puoi creare un file YAML di configurazione per modificare le maiuscole e minuscole di un oggetto SQL durante la traduzione.
Utilizza una delle seguenti opzioni per includere un file YAML di configurazione nel job di traduzione.
Console
Carica il file YAML di configurazione nella directory Cloud Storage che contiene i file di origine. Quando selezioni questa directory come posizione di input, il job di traduzione include automaticamente il file YAML di configurazione.
gcloud
I flag che utilizzi con il comando gcloud alpha bq translation translate-batch dipendono dalla posizione in cui è archiviato il file YAML di configurazione:
- Se il file YAML di configurazione si trova nella stessa directory dei file sorgente, non sono necessari flag aggiuntivi. Quando imposti questa directory nel flag
--source-gcs-uriso--source-local-dirs, il job include automaticamente il file YAML di configurazione. - Se il file YAML di configurazione è archiviato separatamente sulla tua macchina locale, utilizza il flag
--source-local-filesper caricarlo e aggiungerlo al job. - Se il file YAML di configurazione è archiviato separatamente in Cloud Storage, utilizza il flag
--source-gcs-filesper aggiungerlo al job.
Ad esempio, il seguente comando carica i file di origine e un file YAML di configurazione archiviato separatamente dalla macchina locale, quindi esegue il job di traduzione:
gcloud alpha bq translation translate-batch \
  --source-dialect=SOURCE_DIALECT \
  --target-dialect=TARGET_DIALECT \
  --location=LOCATION \
  --source-local-dirs=LOCAL_DIR=SOURCE_URI \
  --source-local-files=LOCAL_CONFIG_YAML=CONFIG_YAML_URI \
  --target-gcs-path=TARGET_URI
Sostituisci quanto segue:
LOCAL_CONFIG_YAML: il percorso locale del file YAML di configurazione, ad esempio./configs/change-case.config.yaml.CONFIG_YAML_URI: l'URI Cloud Storage a cui il comando carica il file YAML di configurazione, ad esempiogs://my_data_bucket/teradata/configs/change-case.config.yaml. Questo URI deve trovarsi al di fuori della directorySOURCE_URI.
Per le descrizioni degli altri segnaposto, vedi Inviare un lavoro di traduzione.
Carica i file di input su Cloud Storage
Carica su Cloud Storage i file di origine contenenti le query e gli script che vuoi tradurre. Puoi anche caricare qualsiasi file di metadati o file YAML di configurazione nello stesso bucket Cloud Storage e nella stessa directory contenenti i file di origine. Per saperne di più sulla creazione di bucket e sul caricamento di file in Cloud Storage, consulta Creare bucket e Caricare oggetti da un file system.
Scegli come inviare il progetto di traduzione
Hai due opzioni per inviare un job di traduzione batch:
Cloud de Confiance Console: configura e invia un job utilizzando un'interfaccia utente. Questo approccio richiede il caricamento dei file di origine su Cloud Storage.
Google Cloud CLI: invia un job dalla riga di comando utilizzando gcloud CLI. Il comando
translate-batchaccetta le posizioni di origine e di destinazione come flag e può caricare directory e file locali su Cloud Storage. Per saperne di più, consulta Inviare un lavoro di traduzione.
Entrambe le opzioni richiedono che i file di origine siano accessibili in Cloud Storage ed entrambe creano lo stesso tipo di job di traduzione. Un job che invii dalla riga di comando viene comunque visualizzato nell'elenco dei job di traduzione nella consoleCloud de Confiance .
Inviare un job di traduzione
Utilizza una delle seguenti opzioni per avviare un job di traduzione e visualizzarne l'avanzamento. Per esaminare i risultati in un secondo momento, consulta la sezione Esplorare l'output della traduzione.
Console
Questi passaggi presuppongono che tu abbia caricato i file delle fonti in un bucket Cloud Storage.
Per utilizzare la console Cloud de Confiance per inviare un job di traduzione batch, segui questi passaggi:
Nella console Cloud de Confiance , vai alla pagina SQL Translation.
Nel riquadro Traduzione SQL, fai clic su Avvia traduzione.
In Configurazione della traduzione, inserisci quanto segue:
- In Nome visualizzato, inserisci un nome per il job di traduzione. Il nome può contenere lettere, numeri o trattini bassi.
- Per Località di elaborazione, seleziona la località in cui vuoi eseguire il job di traduzione. Ad esempio, se ti trovi in Europa e non vuoi che i dati superino i confini di località, seleziona la regione
eu. Il job di traduzione funziona meglio quando scegli la stessa posizione del bucket del file di origine. - Per Dialetto di origine, seleziona il dialetto SQL che vuoi tradurre.
- Per Dialetto di destinazione, seleziona GoogleSQL.
Fai clic su Avanti.
Per Dettagli posizione file, specifica i percorsi Cloud Storage da utilizzare per l'input e l'output della traduzione. Puoi inserire i percorsi nel formato
bucket_name/folder_name/o utilizzare l'opzione Sfoglia per accedere a una cartella.- Per Percorso della directory di output, specifica un percorso per la cartella Cloud Storage di destinazione per i file tradotti. Questa directory funge da directory principale per tutti gli output di traduzione.
- Scegli una o più posizioni delle directory di input contenenti il percorso dei file SQL da tradurre.
- Se necessario, a ogni directory di input può essere assegnato un nome di sottodirectory di output sotto la directory di output principale.
Fai clic su Avanti.
Seleziona le impostazioni facoltative necessarie per personalizzare i metadati e gli output di traduzione aggiuntivi.
(Facoltativo) Per personalizzare ulteriormente il comportamento di traduzione, crea file YAML di configurazione e inseriscili nel bucket Cloud Storage di input. Questi file possono essere utilizzati per rinominare gli oggetti, attivare le ottimizzazioni, migliorare le traduzioni con Gemini e altro ancora. Per saperne di più sui file YAML di configurazione, vedi Creare un file YAML di configurazione.
Fai clic su Crea per avviare il job di traduzione.
Dopo aver creato il job di traduzione, puoi visualizzarne lo stato nell'elenco dei job di traduzione.
gcloud
Per inviare un job di traduzione batch, utilizza il
comando gcloud alpha bq translation translate-batch.
I flag che utilizzi per identificare i file di origine dipendono dal fatto che i file si trovino in Cloud Storage o sulla tua macchina locale.
Tradurre file SQL in Cloud Storage
Per tradurre i file SQL che hai già
caricato su Cloud Storage, identifica le directory di origine con il flag --source-gcs-uris. Se vuoi includere file
che non si trovano in --source-gcs-uris, puoi utilizzare il flag --source-gcs-files:
gcloud alpha bq translation translate-batch \
    --source-dialect=SOURCE_DIALECT \
    --target-dialect=TARGET_DIALECT \
    --location=LOCATION \
    --source-gcs-uris=SOURCE_URI \
    --target-gcs-path=TARGET_URI
Sostituisci quanto segue:
SOURCE_DIALECT: il dialetto dei file SQL di origine, ad esempioteradata. Per i valori supportati, consulta Dialetti SQL supportati.TARGET_DIALECT: il dialetto in cui tradurre i file di origine. Ad esempio,bigquery.LOCATION: la posizione che elabora il job, ad esempious.SOURCE_URI: la directory Cloud Storage che contiene i file di origine, ad esempiogs://my_data_bucket/teradata/input/.TARGET_URI: la directory Cloud Storage che riceve i file tradotti, ad esempiogs://my_data_bucket/teradata/output/.
Tradurre i file SQL sulla macchina locale
Per tradurre i file che si trovano sulla tua macchina locale, mappa ogni directory locale a un URI Cloud Storage con il flag --source-local-dirs. Il comando carica la directory nell'URI e poi include l'URI nel job di traduzione, quindi non devi caricare i file manualmente:
gcloud alpha bq translation translate-batch \
    --source-dialect=SOURCE_DIALECT \
    --target-dialect=TARGET_DIALECT \
    --location=LOCATION \
    --source-local-dirs=LOCAL_DIR=SOURCE_URI \
    --target-gcs-path=TARGET_URI
Sostituisci LOCAL_DIR con la directory locale che contiene i file di origine, ad esempio ./teradata_queries. Per le descrizioni
degli altri segnaposto, consulta
Tradurre i file SQL in Cloud Storage.
Per mappare singoli file anziché directory, utilizza il flag --source-local-files.
Aggiungere flag facoltativi
Per generare suggerimenti di Gemini insieme all'SQL tradotto,
aggiungi il flag --enable-ai-suggestion.
Per impostazione predefinita, il comando attende il completamento del job di traduzione. Per inviare il job e
tornare immediatamente, aggiungi il flag --async. Il comando stampa quindi un ID traduzione che puoi passare al comando gcloud alpha bq translation describe per controllare lo stato del job:
gcloud alpha bq translation describe TRANSLATION_ID \
    --location=LOCATION
Recuperare i file di output
Il job di traduzione scrive i risultati nella directory Cloud Storage
che hai impostato nel flag --target-gcs-path. Questa directory di destinazione contiene i file tradotti, il report di riepilogo della traduzione e tutti i file di suggerimenti dell'AI.
Per copiare l'output sulla tua macchina locale, utilizza il seguente comando:
gcloud storage cp --recursive TARGET_URI LOCAL_DIRECTORY
Sostituisci quanto segue:
TARGET_URI: l'URI di base di destinazione, ad esempiogs://my_data_bucket/teradata/output/.LOCAL_DIRECTORY: la directory locale che riceve i file.
Il job viene visualizzato anche nell'elenco dei job di traduzione nella consoleCloud de Confiance , anche se l'hai inviato dalla riga di comando. Per esaminare la qualità di un output di traduzione, consulta Esplorare l'output di traduzione.
Tradurre i metadati
Oltre a tradurre gli script SQL, puoi tradurre i metadati che descrivono il data warehouse di origine. Un job di conversione dei metadati legge i file di metadati estratti dal sistema di origine e scrive istruzioni Data Definition Language (DDL) GoogleSQL che ricreano questi oggetti in BigQuery.
L'input è costituito da uno o più file ZIP di metadati. Per scoprire come produrre questi
file con lo strumento dwh-migration-dumper, consulta
Generare metadati per la traduzione.
Puoi tradurre i metadati utilizzando la console Cloud de Confiance o gcloud CLI. Seleziona una delle seguenti opzioni:
Console
La traduzione dei metadati è un'opzione di output in un normale job di traduzione:
- Segui i passaggi descritti in Invia un job di traduzione per configurare un job utilizzando la directory Cloud Storage che contiene i file ZIP dei metadati come posizione di input.
- In Impostazioni facoltative, seleziona DDL.
- Fai clic su Crea per creare il job.
Il job scrive le istruzioni DDL tradotte nella directory di output, insieme a qualsiasi SQL tradotto.
gcloud
Puoi tradurre i metadati come job autonomo o come output aggiuntivo di un job di traduzione SQL batch.
Tradurre i metadati separatamente
Utilizza il
comando gcloud alpha bq translation translate-metadata
quando gli input sono file ZIP di metadati e non hai SQL da tradurre:
gcloud alpha bq translation translate-metadata \
  --source-dialect=SOURCE_DIALECT \
  --target-dialect=TARGET_DIALECT \
  --location=LOCATION \
  --source-gcs-uris=SOURCE_URI \
  --target-gcs-path=TARGET_URI
Sostituisci quanto segue:
SOURCE_DIALECT: il dialetto dei metadati di origine, ad esempioteradata. Per i valori supportati, consulta Dialetti SQL supportati.TARGET_DIALECT: il dialetto delle tabelle di destinazione. Ad esempio,bigquery.LOCATION: la posizione che elabora il job, ad esempious.SOURCE_URI: la directory Cloud Storage che contiene i file ZIP dei metadati, ad esempiogs://my_data_bucket/teradata/metadata/.TARGET_URI: la directory Cloud Storage che riceve le istruzioni DDL tradotte, ad esempiogs://my_data_bucket/teradata/ddl_output/.
Per indicare singoli file ZIP di metadati anziché una directory, utilizza il flag
--source-gcs-files. Per caricare i file di metadati dalla macchina locale nell'ambito del job, utilizza il flag --source-local-dirs o --source-local-files.
Come per un job di traduzione batch, il comando attende il completamento del job. Aggiungi
il flag --async per inviare il job e restituire immediatamente un ID traduzione.
Tradurre i metadati nell'ambito di una traduzione SQL batch
Se gli input della traduzione batch includono già i file ZIP dei metadati,
non è necessario un secondo job. Aggiungi metadata agli output di traduzione
del job batch con il flag --target-types e il job scrive
l'SQL tradotto e le istruzioni DDL in una singola esecuzione:
gcloud alpha bq translation translate-batch \
  --source-dialect=SOURCE_DIALECT \
  --target-dialect=TARGET_DIALECT \
  --location=LOCATION \
  --source-gcs-uris=SOURCE_URI \
  --target-gcs-path=TARGET_URI \
  --target-types=sql,metadata
Per gli altri flag accettati dal
comando translate-batch, vedi Inviare un job di traduzione.
Genera DDL dell'origine
Quando l'SQL di origine fa riferimento a tabelle di cui non disponi delle definizioni, il
traduttore non sempre riesce a risolvere gli oggetti, il che comporta problemi di RelationNotFound
o AttributeNotFound.
Il modo migliore per risolvere questi problemi è fornire le definizioni reali degli oggetti di origine. Esegui lo strumento dwh-migration-dumper sul sistema di origine e
includi il file ZIP dei metadati risultante negli input di traduzione. Per
istruzioni, vedi
Generare metadati per la traduzione.
I metadati estratti descrivono esattamente gli oggetti, quindi il traduttore li risolve
senza congetture.
Se non riesci a estrarre i metadati, ad esempio quando non hai più accesso al sistema di origine, puoi chiedere a Gemini di dedurre le istruzioni DDL mancanti dall'SQL di origine. Gemini deduce queste istruzioni DDL dal modo in cui gli oggetti vengono utilizzati nelle query, quindi rivedi e verifica sempre queste istruzioni prima di utilizzarle.
Puoi generare il DDL di origine per le traduzioni utilizzando la consoleCloud de Confiance o gcloud CLI. Seleziona una delle seguenti opzioni:
Console
Gemini genera suggerimenti DDL di origine nell'ambito di un normale job di traduzione:
- Segui i passaggi descritti in Invia un job di traduzione per configurare un job.
- In Impostazioni facoltative, seleziona Suggerimenti dell'AI di Gemini.
- Fai clic su Crea per creare il job.
Se la traduzione produce problemi di RelationNotFound o AttributeNotFound,
il job genera istruzioni DDL di origine suggerite per gli oggetti non risolti. Il job traduce anche il tuo SQL, quindi non hai bisogno di un job separato.
gcloud
Il comando
gcloud alpha bq translation generate-source-ddl
legge l'SQL di origine e restituisce le istruzioni DDL di origine suggerite:
gcloud alpha bq translation generate-source-ddl \
  --source-dialect=SOURCE_DIALECT \
  --target-dialect=TARGET_DIALECT \
  --location=LOCATION \
  --source-gcs-uris=SOURCE_URI \
  --target-gcs-path=TARGET_URI
Sostituisci SOURCE_URI con la directory Cloud Storage
che contiene i file SQL di origine e
TARGET_URI con la directory Cloud Storage
che riceve le istruzioni DDL generate. Gli altri segnaposto sono gli stessi descritti in Tradurre i metadati.
Per generare suggerimenti nell'ambito di un job di traduzione, aggiungi il
flag --enable-ai-suggestion al
comando translate-batch.
Puoi quindi fornire le istruzioni DDL generate come input a un successivo
job di traduzione per migliorare la qualità della traduzione. Per saperne di più, consulta
Problemi di traduzione di RelationNotFound o AttributeNotFound.
Esplora l'output della traduzione
Puoi esaminare i risultati di un job di traduzione nella console Cloud de Confiance , indipendentemente dal fatto che il job sia stato inviato dalla riga di comando o dalla console Cloud de Confiance . Il traduttore SQL batch genera i seguenti file nella destinazione specificata:
- I file tradotti.
- Il report di riepilogo della traduzione in formato CSV.
- I file di suggerimenti dell'AI.
Output della consoleCloud de Confiance
Per visualizzare i dettagli del lavoro di traduzione:
Nella console Cloud de Confiance , vai alla pagina SQL Translation.
Nell'elenco dei job di traduzione, individua quello di cui vuoi visualizzare i dettagli. Poi, fai clic sul nome del job di traduzione. Puoi visualizzare una visualizzazione Sankey che illustra la qualità complessiva del job, il numero di righe di codice di input (escluse le righe vuote e i commenti) e un elenco dei problemi che si sono verificati durante il processo di traduzione. Devi dare la priorità alle correzioni da sinistra a destra. I problemi in una fase iniziale possono causare ulteriori problemi nelle fasi successive.
Tieni il puntatore sopra le barre di errore o avviso ed esamina i suggerimenti per determinare i passaggi successivi per il debug del job di traduzione.
Seleziona la scheda Riepilogo log per visualizzare un riepilogo dei problemi di traduzione, incluse le categorie di problemi, le azioni suggerite e la frequenza con cui si è verificato ciascun problema. Puoi fare clic sulle barre della visualizzazione Sankey per filtrare i problemi. Puoi anche selezionare una categoria di problemi per visualizzare i messaggi di log associati a quella categoria.
Seleziona la scheda Messaggi di log per visualizzare ulteriori dettagli su ogni problema di traduzione, tra cui la categoria del problema, il messaggio di errore specifico e un link al file in cui si è verificato il problema. Puoi fare clic sulle barre della visualizzazione Sankey per filtrare i problemi. Puoi selezionare un problema nella scheda Messaggio di log per aprire la scheda Codice che mostra il file di input e di output, se applicabile.
Fai clic sulla scheda Dettagli job per visualizzare i dettagli di configurazione del job di traduzione.
Rapporto riepilogativo
Il report di riepilogo è un file CSV che contiene una tabella di tutti i messaggi di avviso ed errore riscontrati durante il job di traduzione.
Per visualizzare il file di riepilogo nella console Cloud de Confiance , segui questi passaggi:
Nella console Cloud de Confiance , vai alla pagina SQL Translation.
Nell'elenco dei job di traduzione, individua quello che ti interessa, quindi fai clic sul nome del job o su Altre opzioni > Mostra dettagli.
Nella scheda Dettagli job, nella sezione Report di traduzione, fai clic su translation_report.csv.
Nella pagina Dettagli oggetto, fai clic sul valore nella riga URL di autenticazione per visualizzare il file nel browser.
La tabella seguente descrive le colonne del file di riepilogo:
| Colonna | Descrizione |
|---|---|
| Timestamp | Il timestamp in cui si è verificato il problema. |
| FilePath | Il percorso del file di origine a cui è associato il problema. |
| FileName | Il nome del file di origine a cui è associato il problema. |
| ScriptLine | Il numero di riga in cui si è verificato il problema. |
| ScriptColumn | Il numero di colonna in cui si è verificato il problema. |
| TranspilerComponent | Il componente interno del motore di traduzione in cui si è verificato l'avviso o l'errore. Questa colonna potrebbe essere vuota. |
| Ambiente | L'ambiente dialetto di traduzione associato all'avviso o all'errore. Questa colonna potrebbe essere vuota. |
| ObjectName | L'oggetto SQL nel file di origine associato all'avviso o all'errore. Questa colonna potrebbe essere vuota. |
| Gravità | La gravità del problema, avviso o errore. |
| Categoria | La categoria di problemi di traduzione. |
| SourceType | L'origine del problema. Il valore in questa colonna può essere
SQL, che indica un problema nei file SQL di input, oppure
METADATA, che indica un problema nel pacchetto di metadati. |
| Messaggio | Il messaggio di avviso o di errore relativo al problema di traduzione. |
| ScriptContext | Lo snippet SQL nel file di origine associato al problema. |
| Azione | L'azione che ti consigliamo di intraprendere per risolvere il problema. |
Scheda Codice
La scheda Codice ti consente di esaminare ulteriori informazioni sui file di input e di output per un determinato job di traduzione. Nella scheda del codice puoi esaminare i file utilizzati in un job di traduzione, rivedere un confronto fianco a fianco di un file di input e della relativa traduzione per eventuali imprecisioni e visualizzare i riepiloghi e i messaggi dei log per un file specifico in un job.
Per accedere alla scheda del codice:
Nella console Cloud de Confiance , vai alla pagina SQL Translation.
Nell'elenco dei job di traduzione, individua quello che ti interessa, quindi fai clic sul nome del job o su Altre opzioni > Mostra dettagli.
Seleziona la scheda Codice. La scheda Codice è costituita dai seguenti riquadri:
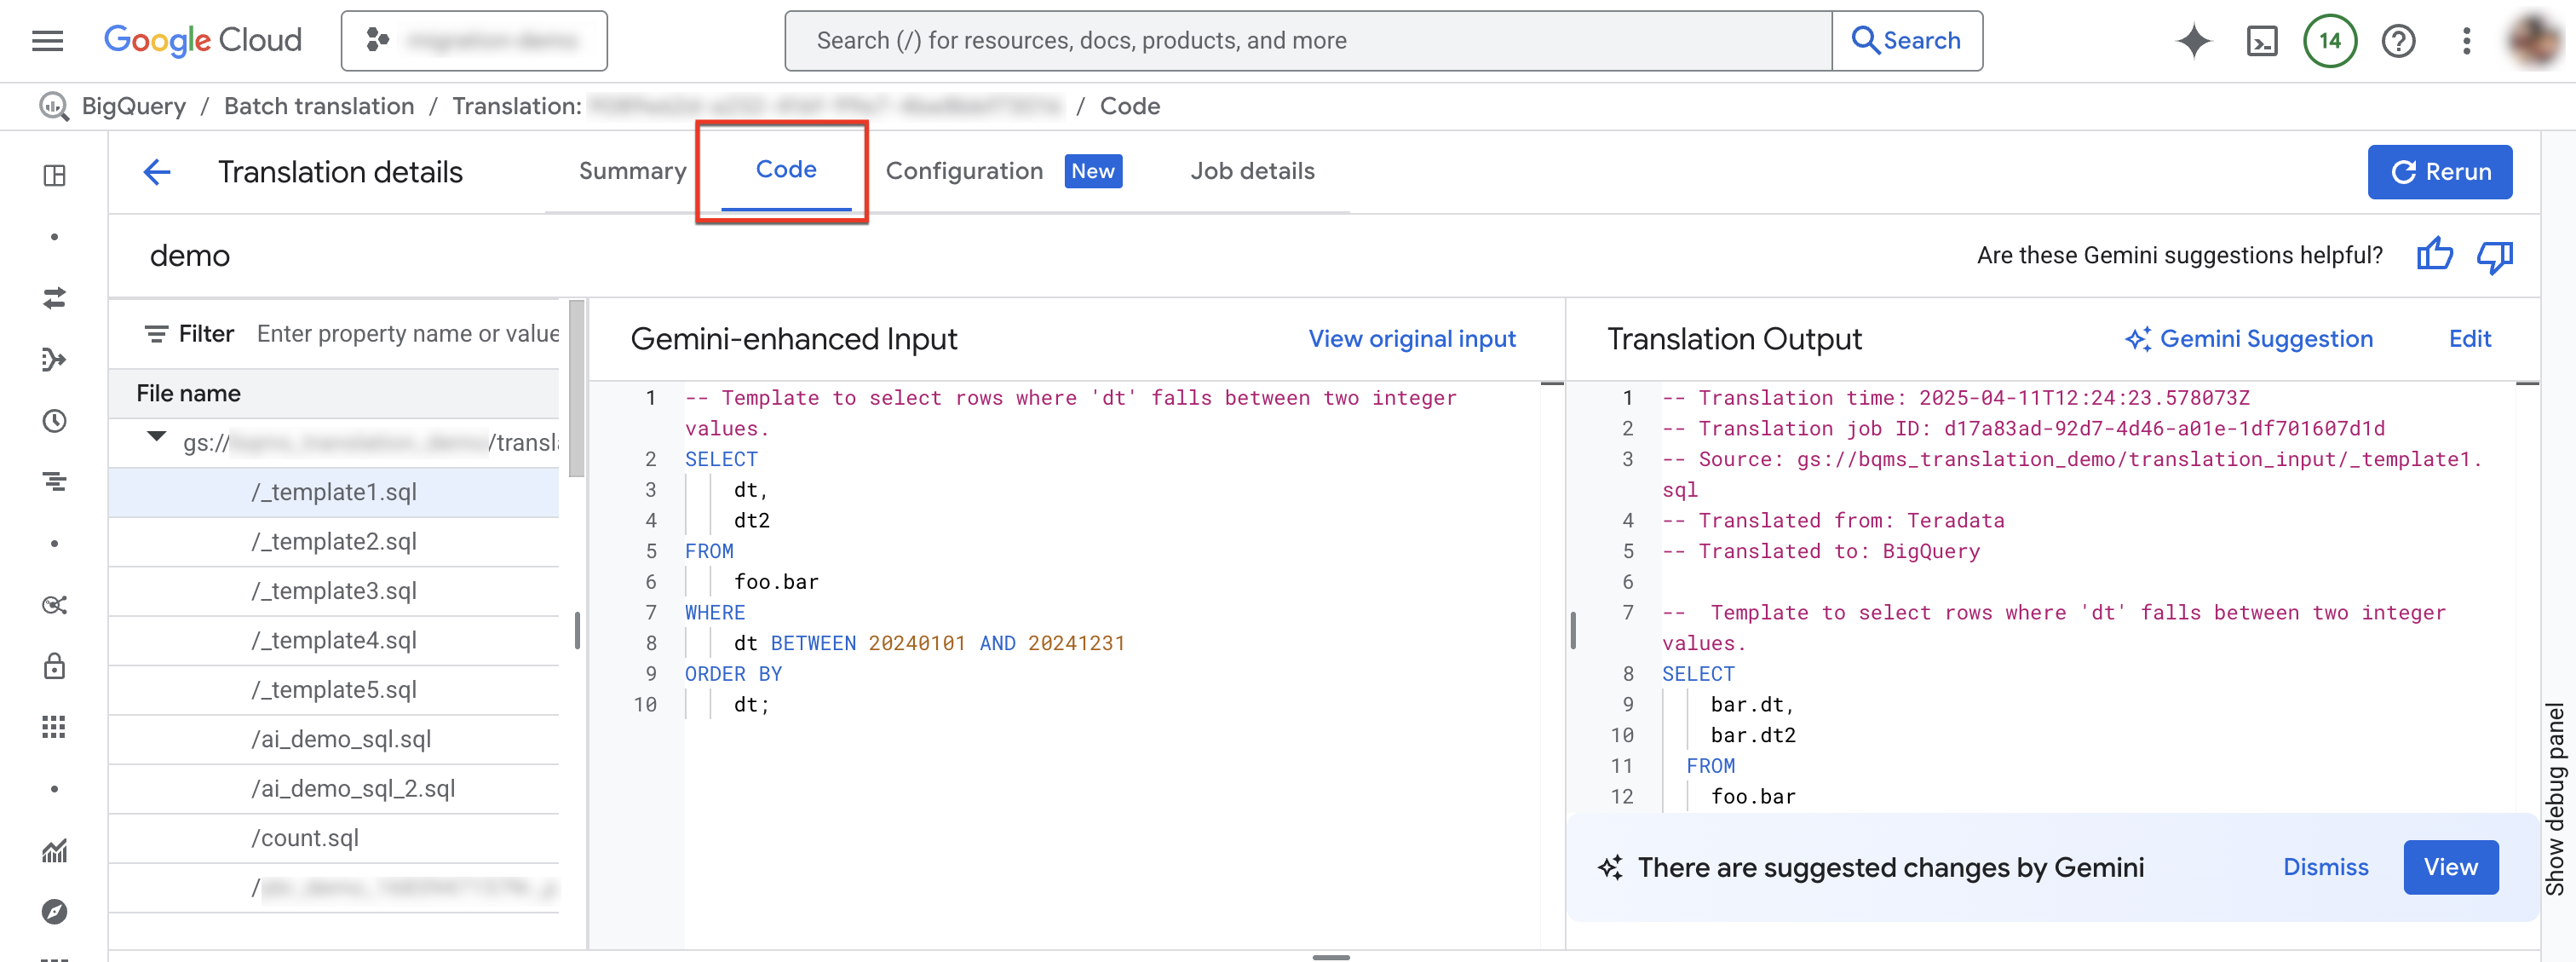
- Esplora file: contiene tutti i file SQL utilizzati per la traduzione. Fai clic su un file per visualizzare l'input e l'output della traduzione, nonché eventuali problemi di traduzione.
- Input ottimizzato con Gemini: l'SQL di input tradotto dal motore di traduzione. Se hai specificato regole di personalizzazione di Gemini per l'SQL di origine nella configurazione di Gemini, il traduttore trasforma prima l'input originale e poi traduce l'input ottimizzato con Gemini. Per visualizzare l'input originale, fai clic su Visualizza input originale.
- Output della traduzione: il risultato della traduzione. Se hai specificato regole di personalizzazione di Gemini per l'SQL di destinazione nella configurazione di Gemini, la trasformazione viene applicata al risultato tradotto come output ottimizzato con Gemini. Se è disponibile un output migliorato con Gemini, puoi fare clic sul pulsante Suggerimento di Gemini per esaminarlo.
(Facoltativo) Per visualizzare un file di input e il relativo file di output nel traduttore SQL interattivo di BigQuery, fai clic su Modifica. Puoi modificare i file e salvare il file di output di nuovo in Cloud Storage.
Scheda Configurazione
Puoi aggiungere, rinominare, visualizzare o modificare i file YAML di configurazione nella scheda Configurazione. Esplora schema mostra la documentazione per i tipi di configurazione supportati per aiutarti a scrivere i file YAML di configurazione. Dopo aver modificato i file YAML di configurazione, puoi eseguire di nuovo il job per utilizzare la nuova configurazione.
Per accedere alla scheda di configurazione:
Nella console Cloud de Confiance , vai alla pagina SQL Translation.
Nell'elenco dei job di traduzione, individua quello che ti interessa, quindi fai clic sul nome del job o su Altre opzioni > Mostra dettagli.
Nella finestra Dettagli traduzione, fai clic sulla scheda Configurazione.
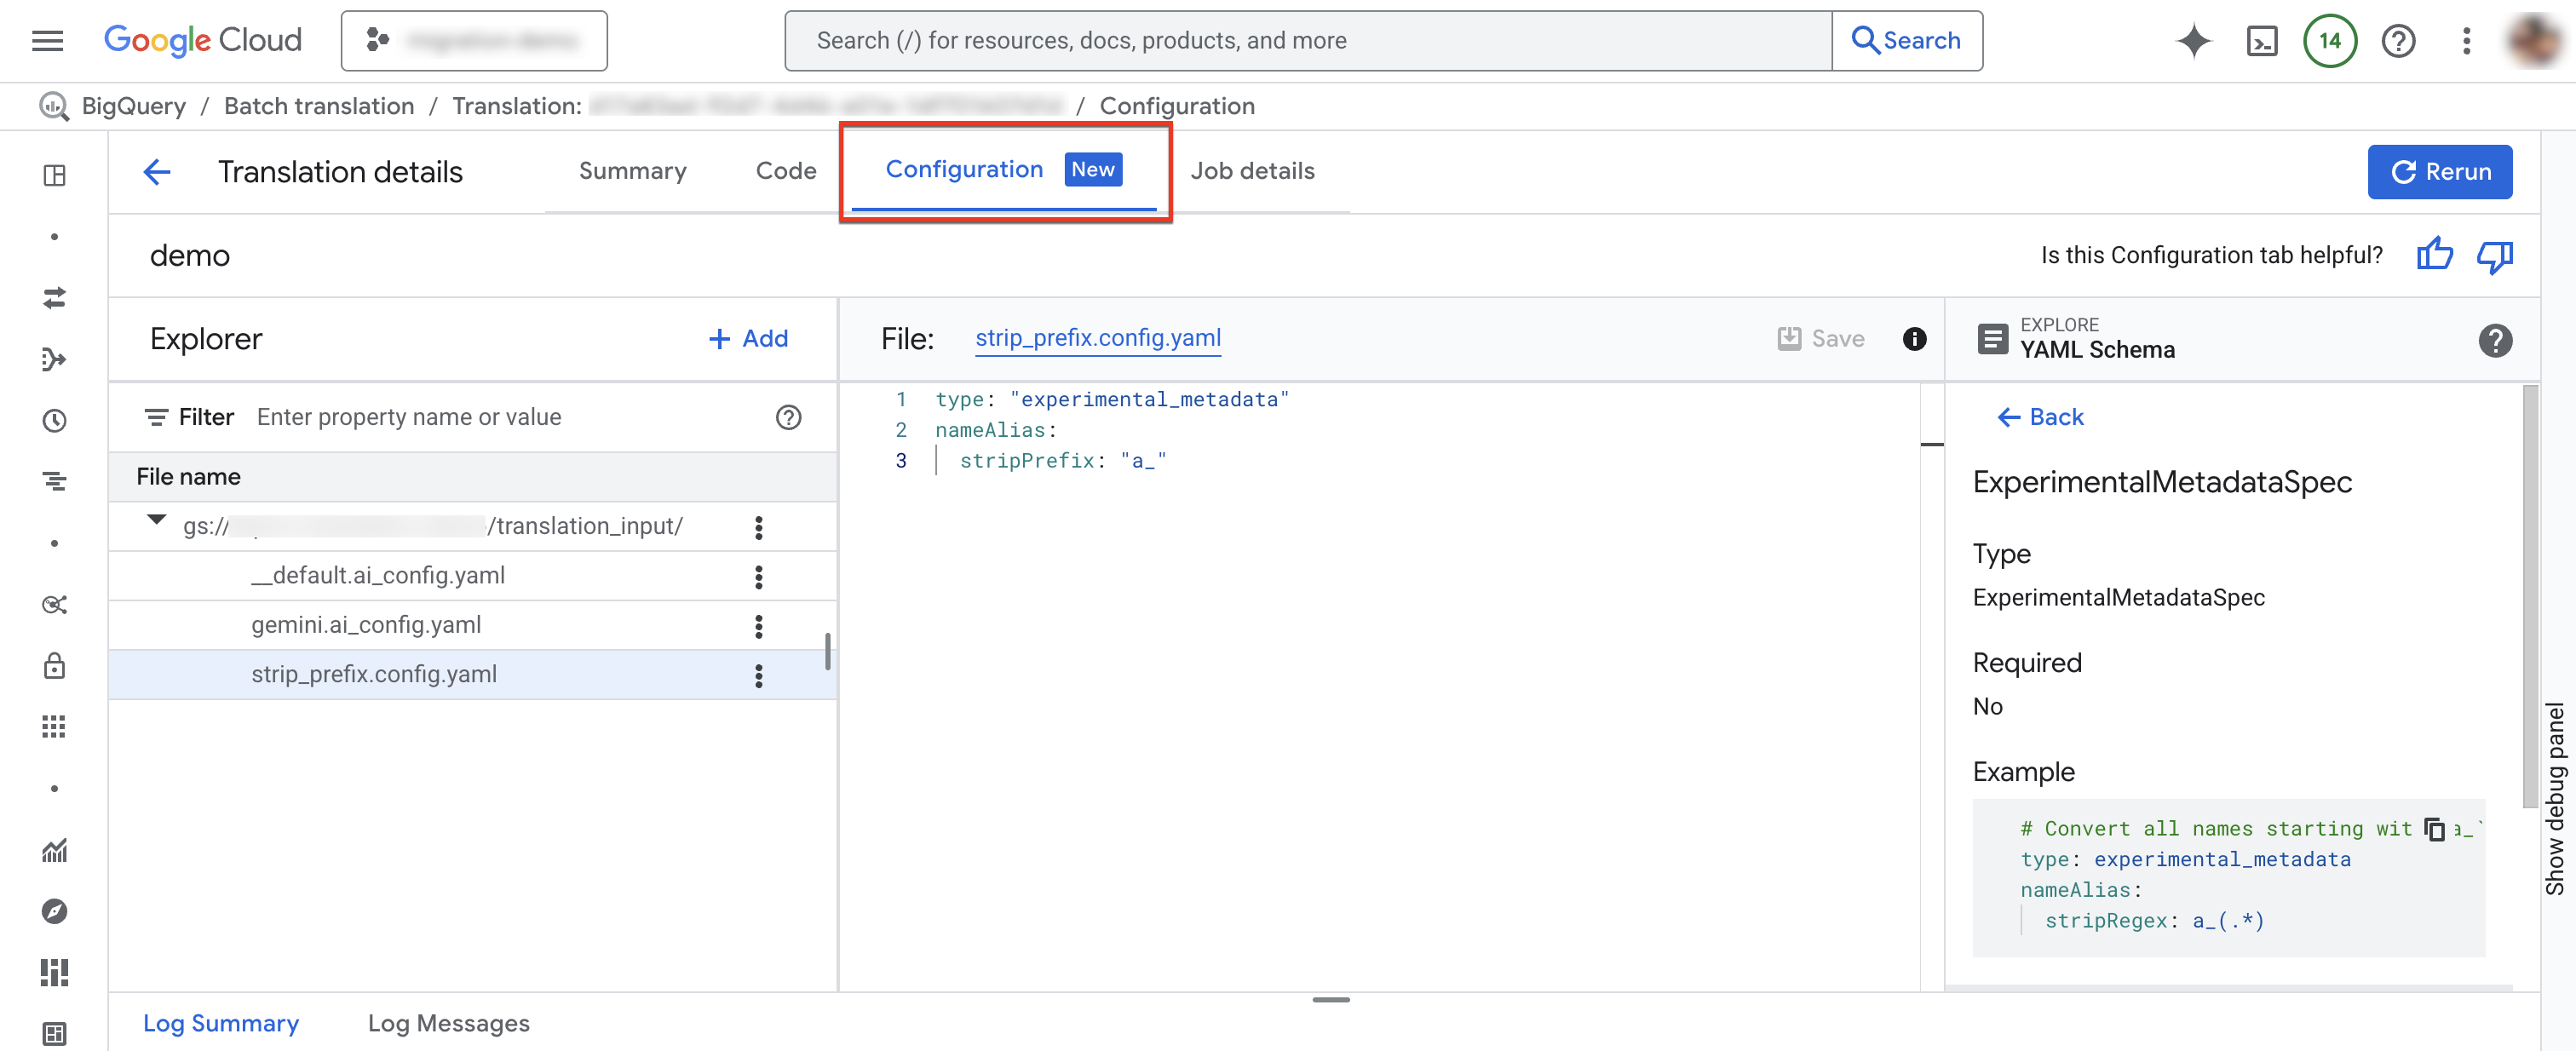
Per aggiungere un nuovo file di configurazione:
- Fai clic su more_vert Altre opzioni > Crea file YAML di configurazione.
- Viene visualizzato un riquadro in cui puoi scegliere il tipo, la posizione e il nome del nuovo file YAML di configurazione.
- Fai clic su Crea.
Per modificare un file di configurazione esistente:
- Fai clic sul file YAML di configurazione.
- Modifica il file, quindi fai clic su Salva.
- Fai clic su Esegui di nuovo per eseguire un nuovo job di traduzione che utilizza i file YAML di configurazione modificati.
Puoi rinominare un file di configurazione esistente facendo clic su more_vert Altre opzioni > Rinomina.
File tradotti
Per ogni file di origine, viene generato un file di output corrispondente nel percorso di destinazione. Il file di output contiene la query tradotta.
Gestione delle funzioni SQL non supportate con le funzioni definite dall'utente di assistenza
Quando traduci SQL da un dialetto di origine a BigQuery, alcune funzioni potrebbero non avere un equivalente diretto. Per risolvere questo problema, BigQuery Migration Service (e la community BigQuery più ampia) forniscono funzioni definite dall'utente (UDF) di assistenza che replicano il comportamento di queste funzioni del dialetto di origine non supportate.
Queste UDF si trovano spesso nel set di dati pubblico bqutil, consentendo alle query tradotte di farvi riferimento inizialmente utilizzando il formato bqutil.<dataset>.<function>(). Ad esempio: bqutil.fn.cw_count().
Considerazioni per gli ambienti di produzione
Sebbene bqutil offra un accesso comodo a queste UDF helper per la traduzione e il test iniziali, l'utilizzo diretto di bqutil per i workload di produzione non è consigliato per i seguenti motivi:
- Controllo della versione: il progetto
bqutilospita l'ultima versione di queste UDF, il che significa che le loro definizioni possono cambiare nel tempo. L'utilizzo diretto dibqutilpotrebbe comportare un comportamento imprevisto o modifiche che causano errori nelle query di produzione se la logica di una UDF viene aggiornata. - Isolamento delle dipendenze: il deployment delle UDF nel tuo progetto isola l'ambiente di produzione da modifiche esterne.
- Personalizzazione: potresti dover modificare o ottimizzare queste UDF per adattarle meglio alla tua logica di business o ai tuoi requisiti di rendimento specifici. Questo è possibile solo se si trovano all'interno del tuo progetto.
- Sicurezza e governance: le norme di sicurezza della tua organizzazione potrebbero limitare
l'accesso diretto a set di dati pubblici come
bqutilper l'elaborazione dei dati di produzione. La copia delle UDF nell'ambiente controllato è in linea con queste norme.
Deployment delle UDF helper nel progetto
Per darti il controllo completo su versione, personalizzazione e accesso alle funzioni definite dall'utente, ti consigliamo di eseguire il deployment delle funzioni helper definite dall'utente nel tuo progetto e nel tuo set di dati per un utilizzo di produzione affidabile e stabile. Per saperne di più sugli script e sui passaggi necessari per il deployment delle UDF helper nel tuo ambiente, consulta Deployment delle UDF.
Risoluzione dei problemi
Questa sezione descrive come eseguire il debug delle singole query e come risolvere gli errori di traduzione più comuni.
Esegui il debug delle query SQL tradotte in batch con il traduttore SQL interattivo
Puoi utilizzare il traduttore SQL interattivo di BigQuery per esaminare o eseguire il debug di una query SQL utilizzando le stesse informazioni di mapping di metadati o oggetti del database di origine. Dopo aver completato un job di traduzione batch, BigQuery genera un ID configurazione di traduzione che contiene informazioni sui metadati del job, sul mapping degli oggetti o sul percorso di ricerca dello schema, a seconda dei casi per la query. Utilizzi l'ID configurazione della traduzione batch con il traduttore SQL interattivo per eseguire query SQL con la configurazione specificata.
Puoi eseguire il debug delle query SQL tradotte in batch utilizzando la consoleCloud de Confiance o gcloud CLI. Seleziona una delle seguenti opzioni:
Console
Per avviare una traduzione SQL interattiva utilizzando un ID configurazione di traduzione batch, segui questi passaggi:
Nella console Cloud de Confiance , vai alla pagina SQL Translation.
Nell'elenco dei lavori di traduzione, individua quello che ti interessa, quindi fai clic su Altre opzioni > Apri traduzione interattiva.
Il traduttore SQL interattivo di BigQuery ora si apre con l'ID configurazione di traduzione batch corrispondente. Per visualizzare l'ID configurazione della traduzione per la traduzione interattiva, fai clic su Strumenti > Traduzione query > Impostazioni di traduzione nel traduttore SQL interattivo.
Per eseguire il debug di un file di traduzione batch nel traduttore SQL interattivo:
Nella console Cloud de Confiance , vai alla pagina SQL Translation.
Nell'elenco dei job di traduzione, individua quello che ti interessa, quindi fai clic sul nome del job o su Altre opzioni > Mostra dettagli.
Nella finestra Dettagli traduzione, fai clic sulla scheda Codice.
In Esplora file, fai clic sul nome del file per aprirlo.
Accanto al nome del file di output, fai clic su Modifica per aprire i file nel traduttore SQL interattivo (anteprima).
Vedi i file di input e output compilati nel traduttore SQL interattivo, che ora utilizza l'ID configurazione della traduzione batch corrispondente.
Per salvare il file di output modificato in Cloud Storage, nel traduttore SQL interattivo fai clic su Salva > Salva in GCS.
gcloud
Per ritradurre e ispezionare una singola query senza aprire la
consoleCloud de Confiance , utilizza il
comando gcloud alpha bq translation translate.
Questa opzione è utile quando hai ridotto un problema di traduzione batch a una
query e vuoi iterarla localmente.
gcloud alpha bq translation translate \
  --source-dialect=SOURCE_DIALECT \
  --target-dialect=TARGET_DIALECT \
  --location=LOCATION \
  --input-file=INPUT_FILE \
  --output-file=OUTPUT_FILE \
  --translation-log-file=LOG_FILE \
  --explanation-output-file=EXPLANATION_FILE
Sostituisci quanto segue:
INPUT_FILE: il file locale contenente la query da tradurre. Se ometti questo flag, il comando legge la query dall'input standard.OUTPUT_FILE: il file locale che riceve la query tradotta. Se ometti questo flag, il comando scrive la query nell'output standard.LOG_FILE: il file YAML locale che riceve i log di traduzione, che contengono gli stessi messaggi di problema visualizzati dalla consoleCloud de Confiance nella scheda Messaggi di log.EXPLANATION_FILE: il file locale che riceve una spiegazione della traduzione generata da Gemini.
Per riutilizzare i metadati del job batch in modo che la query risolva gli stessi
oggetti, aggiungi il flag --metadata-gcs-uri. Per saperne di più, consulta
Tradurre una query in GoogleSQL.
Risolvere gli errori di traduzione
Le sezioni seguenti descrivono gli errori più comuni riscontrati durante l'utilizzo del traduttore SQL batch.
Problemi di traduzione di RelationNotFound o AttributeNotFound
Dopo aver tradotto una query utilizzando il
traduttore SQL batch,
potresti riscontrare una traduzione non riuscita con l'errore RelationNotFound o
AttributeNotFound.
Puoi trovare le traduzioni non riuscite andando alla pagina Dettagli traduzione in BigQuery nella console Cloud de Confiance e aprendo la scheda Messaggi di log.
La traduzione funziona meglio con DDL di metadati. Quando non è possibile trovare le definizioni degli oggetti SQL, il motore di traduzione genera problemi RelationNotFound o AttributeNotFound. Ti consigliamo di utilizzare lo strumento di estrazione dei metadati per generare pacchetti di metadati
per assicurarti che siano presenti tutte le definizioni degli oggetti. L'aggiunta di metadati è il
primo passaggio consigliato per risolvere la maggior parte degli errori di traduzione, perché questo passaggio
spesso corregge molti altri errori causati indirettamente dalla mancanza di metadati.
Per saperne di più, consulta Generare metadati per la traduzione e la valutazione.
Risolvere i problemi di traduzione con Gemini
Per correggere i lavori di traduzione non riusciti con gli errori RelationNotFound o
AttributeNotFound, puoi anche utilizzare Gemini per risolvere questi
problemi:
- Vai alla pagina Dettagli traduzione e apri la scheda Messaggi di log.
- Fai clic sulla query con il messaggio
RelationNotFoundoAttributeNotFoundnella colonna Categoria. Per andare al file e alla riga contenenti l'errore nella scheda Codice, fai clic su
messaggio di errore.
Nella colonna Azione, fai clic su Correzione suggerita.
Seleziona una delle seguenti opzioni, Applica o Applica ed esegui di nuovo:
- Per copiare il file dello schema generato dalla directory di output alla directory di input, fai clic su Applica.
- Per copiare il file dello schema generato dalla directory di output alla directory di input e aprire una finestra di ripetizione, fai clic su Applica ed esegui di nuovo.
Quota e limiti
- Si applicano le quote dell'API BigQuery Migration.
- Ogni progetto può avere al massimo 10 attività di traduzione attive.
- Sebbene non esista un limite rigido al numero totale di file di origine e metadati, ti consigliamo di mantenere il numero di file inferiore a 1000 per ottenere prestazioni migliori.
Prezzi
L'utilizzo del traduttore SQL batch non prevede costi. Tuttavia, lo spazio di archiviazione utilizzato per archiviare i file di input e di output comporta le normali tariffe. Per ulteriori informazioni, consulta la sezione Prezzi dello spazio di archiviazione.
Strumenti a riga di comando per workflow di migrazione alternativi
Puoi anche inviare un job di traduzione batch utilizzando un file di configurazione della traduzione con Google Cloud CLI (gcloud bq migration-workflows) o con lo strumento a riga di comando bq.
Questi passaggi presuppongono che tu abbia caricato i file delle fonti in un bucket Cloud Storage.
Crea un file di configurazione della traduzione
Un file di configurazione della traduzione definisce il percorso dei file di origine, la destinazione di output e i dialetti di origine e di destinazione della traduzione. Puoi scrivere questo file in formato YAML o JSON.
Il seguente esempio mostra un file YAML di configurazione della traduzione per una traduzione da Teradata a BigQuery:
tasks:
  translation_task:
    type: Teradata2BigQuery_Translation
    translationDetails:
      sourceTargetMapping:
      - sourceSpec:
          baseUri: gs://bq-translations/input
        targetSpec:
          relativePath: output
      targetBaseUri: gs://bq-translations
      targetTypes:
      - sql
      sourceEnvironment:
        defaultDatabase: default_db
        schemaSearchPath:
        - foo
L'esempio seguente mostra un file JSON di configurazione della traduzione per una traduzione da Teradata a BigQuery:
{
  "tasks": {
    "translation_task": {
      "type": "Teradata2BigQuery_Translation",
      "translationDetails": {
        "sourceTargetMapping": [
          {
            "sourceSpec": {
              "literal": {
                "literalString": "sel 1",
                "relativePath": "my_input_1"
              },
              "encoding": "UTF-8"
            }
          },
          {
            "sourceSpec": {
              "literal": {
                "literalString": "sel 2",
                "relativePath": "my_input_2"
              },
              "encoding": "UTF-8"
            }
          }
        ],
        "targetReturnLiterals": [
          "sql/my_input_1",
          "sql/my_input_2"
        ]
      }
    }
  }
}
Inviare e gestire i job di traduzione
Utilizza uno dei seguenti strumenti a riga di comando per inviare e gestire i tuoi job di traduzione.
gcloud
Per creare un job di traduzione ed eseguire il flusso di lavoro, utilizza questo comando:
gcloud bq migration-workflows create --location=LOCATION --config-file=CONFIG_FILE
Per creare ed eseguire il flusso di lavoro e tornare immediatamente con un link al
flusso di lavoro, aggiungi il flag --async:
gcloud bq migration-workflows create --location=LOCATION --config-file=CONFIG_FILE --async
Per elencare i tuoi progetti di traduzione, utilizza il seguente comando:
gcloud bq migration-workflows list --location=LOCATION
Per visualizzare i dettagli di uno specifico job di traduzione, utilizza questo comando:
gcloud bq migration-workflows describe projects/PROJECT_ID/locations/LOCATION/workflows/WORKFLOW_ID
Sostituisci quanto segue:
LOCATION: la posizione del progetto Cloud de Confiance by S3NS che esegue questo job di traduzione.CONFIG_FILE: il percorso del file di configurazione della traduzione.PROJECT_ID: l'ID del progetto Cloud de Confiance by S3NS che esegue questo job di traduzione.WORKFLOW_ID: l'ID del job di traduzione.
bq
Per eseguire il job di traduzione, utilizza questo comando:
bq mk --migration_workflow --location=LOCATION --config_file=CONFIG_FILE
Per elencare tutti i tuoi progetti di traduzione, utilizza il seguente comando:
bq ls --migration_workflow --location=LOCATION
Per visualizzare i dettagli di uno specifico job di traduzione, utilizza il seguente comando:
bq show --migration_workflow projects/PROJECT_ID/locations/LOCATION/workflows/WORKFLOW_ID
Per rimuovere un job di traduzione dall'elenco, utilizza questo comando:
bq rm --migration_workflow projects/PROJECT_ID/locations/LOCATION/workflows/WORKFLOW_ID
Sostituisci quanto segue:
LOCATION: la posizione del progetto Cloud de Confiance by S3NS che esegue questo job di traduzione.CONFIG_FILE: il percorso del file di configurazione della traduzione.PROJECT_ID: l'ID del progetto Cloud de Confiance by S3NS che esegue questo job di traduzione.WORKFLOW_ID: l'ID del job di traduzione.
Recuperare i file di output
Per scaricare i file di output al termine del job, utilizza gcloud storage cp come descritto in Recuperare i file di output. Per esaminare il
job nella console Cloud de Confiance , consulta Esplorare l'output
della traduzione.
Passaggi successivi
Scopri di più sui seguenti passaggi della migrazione del data warehouse: