

会話でデータを分析する
このドキュメントでは、BigQuery で会話を作成、編集、エクスポート、削除する方法について説明します。会話とは、選択したデータ エージェントまたはデータソース(テーブル、ビュー やグラフなど)との永続化されたチャットです。
会話とは、データ エージェントまたはデータソースとの永続化されたチャットです。ユーザーは、テーブル フィールド名を指定したり、データのフィルタ条件を定義したりすることなく、「売上」や「最も人気がある」といった一般的な言葉を使用してデータ エージェントにマルチパートの質問をすることができます。PDF などのオブジェクトに保存されているデータについて質問することもできます。エージェントは、レスポンスを構築する際に、クエリするデータソースを特定し、テーブル パーティションや検索インデックスなどの最適化を利用できます。エージェントは、列値の既存のエンベディングを使用して、質問を適切なデータに対応付けることができます。たとえば、「Texas」について質問すると、「TX」として保存されている行が検索されます。
返されるチャット レスポンスには、次の機能があります。
- 質問への回答をテキスト、コード、画像(マルチモーダル)で表示します。回答には、サポートされている BigQuery AI 関数と ML 関数を含めることができます。
- 必要に応じてグラフを生成します。
- 結果の背後にあるエージェントの推論。
- 使用されたエージェントやデータソースなど、会話に関するメタデータ。
データソースとの直接会話を作成すると、 Conversational Analytics API は、 データエージェントから提供されるコンテキストと処理の指示を使用せずにユーザーからの質問を解釈します。そのため、直接会話の結果は正確さが低い可能性があります。正確さが求められる場合は、データ エージェントを使用してください。
BigQuery で会話を作成して管理するには、 Cloud de Confiance コンソールを使用します。詳細については、会話でデータを分析するをご覧ください。
始める前に
-
Cloud de Confiance プロジェクトに対して課金が有効になっていることを確認します。
-
BigQuery API、Gemini データ分析 API、Gemini for Cloud de Confiance by S3NS API が有効になっていない場合は、有効にします。
API を有効にするために必要なロール
API を有効にするには、
serviceusage.services.enable権限が必要です。プロジェクトを作成した場合は、オーナーロール(roles/owner)を介してこの権限が付与されている可能性があります。それ以外の場合は、Service Usage 管理者ロール(roles/serviceusage.serviceUsageAdmin)を介してこの権限を取得できます。ロールを付与する方法をご確認ください。
必要なロール
会話を作成するには、次のいずれかの Conversational Analytics API IAM ロールが必要です。
- 共有されているデータ エージェントとの会話を表示および作成するには、プロジェクト レベルで Gemini データ分析データ エージェント ユーザー(
roles/geminidataanalytics.dataAgentUser)ロールと Gemini for Google Cloud ユーザー(roles/cloudaicompanion.user)ロールが必要です。 - 直接会話を作成するには、Gemini データ分析 Stateless Chat User(
roles/geminidataanalytics.dataAgentStatelessUser)ロールが必要です。
また、次のような場合は、次のロールが必要です。
- データ エージェントがデータセットをナレッジソースとして使用する場合は、データセットに対する
BigQuery データ閲覧者
(
roles/bigquery.dataViewer)ロールが必要です。 - データ エージェントが SQL クエリを実行する場合は、プロジェクトに対する
BigQuery ジョブユーザー
(
roles/bigquery.jobUser)ロールが必要です。 - データ エージェントがテーブルまたはビューをナレッジソースとして使用する場合は、テーブルまたはビューに対する
BigQuery データ閲覧者
(
roles/bigquery.dataViewer)ロールが必要です。 - テーブルで列レベルのアクセス制御を使用している場合は、
きめ細かい読み取り(
roles/datacatalog.categoryFineGrainedReader)ロールが必要です。このロールは、ポリシータグの構成の一環としてプリンシパルに割り当てられます。詳細については、 列レベルのアクセス制御で使用されるロールをご覧ください。 - データテーブルで行レベルのアクセス制御を使用している場合は、その テーブルに対するロールレベルのアクセス ポリシーを介してアクセス権が付与されている必要があります。詳細については、 行レベルのアクセス ポリシーを作成または更新するをご覧ください。
- データテーブルでデータ マスキングを使用している場合は、適切なデータポリシーを介してマスクされた読み取り(
roles/bigquerydatapolicy.maskedReader)ロールが付与されている必要があります。詳細については、マスクされたデータに対してクエリを実行するためのロール をご覧ください。 - データセットまたはプロジェクトと会話するには、プロジェクトに対する
Data Catalog 閲覧者
(
roles/datacatalog.viewer)が必要です。
データ エージェントで使用されるソースデータ テーブルに対する適切なロールがない場合、データ エージェントとチャットすると、次のエラーが返されます。
Schema_Resolution: Access Denied
ベスト プラクティス
会話分析は、ユーザーの質問に答えるために、ユーザーに代わってクエリを自動的に実行します。クエリ費用が増加する可能性がある次の要因を考慮してください。
- テーブルサイズが大きい
- クエリでデータ結合を使用している
- クエリ内で AI 関数を頻繁に呼び出している
データ エージェントとの会話を作成する
データ エージェントとの会話を作成するには、まず データ エージェントを作成して公開します。他のユーザーが共有しているエージェントとの会話を開始することもできます。
Cloud de Confiance コンソールで既存のデータ エージェントとの会話を作成する手順は次のとおりです。
BigQuery の [エージェント] ページに移動します。
[エージェント カタログ] タブを選択します。
[マイ エージェント] セクションまたは [組織内の他のユーザーと共有] セクションで、チャットするエージェントのエージェント カードをクリックします。
新しいチャットパネルが開きます。
[質問する] フィールドに質問を入力し、モードを選択します。
- 高速 (デフォルト): ほとんどの質問に最適です。
- 思考: 詳細な推論。
Gemini が提案した質問のいずれかをクリックして開始することもできます。
[send_spark] [Send] をクリックします。
Conversational Analytics API は質問を処理し、結果を返します。
データソースとの直接会話を作成する
これらの BigQuery データソース(ナレッジソースとも呼ばれます)との直接会話を作成できます。直接会話を作成すると、Conversational Analytics API は、データ エージェントから提供されるコンテキストと処理の指示を使用せずにユーザーからの質問を解釈します。
次のデータソースとの会話を作成できます。
- テーブル
- ビュー
- データセット
- プロジェクト
- グラフ
[エージェント] ページを使用してデータソースと会話する
[エージェント] ページからテーブル、ビュー、グラフとの直接会話を作成する手順は次のとおりです。
BigQuery の [エージェント] ページに移動します。
[会話] タブで、[新しい会話] をクリックします。
[データとチャットする] ペインで、[ナレッジソース] タブをクリックします。データソースがリストに表示されない場合は、検索できます。
1 つ以上のデータソースを選択して、[チャット] をクリックします。
複数のプロジェクトとの直接会話を作成する手順は次のとおりです。
BigQuery の [エージェント] ページに移動します。
[質問する] フィールドに質問を入力します。デフォルトでは、会話は現在のプロジェクト内のすべてのデータソースを参照します。
他のプロジェクトを選択するには、プロジェクト名のプルダウン メニューをクリックして、1 つ以上のプロジェクトを選択します。会話は、選択したプロジェクト内のすべてのデータソースを参照します。
[send_spark] [Send] をクリックします。
選択したプロジェクトで新しい会話が開きます。
BigQuery Studio を使用してデータソースと会話する
BigQuery Studio を使用してデータソースとの直接会話を作成するには、次のいずれかのオプションを選択します。
データセット、テーブル、ビュー、グラフと会話する
データセット、テーブル、ビュー、グラフとの直接会話を作成する手順は次のとおりです。
コンソール Cloud de Confiance で、[BigQuery Studio] ページに移動します。
左側のペインで、 [Explorer] をクリックします。
[**エクスプローラ**] ペインでプロジェクトを開き、[**データセット**] をクリックして、 データセットを選択します。[データセット] ページが開きます。
データセットをクリックして開きます。
データセットとチャットするには、[chat_spark] [チャット] をクリックします。
データセット内のテーブルまたはビューとチャットする手順は次のとおりです。
[概要] タブで、[テーブル] をクリックします。
[テーブル ID] 列で、テーブルまたはビューへのリンクをクリックします。
[chat_spark] [Chat] をクリックします。
グラフとチャットする手順は次のとおりです。
[概要] タブで、[グラフ] をクリックします。
[グラフ ID] 列で、グラフへのリンクをクリックします。
[chat_spark] [Chat] をクリックします。
データセット
データセットとの会話を作成すると、データソースを明示的に一覧表示しなくても、データに関する質問をすることができます。データセットとの会話を作成すると、データ エージェントはそのデータセット内のすべてのテーブルにアクセスできます。質問すると、データ エージェントは関連するテーブルを探し、必要に応じて結合して回答を生成します。
クエリ結果と会話する
クエリを実行した後、結果を使用して新しい会話を作成できます。 データソースは、通常 24 時間保持されるキャッシュされた結果 の一時テーブルです。キャッシュされた結果が期限切れになると、データについて質問することはできません。
クエリ結果から会話を作成する手順は次のとおりです。
コンソール Cloud de Confiance で、[BigQuery Studio] ページに移動します。
search_insights クエリエディタ タブに切り替えるか、arrow_drop_down > [SQL クエリ] をクリックします。
SQL クエリを入力して、 [play_circle] [実行] をクリックします。
[結果] タブで、[chat_spark チャット] をクリックします。
データソースと会話する方法
データソースの [チャット] オプションをクリックすると、会話を開始できます。会話を行うには、次の操作を行います。
[質問する] フィールドに質問を入力し、モードを選択します。
- 高速 (デフォルト): ほとんどの質問に最適です。
- 思考: 詳細な推論。
[send_spark] [Send] をクリックします。
Conversational Analytics API は質問を処理し、結果を返します。 データに適している場合は、レスポンスに画像、グラフ、表、その他の可視化が表示されます。
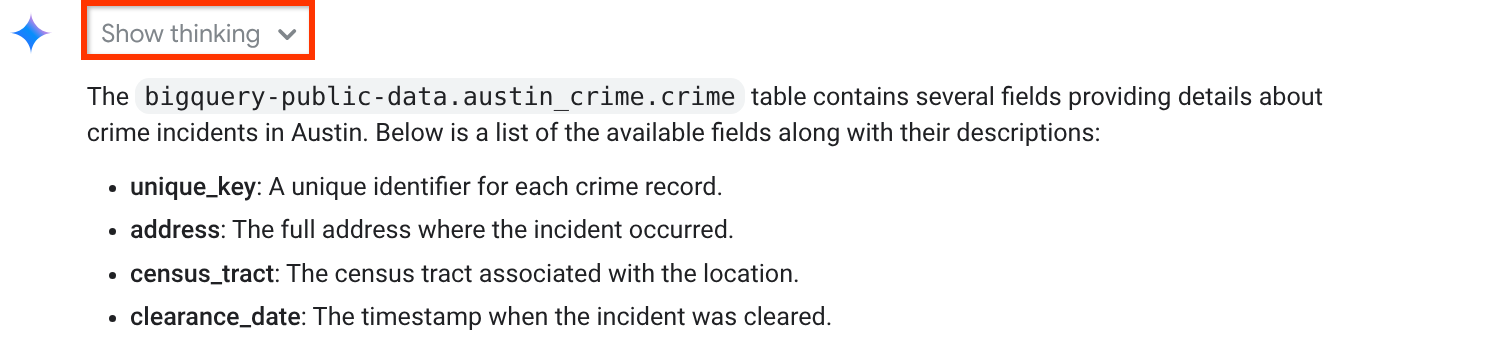
質問への回答を提供するためにデータ エージェントが実行した各ステップを確認するには、レスポンスの [思考を表示] オプションを開きます。
結果の計算方法に関する情報を確認するには、 [計算方法] をクリックします。
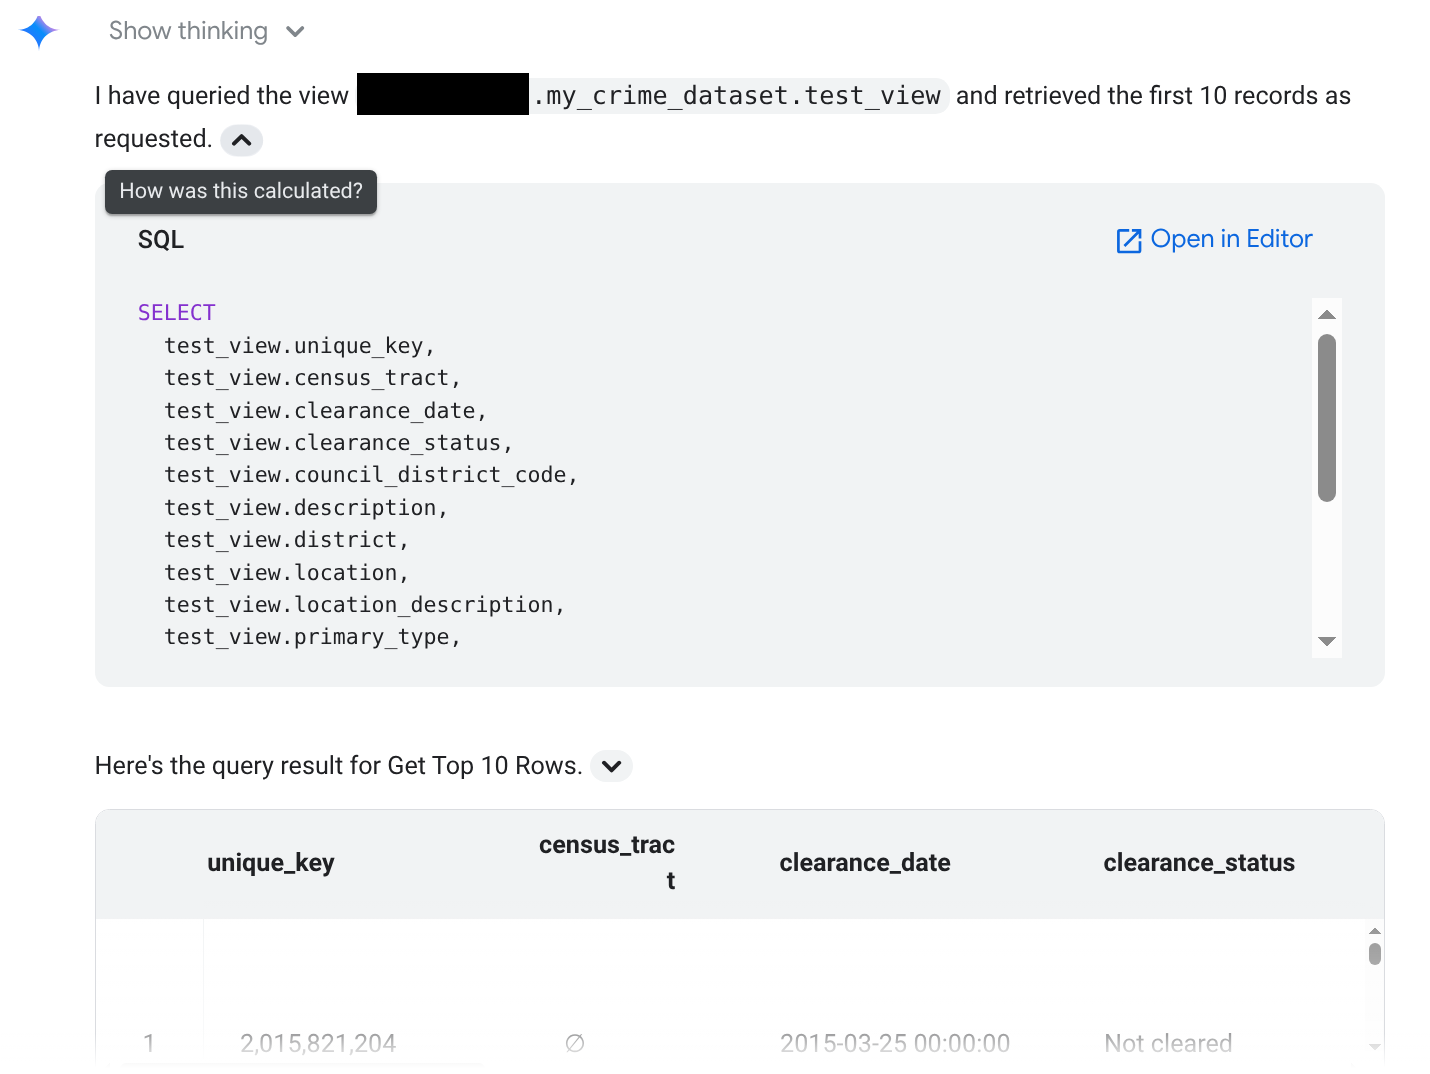
[概要] セクションには、生成されたクエリとクエリ結果が表示されます。必要に応じて、クエリエディタでクエリを開くことができます。
会話からデータ エージェントを作成する
テーブルまたはビューとの会話からデータ エージェントを作成できます。データセットとの会話からカスタム エージェントを作成することはできません。
会話からデータ エージェントを作成する手順は次のとおりです。
会話の [詳細] ペインで、[エージェントを作成] をクリックします。
[エディタ] セクションの [エージェント名] フィールドに、データ エージェントのわかりやすい 名前を入力します(例:
Q4 sales data、User activity logs)。[エージェントの説明] フィールドに、データ エージェントの説明を入力します。適切な説明を付けておくと、エージェントの機能や使用するデータがわかり、チャット相手とするデータ エージェントを選択する際に役立ちます(例:
Ask questions about customer orders and revenue)。[ナレッジソース] セクションで、[ナレッジソース] のエントリを確認します。既存のデータソースをカスタマイズすることも、[ソースを追加] をクリックしてデータソースを追加することもできます。データソースがリストに表示されない場合は、検索できます。
変更を加えたら、[下書きを保存] をクリックします。
[公開] をクリックします。
データ エージェントの回答をエクスポートする
データ エージェントから提供された回答を PDF ファイルまたは CSV ファイルとしてエクスポートする手順は次のとおりです。
保存するエージェントの回答に移動します。
[ Download] ボタンをクリックします。次のいずれかを選択します。
- PDF: テーブルごとに最大 20 行が含まれます。
- 詳細な PDF: テーブルごとに最大 1,000 行が含まれます。
- CSV: テーブルごとに最大 5,000 行が含まれます。
ファイルはブラウザからダウンロードされます。
会話を管理する
[エージェント] ページで会話を開いたり、名前を変更したり、削除したりできます。また、BigQuery Studio エクスプローラで会話を管理することもできます。
既存の会話を開く
コンソール Cloud de Confiance で、BigQuery の [エージェント] ページに移動します。
[会話] タブの会話リストで、開く会話をクリックします。
会話の名前を変更する
コンソール Cloud de Confiance で、BigQuery の [エージェント] ページに移動します。
[会話] タブの会話リストで、名前を変更する会話をクリックします。
[ アクションを表示] > [名前を変更] をクリックします。
[会話の名前を変更する] ダイアログの [会話名] フィールドに、会話の新しい名前を入力します。
[名前を変更] をクリックします。
会話を削除する
会話内の質問の結果は、基盤となるデータソースが削除されても保持されます。会話とそのすべての結果を削除する手順は次のとおりです。
コンソール Cloud de Confiance で、BigQuery の [エージェント] ページに移動します。
[会話] タブの会話リストで、削除する会話をクリックします。
[アクションを表示] > [削除] をクリックします。
[会話を削除しますか?] ダイアログで、[削除] をクリックします。
180 日間会話を更新しないと、BigQuery によって自動的に削除されます。
BigQuery Studio エクスプローラを使用して会話を管理する
BigQuery Studio エクスプローラを使用して会話を管理します。この会話リストは、会話の検索、オープン、作成を一元的に行うことができます。会話 ID をコピーしたり、会話リストを更新したりすることもできます。
会話を管理する手順は次のとおりです。
BigQuery Studio エクスプローラ ページに移動します。
[エクスプローラ] ペインで、プロジェクト名を開きます。
[会話] をクリックします。
- 会話リストをフィルタするには、フィルタ フィールドにプロパティ名または値を入力します。
- 会話を開くには、 [アクションを表示] [>] [開く] をクリックします。
- 会話 ID をコピーするには、 [アクションを表示] > [ID をコピー] をクリックします。
- 会話を作成するには、メニューバーで [会話を作成] をクリックします。
- リストを更新するには、メニューバーで [更新] をクリックします。
次のステップ
- BigQuery の会話型分析について 確認する。
- Conversational Analytics API について確認する。
- データ エージェントを作成する。