

במדריך הזה תשתמשו ב-Hugging Face Optimum CLI כדי לייצא את המודל sentence-transformers/all-MiniLM-L6-v2 לפורמט Open Neural Network Exchange (ONNX). כדי לייבא את מודל ONNX ל-BigQuery, משתמשים בהצהרה CREATE MODEL. ולסיום, משתמשים בפונקציה ML.PREDICT כדי ליצור הטמעות באמצעות מודל ה-ONNX המיובא.
במדריך הזה משתמשים במודל sentence-transformers/all-MiniLM-L6-v2. המודל הזה של טרנספורמר משפטים ידוע בביצועים המהירים והיעילים שלו ביצירת הטמעות של משפטים. הטמעת משפטים מאפשרת לבצע משימות כמו חיפוש סמנטי, קיבוץ ודמיון בין משפטים, על ידי זיהוי המשמעות הבסיסית של הטקסט.
ONNX מספק פורמט אחיד שמיועד לייצג כל מסגרת של למידת מכונה (ML). התמיכה של BigQuery ML ב-ONNX מאפשרת לכם:
- לאמן מודל באמצעות ה-framework המועדף עליכם.
- ממירים את המודל לפורמט ONNX.
- מייבאים את מודל ה-ONNX ל-BigQuery ומבצעים חיזויים באמצעות BigQuery ML.
מטרות
- מייצאים את המודל של
sentence-transformers/all-MiniLM-L6-v2ל-ONNX. - מייבאים את מודל ONNX ל-BigQuery.
- משתמשים בפונקציה
ML.PREDICTכדי ליצור הטמעות באמצעות מודל ה-ONNX המיובא.
עלויות
במסמך הזה משתמשים ברכיבים הבאים של Cloud de Confiance by S3NS, והשימוש בהם כרוך בתשלום:
כשמסיימים את המשימות שמתוארות במסמך הזה אפשר למחוק את המשאבים שיצרתם כדי להימנע מחיובים נוספים. מידע נוסף זמין בקטע הסרת המשאבים.
לפני שמתחילים
-
In the Cloud de Confiance console, on the project selector page, select or create a Cloud de Confiance project.
Roles required to select or create a project
- Select a project: Selecting a project doesn't require a specific IAM role—you can select any project that you've been granted a role on.
-
Create a project: To create a project, you need the Project Creator role
(
roles/resourcemanager.projectCreator), which contains theresourcemanager.projects.createpermission. Learn how to grant roles.
מפעילים את BigQuery API ואת Cloud Storage API, אם הם עדיין לא מופעלים.
התפקידים שנדרשים כדי להפעיל ממשקי API
כדי להפעיל ממשקי API, צריך את ההרשאה
serviceusage.services.enable. אם אתם יצרתם את הפרויקט, סביר להניח שכבר יש לכם את ההרשאה הזו דרך התפקיד "בעלים" (roles/owner). אחרת, אתם יכולים לקבל את ההרשאה הזו דרך התפקיד "אדמין בממשק 'שימוש בשירות'" (roles/serviceusage.serviceUsageAdmin). איך מקצים תפקידים?- מוודאים שיש לכם את ההרשאות הנדרשות כדי לבצע את המשימות שמפורטות במסמך הזה.
התפקידים הנדרשים
כדי לקבל את ההרשאות שדרושות להשלמת המדריך, בקשו מהאדמין להקצות לכם את תפקידי ה-IAM הבאים בפרויקט:
-
יצירת מערכי נתונים, טבלאות ומודלים, והרצת משימות ב-BigQuery:
אדמין ב-BigQuery Studio (
roles/bigquery.studioAdmin) -
יצירת קטגוריה של Cloud Storage ויצירת אובייקטים של אחסון (אם ממירים באופן ידני את קובצי המודל של הטרנספורמר ל-ONNX):
אדמין של Storage (
roles/storage.admin)
להסבר על מתן תפקידים, ראו איך מנהלים את הגישה ברמת הפרויקט, התיקייה והארגון.
יכול להיות שאפשר לקבל את ההרשאות הנדרשות גם באמצעות תפקידים בהתאמה אישית או תפקידים מוגדרים מראש.
אם אתם יוצרים פרויקט חדש, אתם הבעלים של הפרויקט ומוענקות לכם כל ההרשאות הנדרשות בממשק של ניהול הזהויות והרשאות הגישה (IAM) כדי להשלים את המדריך הזה.
למידע נוסף על הרשאות IAM ב-BigQuery, קראו את המאמר הרשאות IAM.
אופציונלי: המרה ידנית של קובצי המודל של הטרנספורמר ל-ONNX
אם אתם ממירים באופן ידני את המודל sentence-transformers/all-MiniLM-L6-v2 ואת ה-tokenizer ל-ONNX, בצעו את השלבים שמפורטים בקטעים הבאים. לחלופין, אתם יכולים להשתמש בקובצי הדוגמה בקטגוריה gs://cloud-samples-data של Cloud Storage.
הקבצים בקטגוריה הזו כבר הומרו. אם אתם משתמשים בקובצי הדוגמה, דלגו אל יצירת מערך נתונים.
אם אתם בוחרים להמיר את הקבצים באופן ידני, אתם צריכים סביבת שורת פקודה מקומית שבה מותקן Python. מידע נוסף על התקנת Python זמין בהורדות של Python.
ייצוא מודל הטרנספורמר ל-ONNX
משתמשים ב-Hugging Face Optimum CLI כדי לייצא את המודל sentence-transformers/all-MiniLM-L6-v2 ל-ONNX.
מידע נוסף על ייצוא מודלים באמצעות Optimum CLI זמין במאמר ייצוא מודל ל-ONNX באמצעות optimum.exporters.onnx.
כדי לייצא את המודל, פותחים סביבת שורת פקודה ופועלים לפי השלבים הבאים:
מתקינים את Optimum CLI:
pip install optimum[onnx]מייצאים את המודל:
optimum-cli export onnx \
    --model sentence-transformers/all-MiniLM-L6-v2 \
    --task sentence-similarity \
    --opset 17 all-MiniLM-L6-v2/
הארגומנט
--modelמציין את מזהה המודל של Hugging Face. הארגומנט--opsetמציין את גרסת הספרייה של ONNXRuntime, והוא מוגדר כ-17כדי לשמור על תאימות עם הספרייה של ONNXRuntime שנתמכת על ידי BigQuery.
קובץ המודל מיוצא לספרייה all-MiniLM-L6-v2 בתור model.onnx.
מחילים קוונטיזציה על מודל הטרנספורמר
כדי להקטין את המודל ולהאיץ את ההסקה, משתמשים ב-Optimum CLI כדי להחיל קוונטיזציה על מודל הטרנספורמר שיוצא. מידע נוסף זמין במאמר קוונטיזציה.
כדי להחיל קוונטיזציה על המודל, מריצים את הפקודה הבאה:
optimum-cli onnxruntime quantize \
    --onnx_model all-MiniLM-L6-v2/ \
    --avx512_vnni -o all-MiniLM-L6-v2_quantized
קובץ המודל המכומת מיוצא לספרייה all-MiniLM-L6-v2_quantized בתור model_quantized.onnx.
המרת ה-tokenizer ל-ONNX
כדי ליצור הטמעות באמצעות מודל טרנספורמר בפורמט ONNX, בדרך כלל משתמשים בכלי ליצירת אסימונים כדי ליצור שני קלטים למודל, input_ids ו-attention_mask.
כדי ליצור את הקלט הזה, ממירים את ה-tokenizer של המודל sentence-transformers/all-MiniLM-L6-v2 לפורמט ONNX באמצעות הספרייה onnxruntime-extensions. אחרי שממירים את ה-tokenizer, אפשר לבצע טוקניזציה ישירות על קלט של טקסט גולמי כדי ליצור חיזויים של ONNX.
כדי להמיר את ה-tokenizer, מבצעים את השלבים הבאים בשורת הפקודה:
מתקינים את Optimum CLI:
pip install optimum[onnx]בכלי לעריכת טקסט שבו אתם משתמשים, יוצרים קובץ בשם
convert-tokenizer.py. בדוגמה הבאה משתמשים בכלי לעריכת טקסט nano:nano convert-tokenizer.pyמעתיקים את הסקריפט הבא ב-Python ומדביקים אותו בקובץ
convert-tokenizer.py:from onnxruntime_extensions import gen_processing_models # Load the Huggingface tokenizer tokenizer = AutoTokenizer.from_pretrained("sentence-transformers/all-MiniLM-L6-v2") # Export the tokenizer to ONNX using gen_processing_models onnx_tokenizer_path = "tokenizer.onnx" # Generate the tokenizer ONNX model, and set the maximum token length. # Ensure 'max_length' is set to a value less than the model's maximum sequence length, failing to do so will result in error during inference. tokenizer_onnx_model = gen_processing_models(tokenizer, pre_kwargs={'max_length': 256})[0] # Modify the tokenizer ONNX model signature. # This is because certain tokenizers don't support batch inference. tokenizer_onnx_model.graph.input[0].type.tensor_type.shape.dim[0].dim_value = 1 # Save the tokenizer ONNX model with open(onnx_tokenizer_path, "wb") as f: f.write(tokenizer_onnx_model.SerializeToString())שומרים את קובץ ה-
convert-tokenizer.py.כדי להמיר את ה-tokenizer, מריצים את הסקריפט של Python:
python convert-tokenizer.py
הטוקנייזר שהומר מיוצא לספרייה all-MiniLM-L6-v2_quantized בתור tokenizer.onnx.
העלאת קובצי המודל שהומרו ל-Cloud Storage
אחרי שממירים את מודל הטרנספורמר ואת ה-tokenizer, מבצעים את הפעולות הבאות:
- יוצרים קטגוריה של Cloud Storage כדי לאחסן את הקבצים שהומרו.
- מעלים את קובצי המודל והטוקנייזר של הטרנספורמר שהומרו לקטגוריה של Cloud Storage.
יצירת קבוצת נתונים
כדי ליצור מערך נתונים ב-BigQuery, בוחרים אחת מהאפשרויות הבאות:המסוף
נכנסים לדף BigQuery במסוף Cloud de Confiance .
בחלונית הימנית, לוחצים על Explorer:
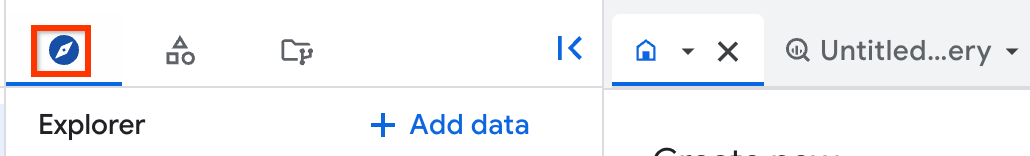
אם החלונית הימנית לא מוצגת, לוחצים על Expand left pane כדי לפתוח אותה.
ב-Explorer, מרחיבים את הפרויקט ולוחצים על Datasets.
בדף Datasets, לוחצים על Create dataset.
בחלונית Create dataset:
בשדה Dataset ID, מזינים
bqml_tutorial.בקטע Data location (מיקום הנתונים), בוחרים באפשרות US (ארה"ב).
משאירים את שאר הגדרות ברירת המחדל כמו שהן.
לוחצים על Create dataset.
BQ
כדי ליצור קבוצת נתונים חדשה, משתמשים בפקודה bq mk --dataset.
יוצרים מערך נתונים בשם
bqml_tutorialומגדירים את מיקום הנתונים ל-US:bq mk --dataset \ --location=US \ --description "BigQuery ML tutorial dataset." \ bqml_tutorial
מוודאים שמערך הנתונים נוצר:
bq ls
API
מפעילים את השיטה datasets.insert עם משאב של מערך נתונים מוגדר:
{
  "datasetReference": {
     "datasetId": "bqml_tutorial"
  }
}
BigQuery DataFrames
לפני שתנסו את הדוגמה הזו, פעלו לפי הוראות ההגדרה של BigQuery DataFrames שמפורטות במאמר התחלה מהירה ב-BigQuery באמצעות BigQuery DataFrames. מידע נוסף זמין במאמרי העזרה של BigQuery DataFrames.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת ADC לסביבת פיתוח מקומית.
ייבוא של מודלי ONNX ל-BigQuery
מייבאים את מודל ה-tokenizer שהומר ואת מודל ה-sentence transformer כמודלים של BigQuery ML.
בוחרים באחת מהאפשרויות הבאות:
המסוף
נכנסים לדף BigQuery Studio במסוף Cloud de Confiance .
בעורך השאילתות, מריצים את הצהרת ה-
CREATE MODELהבאה כדי ליצור את המודלtokenizer:CREATE OR REPLACE MODEL `bqml_tutorial.tokenizer` OPTIONS (MODEL_TYPE='ONNX', MODEL_PATH='TOKENIZER_BUCKET_PATH');
מחליפים את
TOKENIZER_BUCKET_PATHבנתיב למודל שהעליתם ל-Cloud Storage. אם אתם משתמשים במודל לדוגמה, החליפו אתTOKENIZER_BUCKET_PATHבערך הבא:gs://cloud-samples-data/bigquery/ml/onnx/all-MiniLM-L6-v2/tokenizer.onnx.בסיום הפעולה, בחלונית Query results תופיע הודעה דומה לזו:
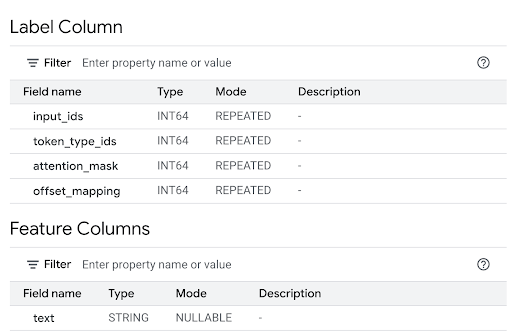
Successfully created model named tokenizer.כדי לפתוח את החלונית Details, לוחצים על Go to model.
כדי לראות את הקלט והפלט מהמודל ב-Label Column, עיינו בקטע Feature Columns:
כדי ליצור את המודל
all-MiniLM-L6-v2, מריצים את הצהרת ה-CREATE MODELהבאה בעורך השאילתות:CREATE OR REPLACE MODEL `bqml_tutorial.all-MiniLM-L6-v2` OPTIONS (MODEL_TYPE='ONNX', MODEL_PATH='TRANSFORMER_BUCKET_PATH');
מחליפים את
TRANSFORMER_BUCKET_PATHבנתיב למודל שהעליתם ל-Cloud Storage. אם משתמשים במודל לדוגמה, מחליפים אתTRANSFORMER_BUCKET_PATHבערך הבא:gs://cloud-samples-data/bigquery/ml/onnx/all-MiniLM-L6-v2/model_quantized.onnx.בסיום הפעולה, בחלונית Query results תופיע הודעה דומה לזו:
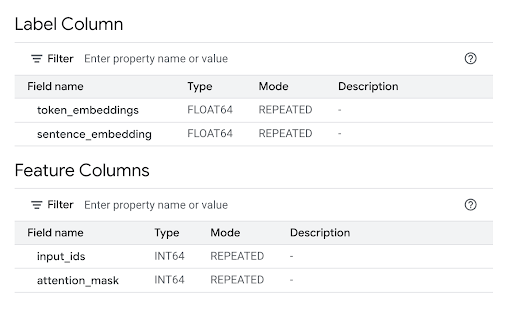
Successfully created model named all-MiniLM-L6-v2.כדי לפתוח את החלונית Details, לוחצים על Go to model.
כדי לראות את הקלט והפלט מהמודל ב-Label Column, עיינו בקטע Feature Columns:
BQ
מריצים את ההצהרה CREATE MODEL באמצעות הפקודה query בכלי שורת הפקודה של BigQuery.
יוצרים את המודל
tokenizer:bq query --use_legacy_sql=false \ "CREATE OR REPLACE MODEL `bqml_tutorial.tokenizer` OPTIONS (MODEL_TYPE='ONNX', MODEL_PATH='TOKENIZER_BUCKET_PATH')"מחליפים את
TOKENIZER_BUCKET_PATHבנתיב למודל שהעליתם ל-Cloud Storage. אם משתמשים במודל לדוגמה, מחליפים אתTOKENIZER_BUCKET_PATHבערך הבא:gs://cloud-samples-data/bigquery/ml/onnx/all-MiniLM-L6-v2/tokenizer.onnx.בסיום הפעולה, תופיע הודעה דומה לזו:
Successfully created model named tokenizer.יוצרים את המודל
all-MiniLM-L6-v2:bq query --use_legacy_sql=false \ "CREATE OR REPLACE MODEL `bqml_tutorial.all-MiniLM-L6-v2` OPTIONS (MODEL_TYPE='ONNX', MODEL_PATH='TRANSFORMER_BUCKET_PATH')"מחליפים את
TRANSFORMER_BUCKET_PATHבנתיב למודל שהעליתם ל-Cloud Storage. אם משתמשים במודל לדוגמה, מחליפים אתTRANSFORMER_BUCKET_PATHבערך הבא:gs://cloud-samples-data/bigquery/ml/onnx/all-MiniLM-L6-v2/model_quantized.onnx.בסיום הפעולה, תופיע הודעה דומה לזו:
Successfully created model named all-MiniLM-L6-v2.אחרי שמייבאים את המודלים, מוודאים שהם מופיעים במערך הנתונים.
bq ls -m bqml_tutorial
הפלט אמור להיראות כך:
tableId            Type
------------------------
tokenizer          MODEL
all-MiniLM-L6-v2   MODEL
API
משתמשים ב-jobs.insert method כדי לייבא את המודלים. מאכלסים את הפרמטר query של המשאב QueryRequest בגוף הבקשה באמצעות ההצהרה CREATE MODEL.
כדי ליצור את המודל
tokenizer, משתמשים בפרמטרqueryהבא:{ "query": "CREATE MODEL `PROJECT_ID :bqml_tutorial.tokenizer` OPTIONS(MODEL_TYPE='ONNX' MODEL_PATH='TOKENIZER_BUCKET_PATH')" }מחליפים את מה שכתוב בשדות הבאים:
PROJECT_ID: מזהה הפרויקט.-
TOKENIZER_BUCKET_PATH: הנתיב למודל שהעליתם ל-Cloud Storage. אם אתם משתמשים במודל לדוגמה, החליפו אתTOKENIZER_BUCKET_PATHבערך הבא:gs://cloud-samples-data/bigquery/ml/onnx/all-MiniLM-L6-v2/tokenizer.onnx.
כדי ליצור את המודל
all-MiniLM-L6-v2, משתמשים בערך הפרמטרqueryהבא:{ "query": "CREATE MODEL `PROJECT_ID :bqml_tutorial.all-MiniLM-L6-v2` OPTIONS(MODEL_TYPE='ONNX' MODEL_PATH='TRANSFORMER_BUCKET_PATH')" }מחליפים את מה שכתוב בשדות הבאים:
PROJECT_ID: מזהה הפרויקט.-
TRANSFORMER_BUCKET_PATH: הנתיב למודל שהעליתם ל-Cloud Storage. אם אתם משתמשים במודל לדוגמה, החליפו אתTRANSFORMER_BUCKET_PATHבערך הבא:gs://cloud-samples-data/bigquery/ml/onnx/all-MiniLM-L6-v2/model_quantized.onnx.
BigQuery DataFrames
לפני שתנסו את הדוגמה הזו, פעלו לפי הוראות ההגדרה של BigQuery DataFrames שמפורטות במאמר התחלה מהירה ב-BigQuery באמצעות BigQuery DataFrames. מידע נוסף זמין במאמרי העזרה של BigQuery DataFrames.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת ADC לסביבת פיתוח מקומית.
מייבאים את מודלי ה-tokenizer וה-sentence transformer באמצעות האובייקט ONNXModel.
import bigframes
from bigframes.ml.imported import ONNXModel

bigframes.options.bigquery.project = PROJECT_ID

bigframes.options.bigquery.location = "US"

tokenizer = ONNXModel(
  model_path= "TOKENIZER_BUCKET_PATH"
)
imported_onnx_model = ONNXModel(
  model_path="TRANSFORMER_BUCKET_PATH"
)
מחליפים את מה שכתוב בשדות הבאים:
PROJECT_ID: מזהה הפרויקט.-
TOKENIZER_BUCKET_PATH: הנתיב למודל שהעליתם ל-Cloud Storage. אם אתם משתמשים במודל לדוגמה, החליפו אתTOKENIZER_BUCKET_PATHבערך הבא:gs://cloud-samples-data/bigquery/ml/onnx/all-MiniLM-L6-v2/tokenizer.onnx. -
TRANSFORMER_BUCKET_PATH: הנתיב למודל שהעליתם ל-Cloud Storage. אם אתם משתמשים במודל לדוגמה, החליפו אתTRANSFORMER_BUCKET_PATHבערך הבא:gs://cloud-samples-data/bigquery/ml/onnx/all-MiniLM-L6-v2/model_quantized.onnx.
יצירת הטמעות באמצעות מודלים מיובאים של ONNX
משתמשים במודלים המיובאים של ה-tokenizer ושל ה-sentence transformer כדי ליצור הטמעות על סמך נתונים ממערך הנתונים הציבורי bigquery-public-data.imdb.reviews.
בוחרים באחת מהאפשרויות הבאות:
המסוף
כדי ליצור הטמעות באמצעות המודלים, משתמשים בפונקציה ML.PREDICT.
השאילתה משתמשת בקריאה מקוננת ל-ML.PREDICT כדי לעבד טקסט גולמי ישירות באמצעות ה-tokenizer ומודל ההטמעה, באופן הבא:
- טוקניזציה (שאילתה פנימית): הקריאה הפנימית ל-
ML.PREDICTמשתמשת במודלbqml_tutorial.tokenizer. היא מקבלת את העמודהtitleממערך הנתונים הציבוריbigquery-public-data.imdb.reviewsכקלטtext. המודלtokenizerממיר את מחרוזות הטקסט הגולמיות לקלט של אסימונים מספריים שהמודל הראשי דורש, כולל הקלט שלinput_idsו-attention_mask. - יצירת הטמעה (שאילתה חיצונית): הקריאה החיצונית ל-
ML.PREDICTמשתמשת במודלbqml_tutorial.all-MiniLM-L6-v2. השאילתה מקבלת כקלט את העמודותinput_idsו-attention_maskמהפלט של השאילתה הפנימית.
ההצהרה SELECT מאחזרת את העמודה sentence_embedding, שהיא מערך של ערכי FLOAT שמייצגים את ההטמעה הסמנטית של הטקסט.
כדי ליצור את ההטמעות, פועלים לפי השלבים הבאים:
נכנסים לדף BigQuery Studio במסוף Cloud de Confiance .
בעורך השאילתות, מריצים את השאילתה הבאה.
SELECT
sentence_embedding
FROM
ML.PREDICT (MODEL `bqml_tutorial.all-MiniLM-L6-v2`,
  (
  SELECT
    input_ids, attention_mask
  FROM
    ML.PREDICT(MODEL `bqml_tutorial.tokenizer`,
      (
      SELECT
        title AS text
      FROM
        `bigquery-public-data.imdb.reviews` limit 10))));
התוצאה אמורה להיראות כך:
+-----------------------+
| sentence_embedding    |
+-----------------------+
| -0.02361682802438736  |
| 0.02025664784014225   |
| 0.005168713629245758  |
| -0.026361213997006416 |
| 0.0655381828546524    |
| ...                   |
+-----------------------+
BQ
משתמשים בפקודה query של כלי שורת הפקודה של BigQuery כדי להריץ שאילתה. השאילתה משתמשת בפונקציה ML.PREDICT כדי ליצור הטמעות באמצעות המודלים.
השאילתה משתמשת בקריאה מקוננת ל-ML.PREDICT כדי לעבד טקסט גולמי ישירות באמצעות ה-tokenizer ומודל ההטמעה, באופן הבא:
- טוקניזציה (שאילתה פנימית): הקריאה הפנימית ל-
ML.PREDICTמשתמשת במודלbqml_tutorial.tokenizer. היא מקבלת את העמודהtitleממערך הנתונים הציבוריbigquery-public-data.imdb.reviewsכקלטtext. המודלtokenizerממיר את מחרוזות הטקסט הגולמיות לקלט של אסימונים מספריים שהמודל הראשי דורש, כולל הקלט שלinput_idsו-attention_mask. - יצירת הטמעה (שאילתה חיצונית): הקריאה החיצונית ל-
ML.PREDICTמשתמשת במודלbqml_tutorial.all-MiniLM-L6-v2. השאילתה מקבלת כקלט את העמודותinput_idsו-attention_maskמהפלט של השאילתה הפנימית.
ההצהרה SELECT מאחזרת את העמודה sentence_embedding, שהיא מערך של ערכי FLOAT שמייצגים את ההטמעה הסמנטית של הטקסט.
מריצים את הפקודה הבאה בשורת הפקודה כדי להריץ את השאילתה.
bq query --use_legacy_sql=false \
'SELECT
sentence_embedding
FROM
ML.PREDICT (MODEL `bqml_tutorial.all-MiniLM-L6-v2`,
  (
  SELECT
    input_ids, attention_mask
  FROM
    ML.PREDICT(MODEL `bqml_tutorial.tokenizer`,
      (
      SELECT
        title AS text
      FROM
        `bigquery-public-data.imdb.reviews` limit 10))))'
התוצאה אמורה להיראות כך:
+-----------------------+
| sentence_embedding    |
+-----------------------+
| -0.02361682802438736  |
| 0.02025664784014225   |
| 0.005168713629245758  |
| -0.026361213997006416 |
| 0.0655381828546524    |
| ...                   |
+-----------------------+
BigQuery DataFrames
לפני שתנסו את הדוגמה הזו, פעלו לפי הוראות ההגדרה של BigQuery DataFrames שמפורטות במאמר התחלה מהירה ב-BigQuery באמצעות BigQuery DataFrames. מידע נוסף זמין במאמרי העזרה של BigQuery DataFrames.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת ADC לסביבת פיתוח מקומית.
משתמשים ב-method predict כדי ליצור הטמעות באמצעות מודלים של ONNX.
import bigframes.pandas as bpd

df = bpd.read_gbq("bigquery-public-data.imdb.reviews", max_results=10)
df_pred = df.rename(columns={"title": "text"})
tokens = tokenizer.predict(df_pred)
predictions = imported_onnx_model.predict(tokens)
predictions.peek(5)
הפלט אמור להיראות כך:

הסרת המשאבים
כדי להימנע מחיובים בחשבון Google Cloud בגלל השימוש במשאבים שנעשה במסגרת המדריך הזה, אפשר למחוק את הפרויקט שמכיל את המשאבים, או להשאיר את הפרויקט ולמחוק את המשאבים הנפרדים.
מחיקת הפרויקט
המסוף
- במסוף Cloud de Confiance , נכנסים לדף Manage resources.
- ברשימת הפרויקטים, בוחרים את הפרויקט שרוצים למחוק ולוחצים על Delete.
- כדי למחוק את הפרויקט, כותבים את מזהה הפרויקט בתיבת הדו-שיח ולוחצים על Shut down.
gcloud
כדי למחוק פרויקט ב- Cloud de Confiance :
gcloud projects delete PROJECT_ID
מחיקת משאבים ספציפיים
לחלופין, כדי לשמור את הפרויקט ולמחוק את המשאבים שבהם השתמשתם במדריך הזה:
נכנסים לדף BigQuery Studio במסוף Cloud de Confiance .
בחלונית הימנית, מרחיבים את הפרויקט ולוחצים על Datasets.
במערך הנתונים
bqml_tutorial, לוחצים על פתיחת הפעולות > מחיקה.בתיבת הדו-שיח Delete dataset, לוחצים על Delete כדי לאשר.
אם פעלתם לפי השלבים להמרה ידנית של קובצי המודל של הטרנספורמר ל-ONNX, מחקו את הקטגוריה של Cloud Storage.
המאמרים הבאים
- איך משתמשים בהטמעות טקסט לחיפוש סמנטי ול-RAG
- מידע נוסף על המרת מודלים של טרנספורמרים ל-ONNX זמין במאמר ייצוא מודל ל-ONNX באמצעות
optimum.exporters.onnx. - מידע נוסף על ייבוא מודלים של ONNX זמין במאמר ההצהרה
CREATE MODELלמודלים של ONNX. - מידע נוסף על ביצוע חיזוי זמין במאמר הפונקציה
ML.PREDICT. - לסקירה כללית על BigQuery ML, קראו את המאמר מבוא ל-BigQuery ML.
- כדי להתחיל להשתמש ב-BigQuery ML, קראו את המאמר יצירת מודלים של למידת מכונה ב-BigQuery ML.