

마이그레이션 계보를 사용하여 마이그레이션 계획
BigQuery 데이터 웨어하우스 마이그레이션을 계획할 때 마이그레이션 계보 서비스를 사용하여 소스 데이터베이스의 데이터 흐름과 연결을 시각화할 수 있습니다.
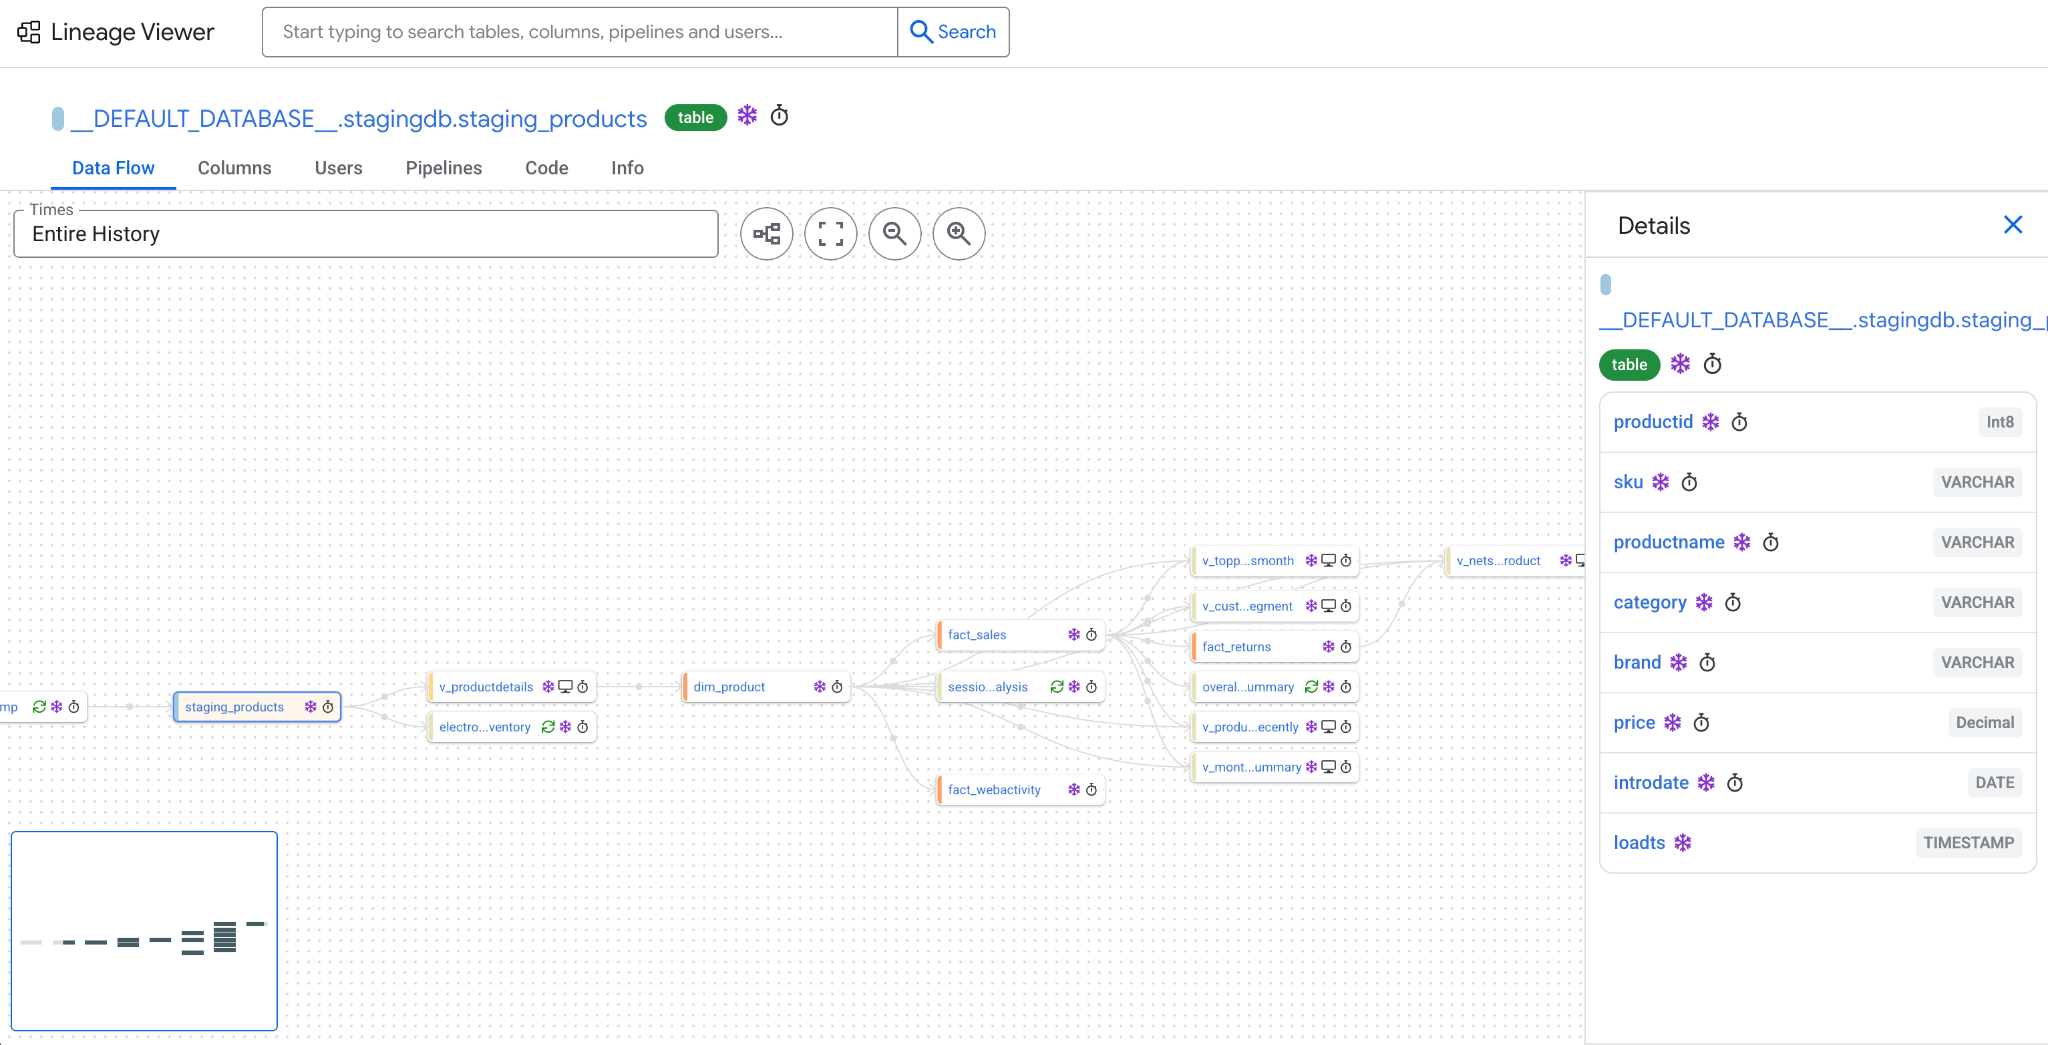
마이그레이션 계보를 만들면 계보 서비스는 다음 다이어그램과 같이 소스 시스템을 통해 데이터가 이동하는 방식과 소스 시스템의 각 테이블 또는 뷰가 연결되는 방식을 시각화하는 그래프를 제공합니다.
마이그레이션 계보 서비스는 다음 SQL 언어를 지원합니다.
- Amazon Redshift SQL
- Snowflake SQL
- Teradata SQL
- GoogleSQL (BigQuery)
제한사항
계보 서비스는 소스 데이터베이스에서 가장 오래된 로그의 처음 5GB를 처리합니다.
지원되는 위치
마이그레이션 계보 서비스는 일부 위치에서 사용할 수 있습니다. 자세한 내용은 BigQuery SQL 변환기 및 계보 서비스 위치를 참조하세요.
필수 권한
마이그레이션 계보 서비스를 사용하는 데 필요한 권한을 얻으려면 관리자에게 프로젝트에 대한 MigrationWorkflow 편집자 (roles/bigquerymigration.editor) IAM 역할을 부여해 달라고 요청하세요.
역할 부여에 대한 자세한 내용은 프로젝트, 폴더, 조직에 대한 액세스 관리를 참조하세요.
이 사전 정의된 역할에는 마이그레이션 계보 서비스를 사용하는 데 필요한 권한이 포함되어 있습니다. 필요한 정확한 권한을 보려면 필수 권한 섹션을 펼치세요.
필수 권한
마이그레이션 계보 서비스를 사용하려면 다음 권한이 필요합니다.
-
bigquerymigration.workflows.create -
bigquerymigration.workflows.get -
bigquerymigration.lineageDbs.query
커스텀 역할이나 다른 사전 정의된 역할을 사용하여 이 권한을 부여받을 수도 있습니다.
BigQuery의 IAM 역할과 권한에 대한 자세한 내용은 BigQuery IAM 역할 및 권한을 참조하세요.
마이그레이션 계보 추적
마이그레이션 계보를 추적하려면 먼저 dwh-migration-dumper 도구를 실행하여 Cloud Storage에 업로드하는 소스 입력 SQL 로그 파일을 생성합니다.
입력 파일을 Cloud Storage에 업로드한 후 Cloud de Confiance 콘솔 또는 BigQuery Migration API를 사용하여 마이그레이션 계보를 추적할 수 있습니다.
dwh-migration-dumper 도구 실행
다음 옵션 중 하나를 선택합니다.
Amazon Redshift
Amazon Redshift 데이터베이스에서 마이그레이션 계보를 추적하고 보려면 다음을 수행합니다.
dwh-migration-dumper도구를 실행하여 소스 시스템 파일의 덤프를 생성합니다.- Cloud Storage에 쿼리 로그를 업로드합니다.
Snowflake
Snowflake 데이터베이스에서 마이그레이션 계보를 추적하고 보려면 다음을 수행합니다.
dwh-migration-dumper도구를 실행하여 소스 시스템 파일의 덤프를 생성합니다.- Cloud Storage에 쿼리 로그를 업로드합니다.
Teradata
Teradata 데이터베이스에서 마이그레이션 계보를 추적하고 보려면 다음을 수행합니다.
dwh-migration-dumper도구를 실행하여 소스 시스템 파일의 덤프를 생성합니다.- Cloud Storage에 쿼리 로그를 업로드합니다.
BigQuery
BigQuery 데이터베이스에서 마이그레이션 계보를 추적하고 보려면 다음을 수행합니다.
- 계정 또는 서비스 계정에 다음 역할을 부여합니다.
- BigQuery 메타데이터 뷰어 (
roles/bigquery.metadataViewer) - Data Catalog 뷰어 (
roles/datacatalog.viewer)
- BigQuery 메타데이터 뷰어 (
dwh-migration-dumper도구를 설치합니다.메타데이터 및 쿼리 로그를 생성하려면
dwh-migration-dumper도구를 실행합니다. 이러한 메타데이터와 쿼리 로그는 하나 이상의 ZIP 파일에 포함되어 있습니다.dwh-migration-dumper --connector bigquery dwh-migration-dumper --connector bigquery-logs
ZIP 파일을 Cloud Storage 버킷에 업로드합니다. 버킷 생성 및 Cloud Storage에 파일 업로드에 대한 자세한 내용은 버킷 만들기 및 파일 시스템에서 객체 업로드를 참조하세요.
trace 계보
메타데이터와 쿼리 로그가 포함된 ZIP 파일을 Cloud Storage에 업로드한 후 계보를 추적할 수 있습니다. 다음 옵션 중 하나를 선택합니다.
콘솔
이전 서비스 페이지로 이동합니다.
Trace 계보에서 Trace 변환을 클릭합니다.
계보 구성에서 다음을 입력합니다.
- 표시 이름에 계보 작업 이름을 지정합니다. 이름에는 문자, 숫자 또는 밑줄을 사용할 수 있습니다.
- 처리 위치에서 계보 작업을 실행할 위치를 선택합니다.
입력 디렉터리 위치 수정에서 이전에 업로드한 로그 ZIP 파일이 포함된 Cloud Storage 폴더의 경로를 지정합니다. 경로를
bucket_name/folder_name/형식으로 입력하거나 찾아보기를 클릭할 수 있습니다. 출력 하위 디렉터리 이름 필드에서 출력 파일의 하위 디렉터리 이름을 지정할 수도 있습니다.입력 디렉터리 위치 추가를 클릭하여 입력 파일을 더 추가할 수 있습니다.
Trace를 클릭합니다.
이제 계보 작업이 실행됩니다. 입력 크기에 따라 작업을 완료하는 데 몇 시간이 걸릴 수 있습니다. 작업이 완료되면 도구는 추적된 마이그레이션 계보에 대한 링크를 제공합니다.
API
계보 작업을 추적하려면 다음 curl 명령어를 실행합니다.
  curl -d "{
    \"tasks\": {
      \"TASK_NAME\": {
        \"type\": \"Experimental_Lineage\",
        \"translation_details\": {
          \"target_base_uri\": \"BUCKET_PATH\",
          \"source_target_mapping\": {
            \"source_spec\": {
              \"base_uri\": \"BUCKET_PATH\"
            }
          },
          \"target_types\": \"LINEAGE\"
        }
      }
    }
  }
  " \
    -H "Content-Type:application/json" \
    -H "Authorization: Bearer TOKEN" -X POST https://bigquerymigration.googleapis.com/v2/projects/PROJECT_ID/locations/LOCATION/workflows
다음을 바꿉니다.
TASK_NAME: 이 계보 작업을 식별하는 이름입니다.BUCKET_PATH: 입력 ZIP 파일이 포함된 Cloud Storage 버킷의 경로입니다.PROJECT_ID:Cloud de Confiance 프로젝트의 프로젝트 ID입니다.LOCATION: 처리 위치입니다. 이 값은eu또는us여야 합니다.
이 호출은 다음과 유사한 메시지를 반환합니다.
  {
    "name": "projects/PROJECT_ID/locations/LOCATION/workflows/WORKFLOW_ID",
    "tasks": {
      "task_name": { /*...*/ }
    },
    "state": "RUNNING"
  }
이제 계보 작업이 실행됩니다. 입력 크기에 따라 작업을 완료하는 데 몇 시간이 걸릴 수 있습니다. 계보 작업의 상태를 확인하려면 워크플로 ID와 함께 다음 curl 명령어를 실행합니다.
  curl \
  -H "Content-Type:application/json" \
  -H "Authorization:Bearer " -X GET https://bigquerymigration.googleapis.com/v2/projects/PROJECT_ID/locations/LOCATION/workflows/WORKFLOW_ID
작업이 완료되면 도구는 추적된 계보 뷰에 대한 링크를 제공합니다.
마이그레이션 계보 열기
마이그레이션 계보를 추적한 후에는 다음 옵션 중 하나를 사용하여 마이그레이션 계보를 열 수 있습니다.
콘솔
이전 서비스 페이지로 이동합니다.
계보 추적에서 최근 항목 보기를 클릭합니다.
마이그레이션 계보 페이지에서 작업 이름을 클릭하여 전체 계보 작업을 선택합니다.
변환 세부정보 페이지에서 데이터 계보를 클릭합니다.
API
완료된 마이그레이션 계보를 열려면 BigQuery Migration API를 사용하여 다음 curl 명령어를 실행합니다.
  curl \
  -H "Content-Type:application/json" \
  -H "Authorization:Bearer " -X GET https://bigquerymigration.googleapis.com/v2/projects/PROJECT_ID/locations/LOCATION/workflows/WORKFLOW_ID
다음을 바꿉니다.
PROJECT_ID:Cloud de Confiance 프로젝트의 프로젝트 ID입니다.LOCATION: 처리 위치입니다. 이 값은eu또는us여야 합니다.WORKFLOW_ID: 추적된 계보의 워크플로 ID입니다.
출력 메시지의 taskResult.translationTaskResult.consoleUri 필드에 포함된 링크로 이동합니다.
마이그레이션 계보 작업
다음 섹션에서는 마이그레이션 계보를 사용하여 소스 데이터 및 데이터베이스를 사용하는 방법을 설명합니다.
이전 계보 용어 이해
이전 계보에는 다음 용어가 사용됩니다.
| 약관 | 설명 |
|---|---|
| 스크립트 | 계보 빌드 중에 수집된 데이터베이스 로그에 표시되는 SQL 스크립트 및 기타 프로그램 스크립트는 문으로 구성되며, 가장 일반적으로 단일 SQL 문입니다. |
| 노드 | 계보 그래프의 꼭짓점입니다. 이는 테이블과 열로 구성됩니다. |
| 테이블 | 일반 테이블, 뷰, 구조화된 파일, 기타 테이블과 유사한 리소스를 포함하여 관계라고도 합니다. |
| 열 | 테이블 열, 뷰 프로젝션, 의사 열, 파일 및 기타 리소스의 열과 유사한 필드, 구조체 필드와 같은 하위 열을 포함하여 속성이라고도 합니다. |
| 에지 | 해당 노드를 읽거나 쓴 스크립트를 실행하는 파이프라인으로 인한 상호작용을 나타내는 계보 노드 간의 연결입니다. 에지는 에지가 파생된 시점의 타임스탬프, 조건자, 기타 메타데이터로 주석이 추가됩니다. 에지가 있는 다른 노드에 인접한 노드를 직접 연결이라고 합니다. 두 노드 사이의 에지 경로를 간접 연결이라고 합니다. |
| 계보 에지 | 소스 노드가 대상 노드의 데이터에 영향을 미치는 FROM, WHERE 또는 GROUP BY 절과 같은 절에 포함되었음을 나타내는 방향성 에지입니다. |
| 사용자 및 파이프라인 | 스크립트를 실행한 사용자와 항목에 대해 소스 데이터베이스에서 제공하는 메타데이터 라벨입니다. 계보 엔진에 내재된 의미는 없지만 출처별로 스크립트를 그룹화하는 데 사용됩니다. |
다음 섹션에서는 마이그레이션 계보의 여러 페이지를 설명합니다.
방문 페이지 검토
마이그레이션 계보의 방문 페이지에는 계보 작업 ID, 이름으로 계보 객체를 찾을 수 있는 검색 필드, 관심 있는 계보 객체를 강조 표시하는 추천 목록이 표시됩니다. 이 페이지에는 마이그레이션 계보 전반의 테이블, 파이프라인, 사용자 총 수도 포함됩니다.
특정 테이블, 뷰 또는 열로 이동하려면 검색 필드에서 객체를 검색하거나 방문 페이지에서 추천 객체 중 하나를 클릭합니다.
노드 페이지 검토
마이그레이션 계보의 노드를 검토하려면 다음 탭 중 하나를 클릭합니다.
데이터 흐름 탭
데이터 흐름 탭에는 계보 그래프의 일부가 시각적으로 표시됩니다. 계보 서비스에서 테이블 또는 열을 처음 볼 때 표시되는 기본 페이지입니다. 그래프는 소스 시스템을 통해 데이터가 이동하는 방식을 시각화합니다. 이 그래프의 노드는 테이블 또는 뷰를 나타내고 노드 간의 에지는 왼쪽 노드에서 오른쪽 노드로 흐르는 데이터를 나타냅니다.
데이터 흐름 그래프의 각 테이블에는 정규화되지 않은 이름이 표시됩니다. 데이터베이스 및 스키마 프리픽스가 있는 테이블의 정규화된 이름을 보려면 노드 위로 포인터를 가져가 도움말을 표시합니다. 각 테이블은 노드의 세로 막대로 표시된 스키마를 나타냅니다. 계보의 모든 스키마는 알파벳순으로 정렬되고 색상이 할당되므로 동일한 스키마의 테이블에는 동일한 색상의 막대가 있고 이름이 유사한 스키마의 테이블에는 유사한 색상의 막대가 있습니다.
각 노드에는 노드의 속성을 나타내는 아이콘이 표시됩니다.
- monitor: 테이블이 아닌 뷰입니다.
- cached: 항상 완전히 새로고침되는 테이블입니다 (잘린 후 다시 작성됨). 아이콘을 클릭하여 이 테이블에 인접한 스크립트를 확인합니다.
- cached: 항상 완전히 새로고침되지 않는 테이블입니다 (잘린 후 다시 작성됨). 아이콘을 클릭하여 이 테이블에 인접한 스크립트를 확인합니다.
- timer: 수명이 짧은 테이블입니다. 아이콘 위로 마우스를 가져가면 테이블이 존재한 기간이 표시됩니다.
- snowflake: 마지막으로 작성된 지 7일이 지난 테이블로, 정적 데이터 또는 자주 작성되지 않는 데이터가 있는 테이블을 나타냅니다.
데이터 흐름 그래프에서 객체를 검토하려면 다음 단계를 따르세요.
- 테이블 열 목록을 보려면 테이블을 클릭합니다. 이 뷰에는 제공된 메타데이터 덤프에서 결정되거나 쿼리 로그에 표시된 SQL에서 추론된 각 열의 이름과 데이터 유형이 포함됩니다.
- 열의 열 수준 계보 그래프를 보려면 열을 클릭합니다. 열 수준 계보 그래프에서 에지는 대상 열에 영향을 미치는 데이터 흐름을 나타냅니다.
에지에 대한 세부정보를 보려면 그래프에서 에지를 클릭합니다. 이 뷰에는 에지를 유도한 SQL 스크립트에 대한 링크가 포함되어 있습니다.
SQL 문이 대상 노드에 삽입되는 데이터를 계산하는 동안 소스 노드를 참조하면 소스 노드에서 대상 노드로 에지가 생성됩니다. 일반적으로 여기에는 소스에서 대상으로의 데이터 전송이 포함되지만, 소스 노드가 대상에 영향을 미치는
WHERE또는GROUP BY절에 사용되는 경우 데이터 흐름 탭에도 에지가 표시됩니다. 데이터 전송만 필터링하려면 툴바에서 데이터가 아닌 에지 표시 버튼을 전환합니다.
연결 탭
계보 노드의 연결 탭에는 계보 그래프의 주변 노드 목록이 표시됩니다. 기본적으로 연결된 노드는 현재 노드에서 가장 짧은 경로의 거리를 기준으로 정렬됩니다. 현재 노드에서 도달하는 데 필요한 에지가 더 적은 노드가 먼저 나열됩니다. 정렬 옵션을 사용하여 정렬을 변경할 수 있습니다.
연결 목록에는 기본적으로 현재 노드의 업스트림 (프로듀서) 및 다운스트림 (소비자) 노드가 모두 포함됩니다. 유형 컨트롤을 사용하여 이 필터를 변경할 수 있습니다. 거리 열에서 현재 노드의 업스트림에 있는 노드는 현재 노드에서 해당 노드까지의 최단 역방향 경로의 거리와 함께 위쪽을 가리키는 화살표로 표시됩니다. 마찬가지로 현재 노드의 다운스트림에 있는 노드는 현재 노드에서 해당 노드까지의 최단 순방향 경로의 거리와 함께 아래쪽을 가리키는 화살표로 표시됩니다. 노드가 주기의 일부인 경우 현재 노드의 업스트림과 다운스트림 모두일 수 있습니다.
표시된 모든 노드가 포함된 파일을 다운로드하려면 다운로드 CSV를 클릭합니다.
사용자 탭
노드의 사용자 탭에는 노드 또는 업스트림 또는 다운스트림 노드를 읽거나 쓴 스크립트를 실행한 사용자가 표시됩니다. 기본적으로 가장 많은 개별 작업을 수행한 사용자가 먼저 표시됩니다. 정렬 옵션을 사용하여 정렬을 변경할 수 있습니다.
표시된 모든 사용자가 포함된 파일을 다운로드하려면 다운로드 CSV를 클릭합니다.
파이프라인 탭
노드의 파이프라인 탭에는 노드를 읽거나 쓴 스크립트를 실행한 파이프라인 또는 업스트림 또는 다운스트림에 있는 노드가 표시됩니다. 기본적으로 가장 많은 개별 작업을 수행한 파이프라인이 먼저 나열됩니다. 정렬 옵션을 사용하여 정렬을 변경할 수 있습니다.
표시된 모든 파이프라인이 포함된 파일을 다운로드하려면 다운로드 CSV를 클릭합니다.
코드 탭
노드의 코드 탭에는 해당 노드에서 데이터를 읽거나 데이터를 쓴 입력 파일에 표시된 모든 SQL 스크립트가 표시됩니다. 노드 언급은 SQL 텍스트에서 강조 표시됩니다. 스크립트를 클릭하여 전체 텍스트를 펼칩니다. 필터 설정을 변경하여 표시된 스크립트 목록을 필터링할 수 있습니다.
표시된 모든 스크립트가 포함된 파일을 다운로드하려면 다운로드 CSV를 클릭합니다.
에지 페이지 검토
계보 그래프에서 노드 에지를 검토하려면 다음 탭 중 하나를 클릭합니다.
세부정보 탭
에지의 세부정보 탭에는 에지를 유도한 스크립트에서 수행한 작업을 설명하는 조건자와 카테고리가 표시됩니다.
조건자는 하이픈으로 구분된 세 부분으로 구성된 코드로 표기됩니다. 첫 번째 부분은 에지의 소스가 관계임을 나타내는 r 또는 에지의 소스가 속성임을 나타내는 a입니다. 두 번째 부분은 소스 노드가 타겟 노드의 데이터에 영향을 미친 방식을 나타내는 다음 약어 중 하나입니다.
has: 소스 관계에 타겟 속성이 포함되어 있습니다.dat: 소스가 데이터를 대상으로 복사하거나 전송합니다.res: 소스는WHERE,HAVING또는JOIN ON와 같은 절에서 대상의 카디널리티를 필터링하거나 제한합니다.grp: 소스가 대상에 영향을 미치는GROUP BY절에 사용됩니다.
세 번째 부분은 r 또는 a이며, 에지의 타겟이 관계인지 속성인지를 나타냅니다.
에지 카테고리에는 다음이 포함될 수 있습니다.
dat조건자:AGGREGATE: 소스가 타겟을 작성한 집계 계산에 사용되었습니다.EXACT_COPY: 소스의 데이터가 대상에 전체 복사되었습니다.FUNCTION: 소스가 타겟을 계산하는 데 사용되었습니다.IDENTITY_COPY: 타겟이 계산되지 않았습니다. 대상은 변환이나 변환 없이 소스의 문자 그대로 복사본이었습니다.PARTITION_PROMOTION: 소스의 파티션을 대상으로 승격한 결과로 대상에 소스의 데이터가 포함됩니다.WEAK_COPY: 소스의 데이터가 대상에 최소한 부분적으로 복사되었습니다.
res조건자:FILTER: 소스가 대상을 작성한 비교에 사용되었습니다.KEY: 소스의 데이터가 대상을 작성한 조인 비교에서 키로 사용되었습니다.
grp조건자:GROUP: 소스의 데이터가 타겟에 영향을 미치는GROUP BY절의 키로 사용되었습니다.
코드 탭
에지의 코드 탭에는 해당 에지를 유도한 SQL 스크립트가 표시됩니다. 에지의 소스 및 타겟 노드는 SQL 텍스트에서 언급된 위치에 강조 표시됩니다.
다음 단계
- 마이그레이션 평가를 실행하여 데이터 웨어하우스를 BigQuery로 마이그레이션할 때의 타당성과 잠재적 이점을 평가합니다.
- 대화형 SQL 변환기, 변환 API, 일괄 SQL 변환기와 같은 SQL 변환 서비스를 사용하여 Gemini로 향상된 SQL 맞춤설정을 포함하여 SQL 쿼리를 GoogleSQL로 자동 변환합니다.