

Présentation des pipelines BigQuery
Vous pouvez utiliser des pipelines BigQuery pour automatiser et simplifier vos processus de données BigQuery. Les pipelines vous permettent de planifier et d'exécuter des composants de code de manière séquentielle pour améliorer l'efficacité et réduire les efforts manuels.
Présentation
Les pipelines sont alimentés par Dataform. En plus d'exécuter des composants de code, Dataform met automatiquement à jour les métadonnées dans Knowledge Catalog pour les tables créées dans un pipeline.
Un pipeline se compose d'un ou de plusieurs des composants de code suivants :
- Notebooks
- Requêtes SQL
- Préparation des données
- Tâches SQLX, y compris les tables, les vues, les sources et les tests de qualité des données
Vous pouvez utiliser des pipelines pour planifier l'exécution des composants de code. Par exemple, vous pouvez programmer l'exécution d'une requête SQL quotidienne pour mettre à jour une table avec les données sources les plus récentes, qui peuvent ensuite alimenter un tableau de bord.
Dans un pipeline comportant plusieurs composants de code, vous définissez la séquence d'exécution. Par exemple, pour entraîner un modèle de machine learning, vous pouvez créer un workflow dans lequel une requête SQL prépare les données, puis un notebook ultérieur entraîne le modèle à l'aide de ces données.
Lorsque vous déclenchez l'exécution d'un pipeline, BigQuery exécute les actions dans l'ordre défini par leurs dépendances. Pour chaque action, BigQuery effectue les étapes suivantes :
- Exécute le code SQL compilé dans BigQuery.
- Met à jour l'état de l'action dans le journal d'exécution.
- Une fois une action effectuée, Dataform lance automatiquement une synchronisation des métadonnées avec Knowledge Catalog. Ce processus d'enrichissement met à jour Knowledge Catalog avec les métadonnées sémantiques définies dans votre configuration SQLX. La synchronisation s'effectue de manière asynchrone et utilise un mécanisme de nouvelle tentative, ce qui garantit que les mises à jour des métadonnées n'ont pas d'incidence sur la latence de votre pipeline ni n'entraînent d'échec du workflow si l'API Dataplex est temporairement indisponible.
Capacités
Dans un pipeline, vous pouvez effectuer les actions suivantes :
- Créez ou importez des requêtes SQL, des notebooks, des préparations de données ou des tâches SQLX dans un pipeline.
- Programmez un pipeline pour qu'il s'exécute automatiquement à une heure et à une fréquence spécifiées.
- Partagez un pipeline avec les utilisateurs ou les groupes de votre choix.
- Partagez un lien vers un pipeline.
Limites
Les pipelines sont soumis aux limites suivantes :
- Les pipelines ne sont disponibles que dans la console Cloud de Confiance .
- Vous ne pouvez pas modifier la région de stockage d'un pipeline après sa création.
- Vous pouvez accorder à des utilisateurs ou à des groupes l'accès à un pipeline sélectionné, mais vous ne pouvez pas leur accorder l'accès à des tâches individuelles au sein du pipeline.
- Si une exécution planifiée de pipeline ne se termine pas avant le début de la prochaine exécution planifiée, celle-ci est ignorée et marquée comme comportant une erreur.
Définir la région par défaut des composants de code
Tous les nouveaux composants de code de votre projet Cloud de Confiance utilisent une région par défaut. Une fois le composant créé, vous ne pouvez plus modifier sa région.
Pour définir la région par défaut des nouveaux composants de code :
Accédez à la page BigQuery.
Dans le volet de gauche, cliquez sur Fichiers pour ouvrir l'explorateur de fichiers :
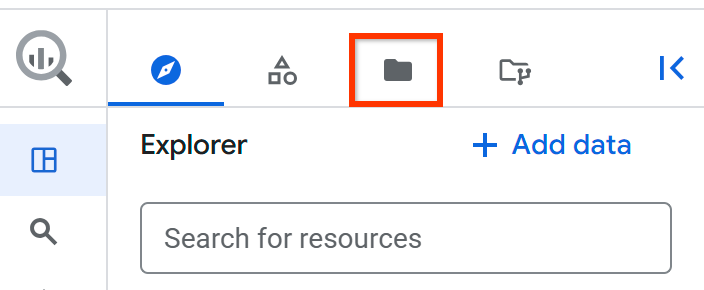
À côté du nom du projet, cliquez sur Afficher les actions du panneau de fichiers > Changer de région de code.
Sélectionnez la région de code que vous souhaitez utiliser par défaut.
Cliquez sur Enregistrer.
Pour obtenir la liste des régions compatibles, consultez Emplacements BigQuery Studio.
Tous les composants de code sont stockés dans votre région par défaut pour les composants de code. La mise à jour de la région par défaut modifie la région pour tous les composants de code créés par la suite.
Quotas et limites
Les pipelines BigQuery sont soumis aux quotas et limites de Dataform.
Tarifs
L'exécution des tâches de pipeline BigQuery entraîne des frais de calcul et de stockage dans BigQuery. Pour en savoir plus, consultez la page relative aux tarifs de BigQuery.
Les pipelines contenant des notebooks entraînent des frais d'exécution Colab Enterprise basés sur le type de machine par défaut. Pour en savoir plus sur les tarifs, consultez la page Tarifs de Colab Enterprise.
Chaque exécution de pipeline BigQuery est journalisée à l'aide de Cloud Logging. La journalisation est automatiquement activée pour les exécutions de pipelines BigQuery, ce qui peut entraîner des frais de facturation Cloud Logging. Pour en savoir plus, consultez la section sur les tarifs de Cloud Logging.
Étapes suivantes
- Découvrez comment créer des pipelines.
- Découvrez comment gérer les pipelines.
- Découvrez comment planifier des pipelines.