

Introduzione alle pipeline BigQuery
Puoi utilizzare le pipeline BigQuery per automatizzare e semplificare i processi di dati BigQuery. Con le pipeline, puoi pianificare ed eseguire gli asset di codice in sequenza per migliorare l'efficienza e ridurre l'impegno manuale.
Panoramica
Le pipeline sono basate su Dataform. Oltre a eseguire gli asset di codice, Dataform aggiorna automaticamente i metadati in Knowledge Catalog per le tabelle create all'interno di una pipeline.
Una pipeline è costituita da una o più delle seguenti risorse di codice:
- Notebooks
- Query SQL
- Preparazioni dei dati
- Attività SQLX, tra cui tabelle, viste, origini e test di qualità dei dati
Puoi utilizzare le pipeline per pianificare l'esecuzione degli asset di codice. Ad esempio, puoi pianificare l'esecuzione giornaliera di una query SQL e aggiornare una tabella con i dati di origine più recenti, che possono poi essere utilizzati per creare una dashboard.
In una pipeline con più risorse di codice, definisci la sequenza di esecuzione. Ad esempio, per addestrare un modello di machine learning, puoi creare un flusso di lavoro in cui una query SQL prepara i dati e poi un notebook successivo addestra il modello utilizzando questi dati.
Quando attivi l'esecuzione di una pipeline, BigQuery esegue le azioni nell'ordine definito dalle loro dipendenze. Per ogni azione, BigQuery esegue i seguenti passaggi:
- Esegue l'SQL compilato in BigQuery.
- Aggiorna lo stato dell'azione nel log di esecuzione.
- Al termine di un'azione, Dataform avvia automaticamente una sincronizzazione dei metadati con Knowledge Catalog. Questo processo di arricchimento aggiorna Knowledge Catalog con i metadati semantici definiti nella configurazione SQLX. La sincronizzazione avviene in modo asincrono e utilizza un meccanismo di ripetizione, garantendo che gli aggiornamenti dei metadati non influiscano sulla latenza della pipeline o causino errori del flusso di lavoro se l'API Dataplex non è temporaneamente disponibile.
Funzionalità
In una pipeline puoi:
- Crea nuove query SQL, notebook, preparazioni dei dati o attività SQLX o importa quelle esistenti in una pipeline.
- Pianifica una pipeline in modo che venga eseguita automaticamente a un orario e con una frequenza specifici.
- Condividi una pipeline con gli utenti o i gruppi che specifichi.
- Condividere un link a una pipeline.
Limitazioni
Le pipeline sono soggette alle seguenti limitazioni:
- Le pipeline sono disponibili solo nella console Cloud de Confiance .
- Non puoi modificare la regione per l'archiviazione di una pipeline dopo la sua creazione.
- Puoi concedere l'accesso a utenti o gruppi a una pipeline selezionata, ma non puoi concedere l'accesso a singole attività all'interno della pipeline.
- Se l'esecuzione di una pipeline pianificata non termina prima dell'inizio della successiva esecuzione pianificata, quest'ultima viene ignorata e contrassegnata con un errore.
Impostare la regione predefinita per gli asset di codice
Tutti i nuovi asset di codice nel tuo progetto Cloud de Confiance utilizzano una regione predefinita. Una volta creato l'asset, non puoi modificarne la regione.
Per impostare la regione predefinita per i nuovi asset di codice:
Vai alla pagina BigQuery.
Nel riquadro a sinistra, fai clic su File per aprire il browser di file:
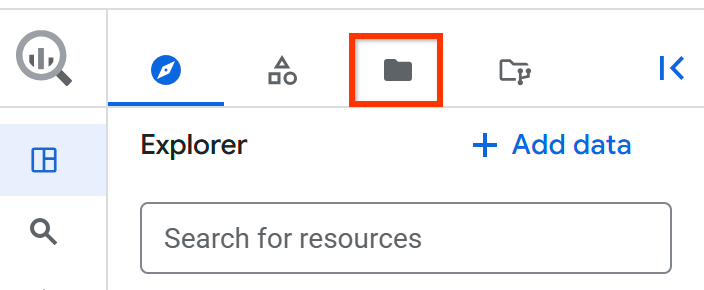
Accanto al nome del progetto, fai clic su Azioni del riquadro dei file > Cambia regione di codice.
Seleziona la regione del codice che vuoi utilizzare come predefinita.
Fai clic su Salva.
Per un elenco delle regioni supportate, consulta Località BigQuery Studio.
Tutti gli asset di codice vengono archiviati nella regione predefinita per gli asset di codice. L'aggiornamento della regione predefinita modifica la regione per tutti gli asset di codice creati dopo quel momento.
Quote e limiti
Le pipeline BigQuery sono soggette a quote e limiti di Dataform.
Prezzi
L'esecuzione delle attività della pipeline BigQuery comporta costi di calcolo e spazio di archiviazione in BigQuery. Per ulteriori informazioni, vedi Prezzi di BigQuery.
Le pipeline contenenti notebook comportano addebiti per il runtime di Colab Enterprise in base al tipo di macchina predefinito. Per i dettagli sui prezzi, consulta Prezzi di Colab Enterprise.
Ogni esecuzione della pipeline BigQuery viene registrata utilizzando Cloud Logging. Il logging viene abilitato automaticamente per le esecuzioni della pipeline BigQuery, che possono comportare addebiti per la fatturazione di Cloud Logging. Per saperne di più, consulta Prezzi di Cloud Logging.
Passaggi successivi
- Scopri come creare pipeline.
- Scopri come gestire le pipeline.
- Scopri come pianificare le pipeline.