

Übersicht
Mit Richtlinien zur Tokenverwaltung können Sie die Tokennutzung von Large Language Models (LLMs) überwachen und genau zuordnen sowie gemeinsame Tokenbudgets für Ihre KI-Agenten und ‑Anwendungen im Unternehmen durchsetzen.
Wenn KI-Agenten mit LLMs interagieren, reicht eine Ratenbegrenzung für die Anzahl der Anfragen, z. B. Anfragen pro Sekunde oder Anfragen pro Minute, nicht aus, um die Ausgaben oder die Kapazität zu steuern. Eine einzelne HTTP-Anfrage an ein LLM kann zwischen einem Dutzend und über 100.000 Tokens verbrauchen. Ohne Governance auf Token-Ebene kann eine einzelne außer Kontrolle geratene Agentenschleife die gemeinsamen Kontingente für Unternehmensmodelle erschöpfen und unerwartete Kostenspitzen verursachen. Um die KI-Ausgaben zu verwalten, müssen Unternehmen auch Modellkontingentbudgets für Nutzer und Abteilungen in ihrer Organisation festlegen.
Mit Token-Verwaltungsrichtlinien können Sie Folgendes tun:
- Berechnen Sie die Tokennutzung für Eingabe-, Ausgabe- und im Cache gespeicherte Tokens für alle Interaktionen zwischen Agent und Modell.
- Sie können den Tokenverbrauch und die geschätzten Kosten geschäftsrelevanten Gruppen, KI-Anwendungen und einzelnen Agentenidentitäten zuordnen, und zwar für Modelle, die auf der Gemini Enterprise Agent Platform oder einer anderen Modellhosting-Plattform gehostet werden.
- Gemeinsame Tokenbudgets in Echtzeit erzwingen, Schwellenwertwarnungen ausgeben oder HTTP
429 Too Many Requestszurückgeben, wenn das Budget eines Tokenpools erschöpft ist. - Exportieren Sie detaillierte Beobachtbarkeits-Telemetriedaten nach Cloud Monitoring und aggregieren Sie Benachrichtigungen zur Tokennutzung in Cloud Logging.
Funktionsweise
Abbildung 1 zeigt, wie Tokenverwaltungsrichtlinien LLM-Anfragen und -Antworten auf der Gateway-Ebene auswerten.
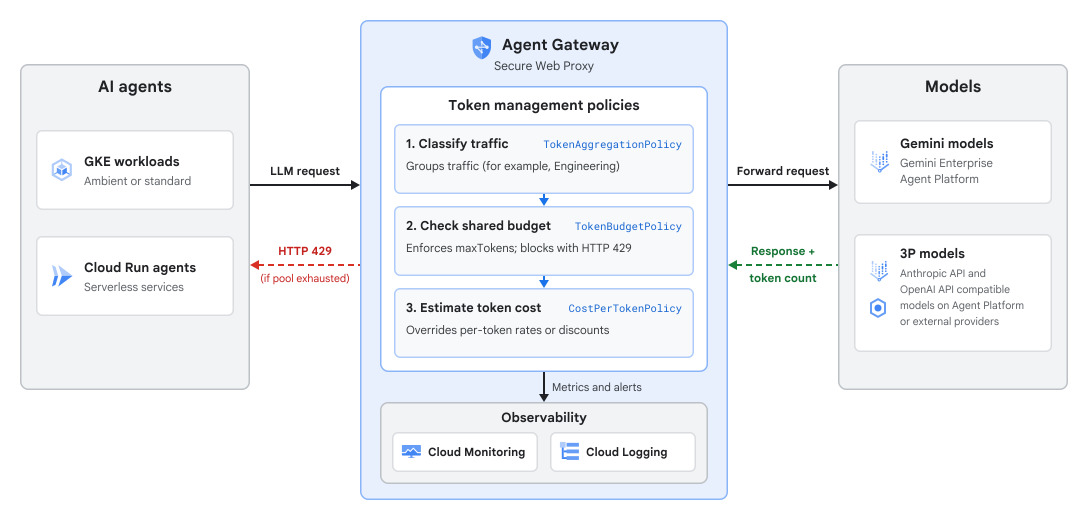
Für die Tokenverwaltung werden drei Richtlinienressourcen verwendet, die zusammenarbeiten, um Traffic zu klassifizieren, Tokenbudgets durchzusetzen und Kostenberechnungen anzupassen:
- Token-Aggregationsrichtlinie (
TokenAggregationPolicy): Klassifiziert eingehende Agent-zu-Modell-Anfragen und aggregiert ihren Tokenverbrauch in logische Tokengruppen. Gruppierungen können auf der Ressourcenhierarchie (Projektbereich), KI-Anwendungen, einzelnen Agents, Zielmodellen oder benutzerdefinierten Tags basieren, die in HTTP-Anfrageheadern (einschließlich API-Schlüsseln) übergeben werden. - Token-Budgetrichtlinie (
TokenBudgetPolicy): Definiert die Token-Pools, die Token-Kontingente auf eine oder mehrere Token-Gruppen anwenden, die durch Ihre Token-Aggregationsrichtlinie identifiziert werden. Für jeden Tokenpool werden eine maximale Tokenanzahl, ein regelmäßiges Zurücksetzungsfenster (stündlich oder täglich), eine optionale Liste von Zielmodellen, ein Schwellenwert für Benachrichtigungen und ein Erzwingungsmodus angegeben. - Kosten-pro-Token-Richtlinie (
CostPerTokenPolicy): Überschreibt die Standard-Token-Preise pro Modell, die zur Berechnung des Messwertsgcp.token_management.token.estimated_costin Monitoring verwendet werden. Sie können entweder einen prozentualen Rabatt auf den Standardmodellpreis oder benutzerdefinierte Preise pro Token in USD für Eingabe-, Ausgabe- und im Cache gespeicherte Tokens konfigurieren.
Richtlinienabhängigkeit und Erstellungsreihenfolge
Bei der Tokenverwaltung wird eine strenge Abhängigkeitshierarchie für Richtlinienressourcen erzwungen, die demselben Zielbereich zugeordnet sind. Die Reihenfolge ist so:
TokenAggregationPolicymuss zuerst erstellt werden, um Anfragen in Tokengruppen für den Zielbereich zu klassifizieren. Diese Richtlinie ist die Mindestanforderung, um eine detaillierte Beobachtbarkeit der Tokennutzung auf Agentenebene zu erhalten.- (Optional)
TokenBudgetPolicymuss so konfiguriert sein, dass die Tokennutzung für die in derTokenAggregationPolicyangegebenen Tokengruppen eingeschränkt wird. - (Optional)
CostPerTokenPolicykann erst erstellt werden, nachdem ein entsprechenderTokenBudgetPolicyfür den Zielbereich vorhanden ist.
Löschen Sie Richtlinien in umgekehrter Reihenfolge: zuerst CostPerTokenPolicy, dann TokenBudgetPolicy und dann TokenAggregationPolicy.
Regelauswertung und Standardabgleich
Innerhalb einer TokenAggregationPolicy werden Regeln in der Reihenfolge ausgewertet, in der sie aufgeführt sind. Die erste übereinstimmende Regel wird angewendet:
- Übereinstimmender Traffic: Wenn eine Agent-Anfrage mit den Quellkriterien einer Regel (KI-Anwendung oder Agent-Identität) und den Zielkriterien (HTTP-Header oder Modellprovider-Endpunkte) übereinstimmt, wird die Tokennutzung der Tokengruppe dieser Regel (
tokenGroup) zugewiesen. - Catch-all-Regel: Sie können eine Regel mit einem leeren Abgleichsblock am Ende Ihrer Regelliste platzieren, um den gesamten verbleibenden Traffic einer Standard-Tokengruppe wie
Defaultzuzuweisen. - Nicht übereinstimmender Traffic: Wenn Sie keine Catch-All-Regel einfügen und eine Anfrage mit keiner Regel in der Richtlinie übereinstimmt, wird der Tokenverbrauch in Monitoring unter der Systemgruppe
unmatchedaufgezeichnet. - Nicht definierter Pool-Traffic: Wenn ein
TokenPoolin Ihrer Token-Budgetrichtlinie (TokenBudgetPolicy) die Erzwingung auf bestimmte Modelle beschränkt, werden Anfragen an Modelle außerhalb dieser Liste nicht blockiert und in Monitoring mit dem Poolnamenundefinedaufgezeichnet.
Unterstützte Umgebungen und Modelle
Richtlinien für die Tokenverwaltung unterstützen die folgenden Agent-Laufzeiten, Agent Gateway-Bereitstellungen und Modelle:
| Komponente | Unterstützte Optionen |
|---|---|
| KI-Agent-Laufzeiten |
|
| Agent Gateway-Bereitstellungen | Secure Web Proxy in Ihrem Cloud de Confiance by S3NS -Projekt: Erzwingt die Governance von ausgehenden Tokens für alle Anfragen von Agenten an Modelle. |
| Modelle |
Mit Gemini, Anthropic und OpenAI API kompatible Modelle aller Modellanbieter:
|
| Aggregationsgruppierungen |
|
Ablauf der Richtliniendurchsetzung
Bei der Standard-Ratenbegrenzung zählt jede Anfrage als eine Einheit, bevor sie das Backend erreicht. Bei LLM-Aufrufen ist die Gesamtzahl der Eingabe- und Ausgabetokens erst bekannt, nachdem das Modell geantwortet hat. Dazu verarbeitet das Agent Gateway jede Anfrage in zwei Phasen:
- Budgetprüfung vor dem Flug (Anfragepfad):
- Ein Agent sendet eine Inferenzanfrage über das Agent Gateway an einen LLM-Endpunkt.
- Das Gateway wertet die Anfrage anhand Ihrer
TokenAggregationPolicyaus, um die übereinstimmendetokenGroupzu ermitteln, und sucht die zugehörigeTokenPoolin IhrerTokenBudgetPolicy. - Wenn das Tokenbudget des Pools erschöpft ist und die strikte Erzwingung aktiviert ist, lehnt das Gateway die Anfrage sofort mit dem HTTP-Statuscode
429ab. Wenn der Pool noch über ein Budget verfügt oder für den Modus „Nur Benachrichtigungen“ konfiguriert ist, leitet das Gateway die Anfrage an das LLM weiter.
- Tokenabgleich und Telemetrie (Antwortpfad):
- Wenn der LLM-Endpunkt die Vervollständigungsantwort zurückgibt, extrahiert das Gateway die tatsächliche Anzahl der
input-,output- undcached-Tokens aus der Antwortnutzlast. - Bei der Tokenverwaltung werden die verbrauchten Tokens mit dem
maxTokens-Kontingent des Pools abgeglichen. - Wenn der aktualisierte Verbrauch den Warnschwellenwert überschreitet oder 100% des Budgets erreicht, schreibt das Gateway eine Warnung in Logging.
- Das Gateway exportiert Messwerte für den Tokenverbrauch pro Agent (
gen_ai.client.token.usage) und die geschätzten Tokenkosten (gcp.token_management.token.estimated_cost) nach Monitoring.
- Wenn der LLM-Endpunkt die Vervollständigungsantwort zurückgibt, extrahiert das Gateway die tatsächliche Anzahl der
Die Anzahl der Ausgabetokens wird erst erfasst, wenn eine LLM-Antwort abgeschlossen ist. Daher können gleichzeitige Anfragen, die zugelassen werden, bevor ein Pool maxTokens erreicht, das Limit überschreiten, bevor spätere Anfragen mit HTTP 429 blockiert werden. Um unerwartete Drosselungen zu vermeiden, legen Sie einen alertThreshold wie 0.6 oder 0.8 fest, um neue Richtlinien mit validateOnly: true zu testen, bevor Sie die strikte Erzwingung aktivieren.
Zugehörige Governance-Kontrollen
In der folgenden Tabelle wird beschrieben, wie Tokenverwaltungsrichtlinien mit anderen Governance-Kontrollen der Agent-Plattform und von Cloud de Confiance funktionieren:
| Governance-Ebene | Richtlinie oder Mechanismus | Zweck |
|---|---|---|
| Zugriffssteuerung | Zugriffsrichtlinien für Identity and Access Management (IAM) | Steuert, welche Agentenidentitäten (SPIFFE-IDs) berechtigt sind, eine Verbindung zu bestimmten MCP-Servern, Tools und Modellendpunkten herzustellen. |
| Absicht und Geschäftsregeln | Semantische Governance-Richtlinien | Bewertet vorgeschlagene Toolaufrufe vor der Ausführung anhand von Einschränkungen in natürlicher Sprache (Natural Language Constraints, NLC) und der Nutzerabsicht. |
| Inhaltssicherheit | Model Armor | Prüft Prompts und Antworten auf Prompt Injection, Jailbreaking und sensible Daten. |
| Ratenbegrenzung für die Anzahl der Anfragen | Ratenbegrenzung für Dienste (RateLimitPolicy) |
Schützt eingehende Load Balancer und Proxys vor volumetrischen Anfragefluten, indem die HTTP-Anfragen pro Sekunde oder Minute (countLimit) begrenzt werden. |
| LLM-Token- und Kosten-Governance | Richtlinien für die Tokenverwaltung
(TokenAggregationPolicy, TokenBudgetPolicy,
CostPerTokenPolicy) |
Überwacht und ordnet die LLM-Tokennutzung zu und erzwingt gemeinsame Tokenbudgets (maxTokens) und Kostenüberschreibungen für Agentengruppen und Modellanbieter. |
Beschränkungen
Für Tokenverwaltungsrichtlinien gelten die folgenden Einschränkungen:
- Sie können maximal einen
TokenAggregationPolicy, einenTokenBudgetPolicyund einenCostPerTokenPolicyan einen bestimmten Projektzielbereich anhängen. - Jede
TokenAggregationPolicyunterstützt bis zu 10 Aggregationsregeln (rules) und jedeTokenBudgetPolicyunterstützt bis zu 10 Tokenpools. - Tokenpools unterstützen die Zurücksetzungszeiträume
HOURLYundDAILY. Tagesbudgets werden um Mitternacht (Pacific Time) zurückgesetzt. - Logging generiert nur dann Logeinträge, wenn ein Tokenpool den konfigurierten
alertThresholdüberschreitet oder 100% vonmaxTokens(token_management_alert_logs) erreicht.