

Nachdem Sie Ihr generatives KI-Modell erstellt und bewertet haben, können Sie es verwenden, um einen Agenten wie einen Chatbot zu erstellen. Mit dem Gen AI Evaluation Service können Sie die Fähigkeit Ihres KI-Agenten messen, Aufgaben und Ziele für Ihren Anwendungsfall zu erfüllen.
Übersicht
Sie haben die folgenden Möglichkeiten, Ihren Agenten zu bewerten:
Bewertung der endgültigen Antwort: Bewerten Sie die endgültige Ausgabe eines KI-Agenten (unabhängig davon, ob der KI-Agent sein Ziel erreicht hat oder nicht).
Ablaufbewertung: Bewerten Sie den Pfad (Sequenz von Toolaufrufen), den der Agent genommen hat, um die endgültige Antwort zu erhalten.
Mit dem Gen AI Evaluation Service können Sie die Ausführung eines Agenten auslösen und Messwerte für die Bewertung des Ablaufs und der endgültigen Antwort in einer einzigen Vertex AI SDK-Abfrage abrufen.
Unterstützte KI-Agenten
Der Gen AI Evaluation Service unterstützt die folgenden Kategorien von KI-Agenten:
| Unterstützte KI-Agenten | Beschreibung |
|---|---|
| KI-Agent, der mit der Vorlage von Agent Runtime erstellt wurde | Die Agent Runtime ist eine Plattform von Cloud de Confiance by S3NS , auf der Sie KI-Agenten bereitstellen und verwalten können. |
| LangChain-Agenten, die mit der anpassbaren Vorlage von Agent Runtime erstellt wurden | LangChain ist eine Open-Source-Plattform. |
| Benutzerdefinierte Agentenfunktion | Die benutzerdefinierte Agentenfunktion ist eine flexible Funktion, die einen Prompt für den Agenten annimmt und eine Antwort und einen Trajektorienverlauf in einem Wörterbuch zurückgibt. |
Messwerte für die Bewertung von KI-Agenten definieren
Messwerte für die Bewertung der endgültigen Antwort oder des Ausführungspfads definieren:
Bewertung der endgültigen Antwort
Die Bewertung der endgültigen Antwort erfolgt nach demselben Verfahren wie die Bewertung der Modellantwort. Weitere Informationen finden Sie unter Bewertungsmesswerte definieren.
Bewertung der Vorgehensweise
Mit den folgenden Messwerten können Sie die Fähigkeit des Modells bewerten, dem erwarteten Verlauf zu folgen:
Genaue Übereinstimmung
Wenn die vorhergesagte Trajektorie mit der Referenztrajektorie identisch ist und genau dieselben Toolaufrufe in genau derselben Reihenfolge enthält, gibt der Messwert trajectory_exact_match den Wert 1 zurück, andernfalls 0.
Eingabeparameter für Messwerte
| Eingabeparameter | Beschreibung |
|---|---|
predicted_trajectory |
Die Liste der Toolaufrufe, die der Agent verwendet hat, um die endgültige Antwort zu erhalten. |
reference_trajectory |
Die erwartete Toolnutzung für den KI-Agenten, um die Anfrage zu beantworten. |
Ausgabewerte
| Wert | Beschreibung |
|---|---|
| 0 | Die vorhergesagte Trajektorie stimmt nicht mit der Referenz überein. |
| 1 | Die vorhergesagte Trajektorie entspricht der Referenz. |
Übereinstimmung in der Reihenfolge
Wenn die vorhergesagte Trajektorie alle Toolaufrufe aus der Referenztrajektorie in derselben Reihenfolge enthält und möglicherweise auch zusätzliche Toolaufrufe hat, gibt der Messwert trajectory_in_order_match den Wert 1 zurück, andernfalls 0.
Eingabeparameter für Messwerte
| Eingabeparameter | Beschreibung |
|---|---|
predicted_trajectory |
Der vorhergesagte Ablauf, den der Agent verwendet hat, um die endgültige Antwort zu erhalten. |
reference_trajectory |
Die erwartete vorhergesagte Trajektorie für den Agenten, um die Anfrage zu erfüllen. |
Ausgabewerte
| Wert | Beschreibung |
|---|---|
| 0 | Die Toolaufrufe in der vorhergesagten Trajektorie stimmen nicht mit der Reihenfolge in der Referenztrajektorie überein. |
| 1 | Die vorhergesagte Trajektorie entspricht der Referenz. |
Any-order match
Wenn die vorhergesagte Trajektorie alle Toolaufrufe aus der Referenztrajektorie enthält, die Reihenfolge jedoch keine Rolle spielt und zusätzliche Toolaufrufe enthalten sein können, gibt der Messwert trajectory_any_order_match den Wert 1 zurück, andernfalls 0.
Eingabeparameter für Messwerte
| Eingabeparameter | Beschreibung |
|---|---|
predicted_trajectory |
Die Liste der Toolaufrufe, die der Agent verwendet hat, um die endgültige Antwort zu erhalten. |
reference_trajectory |
Die erwartete Toolnutzung für den KI-Agenten, um die Anfrage zu beantworten. |
Ausgabewerte
| Wert | Beschreibung |
|---|---|
| 0 | Die vorhergesagte Trajektorie enthält nicht alle Toolaufrufe in der Referenztrajektorie. |
| 1 | Die vorhergesagte Trajektorie entspricht der Referenz. |
Precision
Der Messwert trajectory_precision gibt an, wie viele der Toolaufrufe im vorhergesagten Verlauf gemäß dem Referenzverlauf tatsächlich relevant oder korrekt sind.
Die Precision wird so berechnet: Zählen Sie, wie viele Aktionen in der vorhergesagten Trajektorie auch in der Referenztrajektorie vorkommen. Teilen Sie diese Anzahl durch die Gesamtzahl der Aktionen in der vorhergesagten Trajektorie.
Eingabeparameter für Messwerte
| Eingabeparameter | Beschreibung |
|---|---|
predicted_trajectory |
Die Liste der Toolaufrufe, die der Agent verwendet hat, um die endgültige Antwort zu erhalten. |
reference_trajectory |
Die erwartete Toolnutzung für den KI-Agenten, um die Anfrage zu beantworten. |
Ausgabewerte
| Wert | Beschreibung |
|---|---|
| Eine Gleitkommazahl im Bereich [0,1] | Je höher der Wert, desto genauer ist die vorhergesagte Trajektorie. |
Recall
Der Messwert trajectory_recall gibt an, wie viele der wichtigen Toolaufrufe aus der Referenztrajektorie tatsächlich in der vorhergesagten Trajektorie erfasst werden.
Der Recall wird so berechnet: Zählen Sie, wie viele Aktionen in der Referenztrajektorie auch in der vorhergesagten Trajektorie vorkommen. Teilen Sie diese Anzahl durch die Gesamtzahl der Aktionen in der Referenztrajektorie.
Eingabeparameter für Messwerte
| Eingabeparameter | Beschreibung |
|---|---|
predicted_trajectory |
Die Liste der Toolaufrufe, die der Agent verwendet hat, um die endgültige Antwort zu erhalten. |
reference_trajectory |
Die erwartete Toolnutzung für den KI-Agenten, um die Anfrage zu beantworten. |
Ausgabewerte
| Wert | Beschreibung |
|---|---|
| Eine Gleitkommazahl im Bereich [0,1] | Je höher der Wert, desto besser ist der Recall der vorhergesagten Trajektorie. |
Nutzung eines einzelnen Tools
Mit dem Messwert trajectory_single_tool_use wird geprüft, ob ein bestimmtes Tool, das in der Messwertspezifikation angegeben ist, in der vorhergesagten Trajektorie verwendet wird. Die Reihenfolge der Toolaufrufe oder die Häufigkeit der Toolnutzung wird nicht geprüft, sondern nur, ob das Tool vorhanden ist oder nicht.
Eingabeparameter für Messwerte
| Eingabeparameter | Beschreibung |
|---|---|
predicted_trajectory |
Die Liste der Toolaufrufe, die der Agent verwendet hat, um die endgültige Antwort zu erhalten. |
Ausgabewerte
| Wert | Beschreibung |
|---|---|
| 0 | Das Tool ist nicht vorhanden. |
| 1 | Das Tool ist vorhanden. |
Außerdem werden den Bewertungsergebnissen standardmäßig die folgenden beiden Messwerte für die Agentenleistung hinzugefügt. Sie müssen sie nicht in EvalTask angeben.
latency
Zeit, die der KI-Agent für die Rückgabe einer Antwort benötigt.
| Wert | Beschreibung |
|---|---|
| Eine Gleitkommazahl | Berechnet in Sekunden. |
failure
Ein boolescher Wert, der angibt, ob der Agentenaufruf zu einem Fehler geführt hat oder erfolgreich war.
Ausgabewerte
| Wert | Beschreibung |
|---|---|
| 1 | Fehler |
| 0 | Gültige Antwort zurückgegeben |
Dataset für die Agentenbewertung vorbereiten
Bereiten Sie Ihr Dataset für die Bewertung der endgültigen Antwort oder der Vorgehensweise vor.
Das Datenschema für die Bewertung der endgültigen Antwort ähnelt dem der Bewertung der Modellantwort.
Für die rechenbasierte Trajektorienbewertung müssen in Ihrem Dataset die folgenden Informationen enthalten sein:
| Eingabetyp | Inhalt des Eingabefelds |
|---|---|
predicted_trajectory |
Die Liste der Toolaufrufe, die von den Agenten verwendet wurden, um die endgültige Antwort zu erhalten. |
reference_trajectory (nicht erforderlich für trajectory_single_tool_use metric) |
Die erwartete Toolnutzung für den KI-Agenten, um die Anfrage zu beantworten. |
Beispiele für Bewertungs-Datasets
Die folgenden Beispiele zeigen Datasets für die Trajektorienbewertung. reference_trajectory ist für alle Messwerte außer trajectory_single_tool_use erforderlich.
reference_trajectory = [
# example 1
[
  {
    "tool_name": "set_device_info",
    "tool_input": {
        "device_id": "device_2",
        "updates": {
            "status": "OFF"
        }
    }
  }
],
# example 2
[
    {
      "tool_name": "get_user_preferences",
      "tool_input": {
          "user_id": "user_y"
      }
  },
  {
      "tool_name": "set_temperature",
      "tool_input": {
          "location": "Living Room",
          "temperature": 23
      }
    },
  ]
]

predicted_trajectory = [
# example 1
[
  {
    "tool_name": "set_device_info",
    "tool_input": {
        "device_id": "device_3",
        "updates": {
            "status": "OFF"
        }
    }
  }
],
# example 2
[
    {
      "tool_name": "get_user_preferences",
      "tool_input": {
          "user_id": "user_z"
      }
    },
    {
      "tool_name": "set_temperature",
      "tool_input": {
          "location": "Living Room",
          "temperature": 23
      }
    },
  ]
]

eval_dataset = pd.DataFrame({
    "predicted_trajectory": predicted_trajectory,
    "reference_trajectory": reference_trajectory,
})
Bewertungs-Dataset importieren
Sie können Ihr Dataset in den folgenden Formaten importieren:
In Cloud Storage gespeicherte JSONL- oder CSV-Datei
BigQuery-Tabelle
Pandas-DataFrame
Der Gen AI Evaluation Service bietet öffentliche Beispiel-Datasets, um zu zeigen, wie Sie Ihre Agenten bewerten können. Der folgende Code zeigt, wie Sie die öffentlichen Datasets aus einem Cloud Storage-Bucket importieren:
# dataset name to be imported
dataset = "on-device" # Alternatives: "customer-support", "content-creation"

# copy the tools and dataset file
!gcloud storage cp gs://cloud-ai-demo-datasets/agent-eval-datasets/{dataset}/tools.py .
!gcloud storage cp gs://cloud-ai-demo-datasets/agent-eval-datasets/{dataset}/eval_dataset.json .

# load the dataset examples
import json

eval_dataset = json.loads(open('eval_dataset.json').read())

# run the tools file
%run -i tools.py
Dabei ist dataset eines der folgenden öffentlichen Datasets:
"on-device"für einen On-Device Home Assistant, der Smart-Home-Geräte steuert. Der Agent hilft bei Anfragen wie „Plane die Klimaanlage im Schlafzimmer so, dass sie zwischen 23:00 Uhr und 8:00 Uhr eingeschaltet ist und den Rest der Zeit ausgeschaltet ist.“"customer-support"für einen Kundensupport-Agenten. Der KI-Agent hilft bei Anfragen wie „Kannst du alle ausstehenden Bestellungen stornieren und alle offenen Support-Tickets eskalieren?“"content-creation"für einen Agenten zur Erstellung von Marketinginhalten. Der Agent hilft bei Anfragen wie „Kampagne X als einmalige Kampagne auf der Social-Media-Website Y mit einem um 50% reduzierten Budget nur am 25. Dezember 2024 neu planen“.
Bewertung von KI-Agenten ausführen
Führen Sie eine Bewertung für die Trajektorie oder die endgültige Antwort aus:
Für die Agentenbewertung können Sie Messwerte für die Antwortbewertung und Messwerte für die Trajektorienbewertung kombinieren, wie im folgenden Code gezeigt:
single_tool_use_metric = TrajectorySingleToolUse(tool_name='tool_name')

eval_task = EvalTask(
    dataset=EVAL_DATASET,
    metrics=[
        "rouge_l_sum",
        "bleu",
        custom_trajectory_eval_metric, # custom computation-based metric
        "trajectory_exact_match",
        "trajectory_precision",
        single_tool_use_metric,
        response_follows_trajectory_metric # llm-based metric
    ],
)
eval_result = eval_task.evaluate(
    runnable=RUNNABLE,
)
Messwertanpassung
Sie können einen auf einem Large Language Model basierenden Messwert für die Trajektorienbewertung mithilfe einer Vorlage oder von Grund auf neu anpassen. Weitere Informationen finden Sie unter Bewertungsmesswerte definieren. Hier ein Beispiel:
response_follows_trajectory_prompt_template = PointwiseMetricPromptTemplate(
    criteria={
        "Follows trajectory": (
            "Evaluate whether the agent's response logically follows from the "
            "sequence of actions it took. Consider these sub-points:\n"
            "  - Does the response reflect the information gathered during the trajectory?\n"
            "  - Is the response consistent with the goals and constraints of the task?\n"
            "  - Are there any unexpected or illogical jumps in reasoning?\n"
            "Provide specific examples from the trajectory and response to support your evaluation."
        )
    },
    rating_rubric={
        "1": "Follows trajectory",
        "0": "Does not follow trajectory",
    },
    input_variables=["prompt", "predicted_trajectory"],
)

response_follows_trajectory_metric = PointwiseMetric(
    metric="response_follows_trajectory",
    metric_prompt_template=response_follows_trajectory_prompt_template,
)
Sie können auch einen benutzerdefinierten rechenbasierten Messwert für die Bewertung der Vorgehensweise oder der Antwort definieren:
def essential_tools_present(instance, required_tools = ["tool1", "tool2"]):
    trajectory = instance["predicted_trajectory"]
    tools_present = [tool_used['tool_name'] for tool_used in trajectory]
    if len(required_tools) == 0:
      return {"essential_tools_present": 1}
    score = 0
    for tool in required_tools:
      if tool in tools_present:
        score += 1
    return {
        "essential_tools_present": score/len(required_tools),
    }

custom_trajectory_eval_metric = CustomMetric(name="essential_tools_present", metric_function=essential_tools_present)
Ergebnisse ansehen und interpretieren
Bei der Bewertung des Ausführungspfads oder der endgültigen Antwort werden die Bewertungsergebnisse so angezeigt:
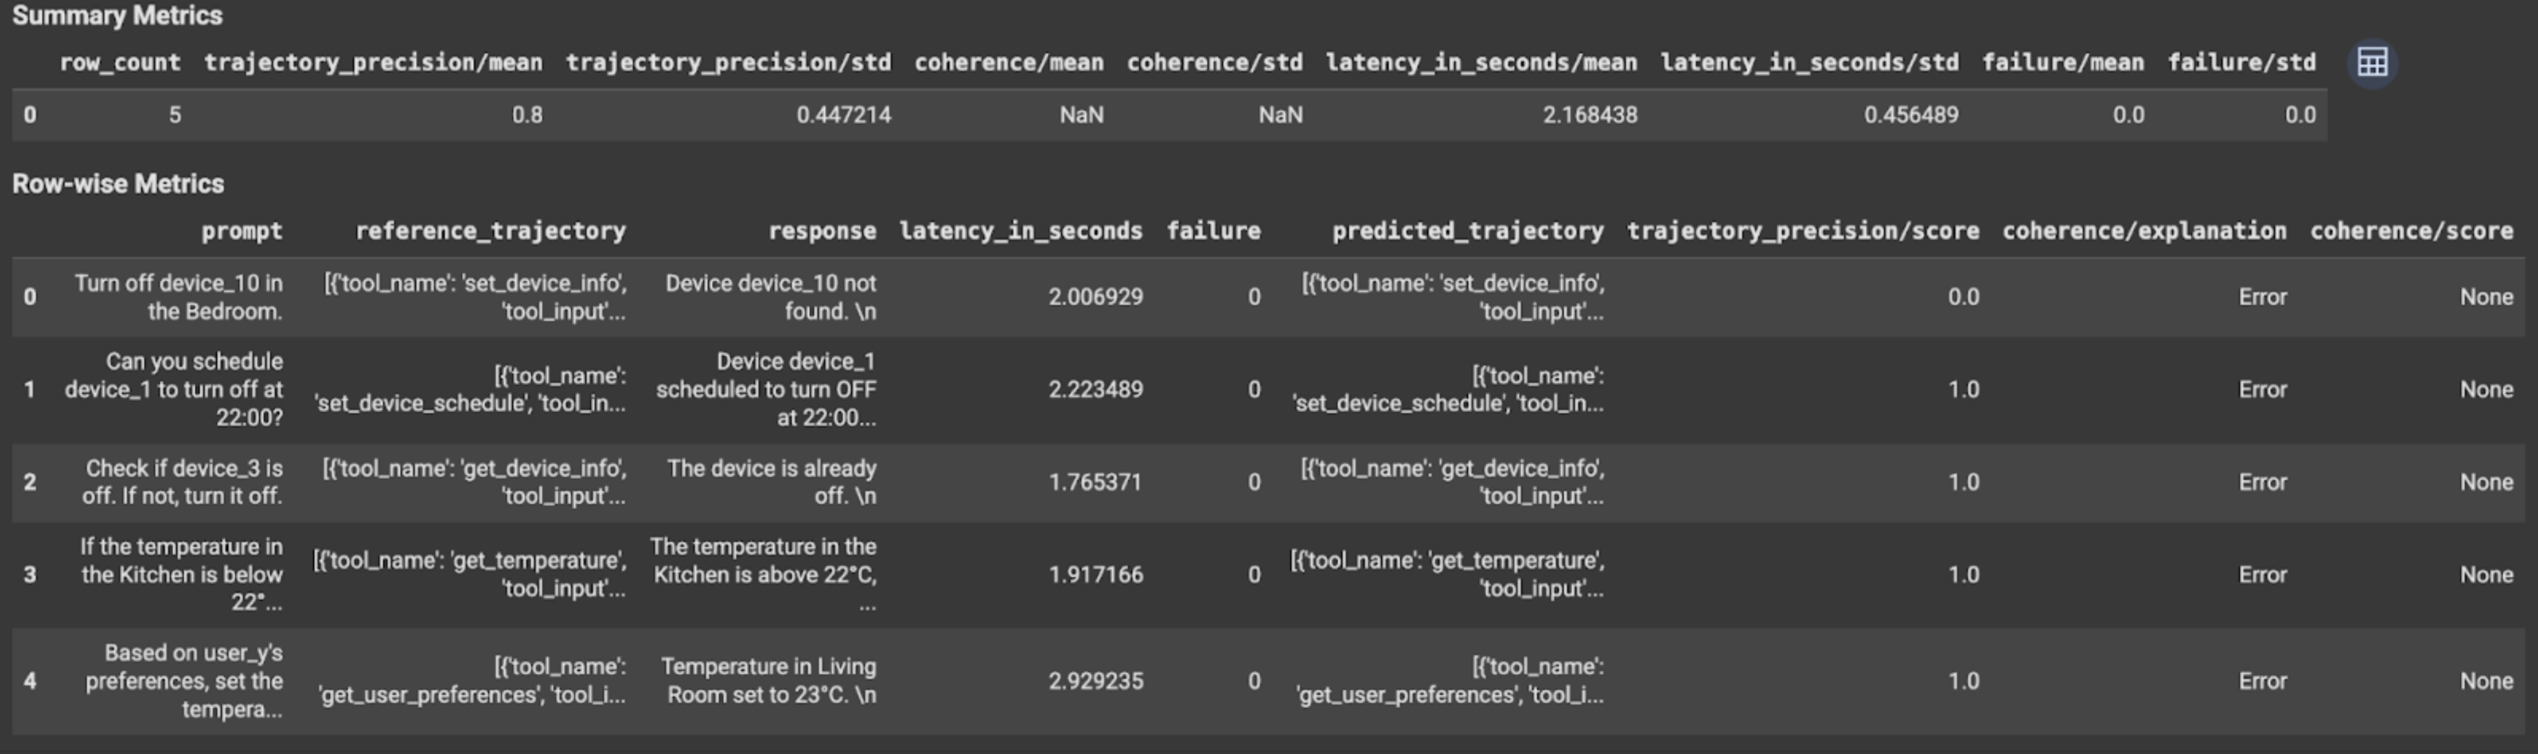
Die Bewertungsergebnisse enthalten die folgenden Informationen:
Messwerte für die endgültige Antwort
Ergebnisse auf Instanzebene
| Spalte | Beschreibung |
|---|---|
| Antwort | Die endgültige Antwort, die vom KI-Agenten generiert wurde. |
| latency_in_seconds | Zeit, die zum Generieren der Antwort benötigt wurde. |
| Fehler | Gibt an, ob eine gültige Antwort generiert wurde oder nicht. |
| Punktzahl | Ein Wert, der für die in der Messwertspezifikation angegebene Antwort berechnet wird. |
| Erklärung | Die Erläuterung für die in der Messwertspezifikation angegebene Punktzahl. |
Zusammengefasste Ergebnisse
| Spalte | Beschreibung |
|---|---|
| Mittel | Durchschnittliche Punktzahl für alle Instanzen. |
| Standardabweichung | Standardabweichung aller Punktzahlen. |
Messwerte für die Entwicklung
Ergebnisse auf Instanzebene
| Spalte | Beschreibung |
|---|---|
| predicted_trajectory | Abfolge von Toolaufrufen, die der Agent ausführt, um die endgültige Antwort zu erhalten. |
| reference_trajectory | Abfolge der erwarteten Toolaufrufe. |
| Punktzahl | Ein Wert, der für die vorhergesagte und die Referenzvorgehensweise berechnet wird, die in der Messwertspezifikation angegeben sind. |
| latency_in_seconds | Zeit, die zum Generieren der Antwort benötigt wurde. |
| Fehler | Gibt an, ob eine gültige Antwort generiert wurde oder nicht. |
Zusammengefasste Ergebnisse
| Spalte | Beschreibung |
|---|---|
| Mittel | Durchschnittliche Punktzahl für alle Instanzen. |
| Standardabweichung | Standardabweichung aller Punktzahlen. |
Agent2Agent-Protokoll (A2A)
Wenn Sie ein Multi-Agenten-System erstellen, empfehlen wir Ihnen dringend, sich das A2A-Protokoll anzusehen. Das A2A-Protokoll ist ein offener Standard, der eine nahtlose Kommunikation und Zusammenarbeit zwischen KI-Agenten ermöglicht, unabhängig von ihren zugrunde liegenden Frameworks. Es wurde im Juni 2025 von Cloud de Confiance by S3NS an die Linux Foundation gespendet. Wenn Sie die A2A SDKs verwenden oder die Beispiele ausprobieren möchten, rufen Sie das GitHub-Repository auf.
Nächste Schritte
Probieren Sie die folgenden Notebooks zur Agentenbewertung aus: