

Introducción a las consultas continuas
En este documento, se describen las consultas continuas de BigQuery.
Las consultas continuas de BigQuery son instrucciones de SQL que se ejecutan de forma continua. Las consultas continuas te permiten analizar datos entrantes en BigQuery en tiempo real. Puedes escribir o exportar las filas de resultado que genera una consulta continua a los siguientes destinos:
- Tablas de BigQuery
- Tablas administradas de Apache Iceberg
- Temas de Pub/Sub
- Tablas de Bigtable
- Tablas de Spanner
Las consultas continuas pueden procesar datos que se escribieron en tablas estándar de BigQuery a través de uno de los siguientes métodos:
- La API de BigQuery Storage Write (gRPC)
- La API de BigQuery Storage Write (REST)
- Carga por lotes
- La sentencia DML
INSERT - Sentencias de lenguaje de manipulación de datos (DML), como
DELETE,UPDATEyMERGEcuando se exportan datos a Pub/Sub. - Escribe los resultados de una consulta por lotes en una tabla permanente
- Escribir desde los resultados de una consulta continua de BigQuery en una tabla permanente
- Una suscripción de Pub/Sub a BigQuery
- Escribe desde Dataflow a BigQuery
- Escribe desde Datastream a BigQuery con el modo de escritura de solo anexar
Puedes usar consultas continuas para realizar tareas urgentes, como crear estadísticas y actuar de inmediato en función de ellas, aplicar inferencias de aprendizaje automático (AA) en tiempo real y replicar datos en otras plataformas. Esto te permite usar BigQuery como un motor de procesamiento de datos controlado por eventos para la lógica de decisión de tu aplicación.
En el siguiente diagrama, se muestran flujos de trabajo comunes de consultas continuas:
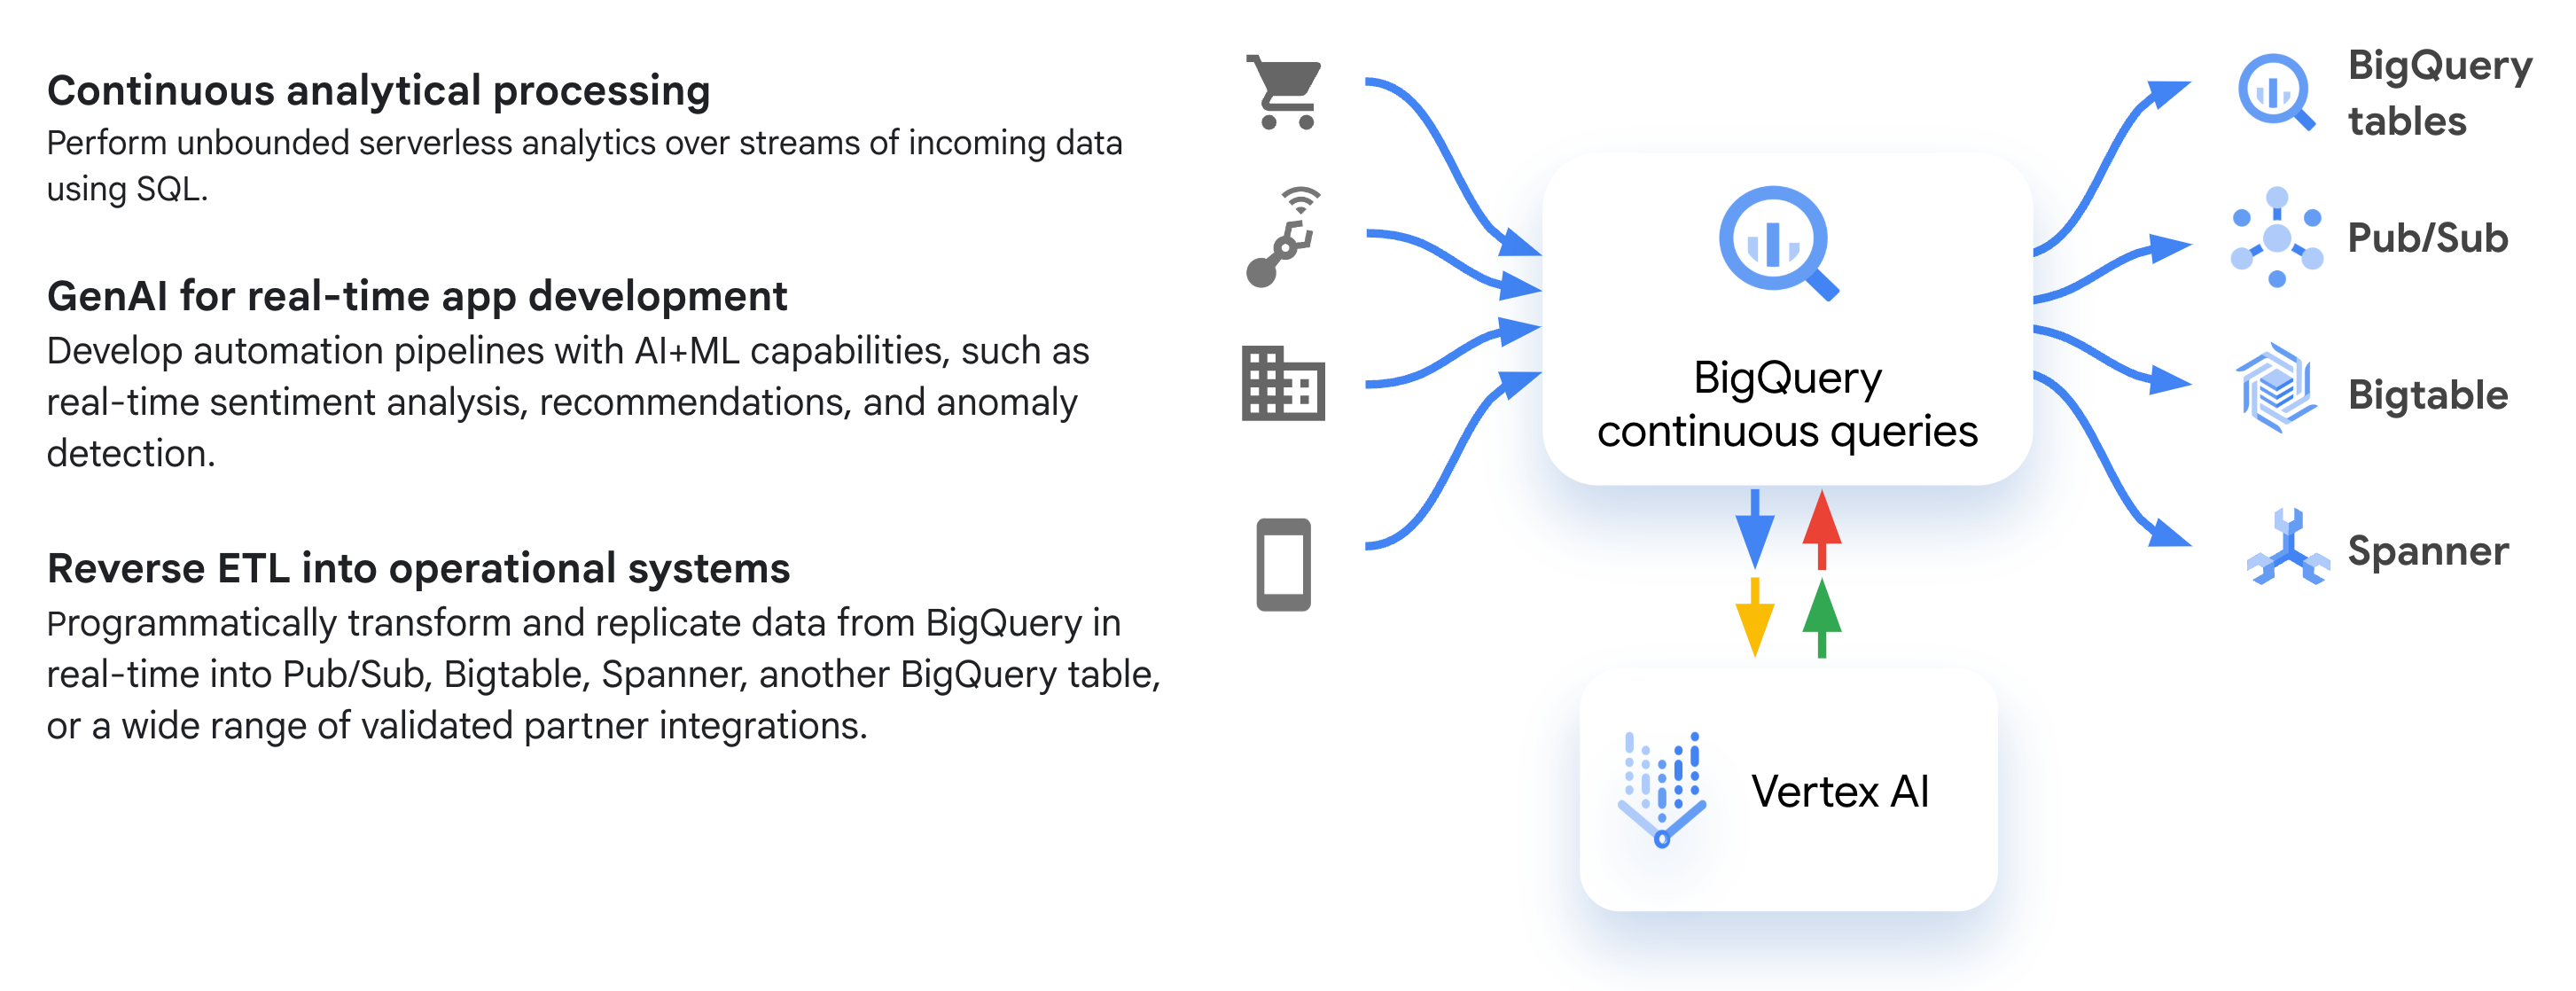
Casos de uso
Estos son algunos casos de uso comunes en los que tal vez quieras usar consultas continuas:
- Servicios de interacción personalizada con el cliente: Usa la IA generativa para crear mensajes personalizados para cada interacción con el cliente.
- Detección de anomalías: Compila soluciones que te permitan realizar la detección de anomalías y amenazas en datos complejos en tiempo real para que puedas reaccionar a los problemas con mayor rapidez.
- Canalizaciones basadas en eventos personalizables: Usa la integración continua de consultas con Pub/Sub para activar aplicaciones descendentes según los datos entrantes.
- Enriquecimiento de datos y extracción de entidades: Usa consultas continuas para realizar el enriquecimiento y la transformación de datos en tiempo real con funciones de SQL y modelos de AA.
- Extracción, transformación y carga inversa (ETL): Realiza ETL inverso en tiempo real en otros sistemas de almacenamiento más adecuados para la entrega de aplicaciones de baja latencia. Por ejemplo, analizar o mejorar los datos de eventos que se escriben en BigQuery y, luego, transmitirlos a Bigtable, Spanner o tablas administradas de Apache Iceberg para la entrega de aplicaciones.
- Activación autónoma de agentes: Activa canalizaciones de datos basadas en agentes en tiempo real según los eventos complejos detectados en los flujos de datos en vivo. Para ver un ejemplo, consulta el codelab Crea un agente de datos basado en eventos con BigQuery y el Kit de desarrollo de agentes (ADK).
- Supervisión autónoma de agentes: Desarrolla supervisión y alertas automatizadas en tiempo real para las interacciones de agentes en tiempo real con el complemento de análisis de agentes de BigQuery, que transmite todos los datos de seguimiento de agentes, el uso de herramientas y los registros operativos directamente a BigQuery para obtener una observabilidad profunda de tu personal de IA.
Funcionalidad admitida
Las siguientes operaciones son compatibles con las consultas continuas:
- Ejecutar
declaraciones
INSERTpara escribir datos de una consulta continua en una tabla de BigQuery o una tabla administrada de Iceberg Ejecutar sentencias
EXPORT DATApara publicar resultados de consultas continuas en temas de Pub/SubLas consultas continuas que exportan datos a Pub/Sub deben ejecutarse con una cuenta de servicio. Para obtener más información, consulta Exporta datos a Pub/Sub.
Desde un tema de Pub/Sub, puedes usar los datos con otros servicios, como realizar análisis de transmisiones a través de Dataflow o de los datos en un flujo de trabajo de Application Integration.
Ejecutar declaraciones
EXPORT DATApara exportar datos de BigQuery a tablas de Bigtable Para obtener más información, consulta Exporta datos a Bigtable.Ejecutar declaraciones
EXPORT DATApara exportar datos de BigQuery a tablas de Spanner Para obtener más información, consulta Exporta datos a Spanner (ETL inverso).Llama a las siguientes funciones de IA generativa:
AI.GENERATE-
- Esta función requiere que tengas un modelo remoto de BigQuery ML en un modelo de Gemini Enterprise Agent Platform.
Llama a las siguientes funciones de IA:
Estas funciones requieren que tengas un modelo remoto de BigQuery ML en una API de IA de Cloud.
Normalizar datos numéricos a través de la función
ML.NORMALIZER.Analizar y procesar datos de
JSON, incluida la compatibilidad con funciones JSON y anidamiento de JSONUsar funciones de GoogleSQL sin estado, por ejemplo, funciones de conversión En las funciones sin estado, cada fila se procesa de forma independiente de las otras filas de la tabla.
Usar operaciones con estado, por ejemplo,
JOIN, agregaciones y agregaciones de ventanas En las operaciones con estado, el estado de los datos transferidos se conserva en varias filas o intervalos de tiempo para calcular un resultado preciso.Usar la función del historial de cambios
APPENDSpara procesar los datos agregados desde un momento específicoUsar la función del historial de cambios
CHANGESpara procesar los datos modificados, incluidas las mutaciones y las anexiones, desde un momento específico cuando se exportan datos a Pub/Sub Sin embargo,CHANGESno se admite cuando se usa una operación con estado.Consultar vistas, siempre y cuando la consulta en SQL subyacente de la vista sea una consulta continua válida
Operaciones con estado admitidas
Para solicitar asistencia o enviar comentarios sobre esta función, envía un correo electrónico a bq-continuous-queries-feedback@google.com.
Las operaciones con estado permiten que las consultas continuas realicen análisis complejos que requieren retener información en varias filas o intervalos de tiempo. Si bien las funciones sin estado procesan cada fila de forma independiente, las operaciones con estado mantienen el estado de los datos ingeridos para admitir funciones como JOINs, agregaciones y agregaciones de ventanas. Esta capacidad te permite correlacionar eventos de diferentes flujos o calcular métricas a lo largo del tiempo (por ejemplo, un promedio de 30 minutos) almacenando los datos necesarios en la memoria mientras se ejecuta la consulta.
Las consultas continuas admiten las siguientes operaciones con estado:
Autorización
Los tokens de acceso deCloud de Confiance que se usan cuando se ejecutan trabajos de consulta continua tienen un tiempo de actividad (TTL) de dos días cuando los genera una cuenta de usuario. Por lo tanto, estos trabajos se dejan de ejecutar después de dos días. Los tokens de acceso que generan las cuentas de servicio pueden ejecutarse durante más tiempo, pero deben cumplir con el tiempo de ejecución máximo de la consulta. Para obtener más información, consulta Ejecuta una consulta continua con una cuenta de servicio.
Ubicaciones
Para obtener una lista de las regiones admitidas, consulta Ubicaciones de las consultas continuas de BigQuery.
Limitaciones
Las consultas continuas de Spanner están sujetas a las siguientes limitaciones:
- El estado de los datos ingeridos solo se mantiene para las operaciones con estado específicas en la versión preliminar.
Si bien las consultas continuas ahora admiten algunos tipos de
JOIN, agregaciones y agregaciones de ventanas, estos se restringen a operaciones con estado específicas. No se admiten todos los tipos de operaciones con estado. No puedes usar las siguientes funciones de SQL en una consulta continua, a menos que se indiquen como una operación con estado compatible:
Los siguientes operadores de consulta:
Consulta operadores de conjuntos
Funciones de BigQuery ML distintas de las enumeradas en Funcionalidad compatible
Sentencias del lenguaje de manipulación de datos (DML), excepto
INSERTSentencias de
EXPORT DATAque no se orientan a Bigtable, Pub/Sub ni Spanner.
Las consultas continuas no admiten las siguientes fuentes de datos:
- Tablas externas
- Vistas de Information Schema.
- Tablas administradas de Apache Iceberg. Ten en cuenta que, si bien las tablas administradas de Iceberg no se admiten como fuentes de datos, sí se admiten como destinos para la salida de consultas continuas.
- Tablas comodín.
- Datos de inserción/actualización de la captura de datos modificados (CDC)
- Vistas materializadas
- Vistas en las que la consulta en SQL subyacente usa funciones no admitidas, como funciones definidas por el usuario, tablas externas o tablas habilitadas para CDC
Las consultas continuas no admiten las funciones de seguridad column- ni a nivel de fila.
El resultado de una consulta continua está sujeto a las cuotas y los límites inherentes del servicio de destino al que se exporta el resultado.
Cuando exportas datos a Bigtable, Spanner o endpoints de ubicación de Pub/Sub, solo puedes segmentar recursos de Bigtable, Spanner o Pub/Sub que se encuentren dentro del mismo límite regional de Cloud de Confianceque el conjunto de datos de BigQuery que contiene la tabla que estás consultando. Esta restricción no se aplica cuando se exportan datos a los extremos globales de Pub/Sub. Para obtener más información sobre la exportación a una política de enrutamiento de perfil de app de Bigtable, consulta Consideraciones sobre la ubicación.
No puedes ejecutar una consulta continua desde un lienzo de datos.
No puedes modificar el SQL que se usa en una consulta continua mientras se ejecuta el trabajo de consulta continua. Para obtener más información, consulta Modifica el SQL de una consulta continua.
Si un trabajo de consulta continua se retrasa en el procesamiento de los datos entrantes y tiene un retraso en la marca de agua de salida de más de 48 horas, fallará. Puedes volver a ejecutar la consulta y usar la función de historial de cambios
APPENDSoCHANGESpara reanudar el procesamiento desde el momento en el que detuviste el trabajo de la consulta continua anterior. Para obtener más información, consulta Inicia una consulta continua desde un momento en particular.Una consulta continua configurada con una cuenta de usuario puede ejecutarse hasta por dos días. Una consulta continua configurada con una cuenta de servicio puede ejecutarse hasta por 150 días. Cuando se alcanza el tiempo de ejecución máximo de la consulta, esta falla y deja de procesar los datos entrantes.
Si bien las consultas continuas se compilan con las funciones de confiabilidad de BigQuery, pueden ocurrir problemas temporales ocasionales. Los problemas pueden provocar un cierto nivel de reprocesamiento automático de tu consulta continua, lo que podría generar datos duplicados en el resultado de la consulta continua. Diseña tus sistemas downstream para que controlen estas situaciones.
Limitaciones de las reservas
- Debes crear una reserva de la edición Enterprise o Enterprise Plus con un
CONTINUOUStipo de asignación para ejecutar consultas continuas. Las consultas continuas no son compatibles con el modelo de facturación de procesamiento a pedido. - Cuando creas una
CONTINUOUSasignación de reserva, la reserva asociada se limita a un máximo de 500 ranuras. Para solicitar un aumento de este límite, comunícate con bq-continuous-queries-feedback@google.com. - No puedes crear una asignación de reserva que use un tipo de trabajo diferente en la misma reserva que una asignación de reserva de consulta continua.
BigQuery determina la cantidad de consultas continuas que se pueden ejecutar de forma simultánea por proyecto según el tamaño configurado de la asignación de reserva que usa el tipo de trabajo
CONTINUOUS. Para admitir trabajos nuevos, BigQuery requiere un umbral de 10 ranuras por trabajo de consulta continua. La consulta no necesariamente consume las 10 ranuras durante la ejecución normal. Este umbral garantiza que cada consulta continua en ejecución mantenga suficiente capacidad de procesamiento de referencia para controlar los aumentos repentinos en el volumen de datos entrantes sin retrasarse ni comprometer el procesamiento de baja latencia.Para asegurarte de que tus consultas se admitan correctamente sin alcanzar los límites de simultaneidad, te recomendamos que uses el ajuste de escala automático de ranuras. Con el ajuste de escala automático, el uso general de ranuras se ajustará dinámicamente según la demanda real de recursos. Puedes configurar una reserva de referencia más pequeña y establecer un límite máximo de ajuste de escala automático que cubra cómodamente el umbral de 10 ranuras por consulta para las consultas simultáneas esperadas.
Cuando se ejecutan varias consultas continuas con la misma reserva, es posible que los trabajos individuales no dividan los recursos disponibles de manera equitativa, como se define en la equidad de BigQuery.
Ajuste de escala automático de ranuras
Las consultas continuas pueden usar el ajuste de escala automático de ranuras para escalar de forma dinámica la capacidad asignada y satisfacer tu carga de trabajo. A medida que tu carga de trabajo de consultas continuas aumenta o disminuye, BigQuery ajusta tus ranuras de forma dinámica.
Después de que se comienza a ejecutar una consulta continua, esta escucha de forma activa los datos entrantes, lo que consume recursos de ranuras. Si bien una reserva con una consulta continua en ejecución no se reduce a cero ranuras, se espera que una consulta continua inactiva que principalmente escucha los datos entrantes consuma una cantidad mínima de ranuras, por lo general, alrededor de 1 ranura.
Uso compartido de ranuras inactivas
Las consultas continuas pueden usar el uso compartido de ranuras inactivas para compartir recursos de ranuras sin usar con otras reservas y tipos de trabajos.
- Aún se requiere una
CONTINUOUSasignación de reserva para ejecutar una consulta continua y no se puede depender únicamente de las ranuras inactivas de otras reservas. Por lo tanto, la asignación de una reserva deCONTINUOUSrequiere una referencia de ranuras distinta de cero o una configuración de ajuste de escala automático de ranuras distinta de cero. - Solo se pueden compartir las ranuras de modelo de referencia inactivas o las ranuras confirmadas de una asignación de reserva de
CONTINUOUS. Las ranuras con ajuste de escala automático no se pueden compartir como ranuras inactivas para otras reservas.
Precios
Las consultas continuas pueden usar el ajuste de escala fluido de BigQuery.
Las consultas continuas usan los
precios de procesamiento de la capacidad de BigQuery,
que se miden en ranuras.
Para ejecutar consultas continuas, debes tener una
reserva que use la
Edición Enterprise o Enterprise Plus,
y una asignación de reserva
que usa el tipo de trabajo CONTINUOUS.
El uso de otros recursos de BigQuery, como la transferencia y el almacenamiento de datos, se cobra según las tarifas que se muestran en los precios de BigQuery.
El uso de otros servicios que reciben resultados de consultas continuas o a los que se llama durante el procesamiento continuo de consultas se cobra según las tarifas publicadas para esos servicios. Para obtener información sobre los precios de otros servicios de Cloud de Confiance by S3NS que se usan en las consultas continuas, consulta los siguientes temas:
Cómo estimar los requisitos de capacidad de las ranuras
Debido a que cada carga de trabajo es diferente, a menudo no es posible realizar una estimación exacta de las ranuras para las búsquedas continuas por adelantado. La cantidad de ranuras que requieren tus consultas continuas depende de una combinación de varios factores:
- Es la cantidad de consultas continuas que se ejecutan de forma simultánea.
- Es la complejidad de la instrucción de SQL.
- El uso de funciones de procesamiento con estado, incluidas las duraciones de las ventanas, los
JOINy las agregaciones - Es la tasa o velocidad de los datos entrantes.
- La estructura y el tamaño de los datos que se transfieren.
Conceptualmente, puedes estimar tu requisito total de ranuras como una función de tu carga de trabajo de consultas continuas:
Ranuras estimadas ≈ Cantidad de consultas continuas x ∑ (Tasa de datos x Complejidad de la consulta)
Dado que el consumo real de ranuras depende en gran medida de tus patrones únicos de carga de trabajo y datos, el método más preciso para estimar el costo es supervisar un trabajo en ejecución. Puedes medir el uso máximo de ranuras de una ejecución de consulta continua aislada con las vistas INFORMATION_SCHEMA. Para obtener instrucciones detalladas y ejemplos de consultas para hacer un seguimiento del uso de ranuras a lo largo del tiempo, consulta Cómo ver la información sobre el consumo de ranuras.
¿Qué sigue?
Intenta crear una consulta continua.