

移行リネージを使用して移行を計画する
移行リネージ サービスを使用すると、BigQuery データ ウェアハウスの移行を計画するときに、ソース データベースのデータフローと接続を可視化できます。
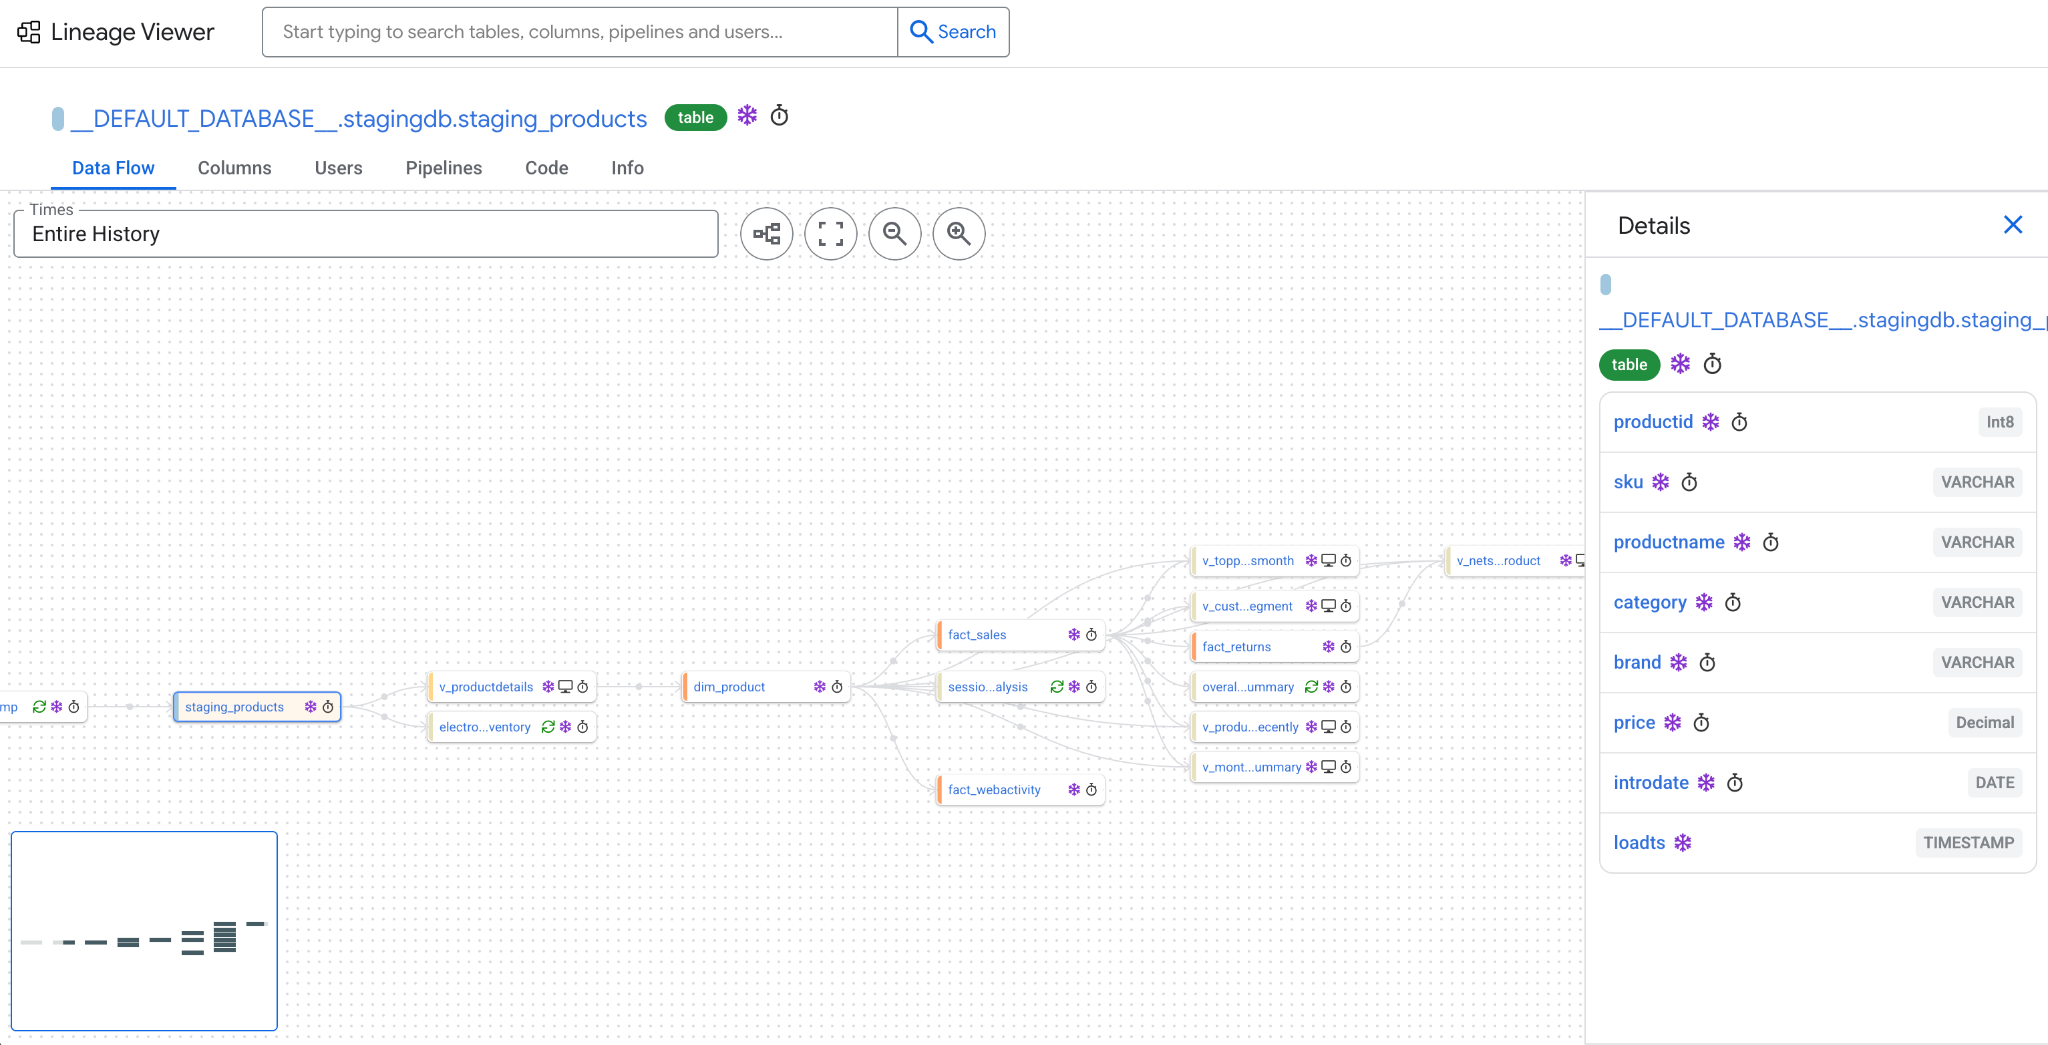
移行リネージを作成すると、リネージ サービスは、次の図に示すように、データがソースシステム内をどのように移動するか、ソースシステム内の各テーブルまたはビューがどのように接続されているかを可視化するグラフを提供します。
移行リネージ サービスは、次の SQL 言語をサポートしています。
- Amazon Redshift SQL
- Snowflake SQL
- Teradata SQL
- GoogleSQL(BigQuery)
制限事項
リネージ サービスは、ソース データベースから最も古いログの最初の 5 GB を処理します。
サポートされているロケーション
移行リネージ サービスは、一部のロケーションで利用できます。詳細については、BigQuery SQL トランスレータとリネージ サービスのロケーションをご覧ください。
必要な権限
移行リネージ サービスを使用するために必要な権限を取得するには、プロジェクトに対する移行ワークフロー編集者 (roles/bigquerymigration.editor)IAM ロールを付与するよう管理者に依頼してください。ロールの付与については、プロジェクト、フォルダ、組織に対するアクセス権の管理をご覧ください。
この事前定義ロールには、移行リネージ サービスを使用するために必要な権限が含まれています。必要とされる正確な権限については、「必要な権限」セクションを開いてご確認ください。
必要な権限
移行リネージ サービスを使用するには、次の権限が必要です。
-
bigquerymigration.workflows.create -
bigquerymigration.workflows.get -
bigquerymigration.lineageDbs.query
カスタムロールや他の事前定義ロールを使用して、これらの権限を取得することもできます。
BigQuery での IAM のロールと権限の詳細については、BigQuery の IAM ロールと権限をご覧ください。
移行リネージをトレースする
移行リネージをトレースするには、まず dwh-migration-dumper ツールを実行して、Cloud Storage にアップロードするソース入力 SQL ログファイルを生成します。入力ファイルを Cloud Storage にアップロードしたら、 Cloud de Confiance コンソールまたは BigQuery Migration API を使用して移行リネージをトレースできます。
dwh-migration-dumper ツールを実行する
次のオプションのいずれかを選択します。
Amazon Redshift
Amazon Redshift データベースで移行リネージをトレースして表示する手順は次のとおりです。
dwh-migration-dumperツールを実行して、ソースシステム ファイルのダンプを生成します。- クエリログを Cloud Storage にアップロードする。
Snowflake
Snowflake データベースで移行リネージをトレースして表示する手順は次のとおりです。
dwh-migration-dumperツールを実行して、ソースシステム ファイルのダンプを生成します。- クエリログを Cloud Storage にアップロードする。
Teradata
Teradata データベースで移行リネージをトレースして表示する手順は次のとおりです。
dwh-migration-dumperツールを実行して、ソースシステム ファイルのダンプを生成します。- クエリログを Cloud Storage にアップロードする。
BigQuery
BigQuery データベースで移行リネージをトレースして表示する手順は次のとおりです。
- アカウントまたはサービス アカウントに次のロールを付与します。
- BigQuery メタデータ閲覧者(
roles/bigquery.metadataViewer) - Data Catalog 閲覧者(
roles/datacatalog.viewer)
- BigQuery メタデータ閲覧者(
dwh-migration-dumperツールをインストールします。メタデータとクエリログを生成するには、
dwh-migration-dumperツールを実行します。これらのメタデータとクエリログは、1 つ以上の ZIP ファイルに含まれています。dwh-migration-dumper --connector bigquery dwh-migration-dumper --connector bigquery-logs
ZIP ファイルを Cloud Storage バケットにアップロードします。バケットの作成と Cloud Storage へのファイルのアップロードの詳細については、バケットを作成するとファイル システムからオブジェクトをアップロードするをご覧ください。
リネージをトレース
メタデータとクエリログを含む ZIP ファイルを Cloud Storage にアップロードすると、リネージをトレースできます。次のいずれかのオプションを選択します。
コンソール
[移行サービス] ページに移動します。
[リネージのトレース] で、[変換をトレース] をクリックします。
[リネージ構成] に、次のように入力します。
- [表示名] に、リネージジョブの名前を指定します。名前には文字、数字、アンダースコアを使用できます。
- [処理を行うロケーション] で、リネージジョブを実行するロケーションを選択します。
[入力ディレクトリの場所を編集] に、先ほどアップロードしたログ ZIP ファイルを含む Cloud Storage フォルダへのパスを指定します。パスを
bucket_name/folder_name/の形式で入力するか、[参照] をクリックします。[出力サブディレクトリ名] フィールドで、出力ファイルのサブディレクトリに名前を付けることもできます。[入力ディレクトリの場所を追加] をクリックすると、入力ファイルを追加できます。
[Trace] をクリックします。
リネージジョブが実行中です。入力サイズによっては、ジョブが完了するまでに数時間かかることがあります。ジョブが完了すると、トレースされた移行リネージへのリンクが表示されます。
API
リネージジョブをトレースするには、次の curl コマンドを実行します。
  curl -d "{
    \"tasks\": {
      \"TASK_NAME\": {
        \"type\": \"Experimental_Lineage\",
        \"translation_details\": {
          \"target_base_uri\": \"BUCKET_PATH\",
          \"source_target_mapping\": {
            \"source_spec\": {
              \"base_uri\": \"BUCKET_PATH\"
            }
          },
          \"target_types\": \"LINEAGE\"
        }
      }
    }
  }
  " \
    -H "Content-Type:application/json" \
    -H "Authorization: Bearer TOKEN" -X POST https://bigquerymigration.googleapis.com/v2/projects/PROJECT_ID/locations/LOCATION/workflows
次のように置き換えます。
TASK_NAME: このリネージジョブを識別する名前。BUCKET_PATH: 入力 ZIP ファイルを含む Cloud Storage バケットへのパス。PROJECT_ID:Cloud de Confiance プロジェクトのプロジェクト ID。LOCATION: 処理ロケーション。この値はeuまたはusにする必要があります。
この呼び出しにより、次のようなメッセージが返されます。
  {
    "name": "projects/PROJECT_ID/locations/LOCATION/workflows/WORKFLOW_ID",
    "tasks": {
      "task_name": { /*...*/ }
    },
    "state": "RUNNING"
  }
リネージジョブが実行中です。入力サイズによっては、ジョブが完了するまでに数時間かかることがあります。リネージジョブのステータスを確認するには、ワークフロー ID を指定して次の curl コマンドを実行します。
  curl \
  -H "Content-Type:application/json" \
  -H "Authorization:Bearer " -X GET https://bigquerymigration.googleapis.com/v2/projects/PROJECT_ID/locations/LOCATION/workflows/WORKFLOW_ID
ジョブが完了すると、トレースされたリネージビューへのリンクが表示されます。
移行リネージを開く
移行リネージをトレースしたら、次のいずれかのオプションを使用して移行リネージを開くことができます。
コンソール
[移行サービス] ページに移動します。
[Trace Lineage] で [View recent] をクリックします。
[移行リネージ] ページで、ジョブ名をクリックして、完了したリネージジョブを選択します。
[変換の詳細] ページで、[データリネージ] をクリックします。
API
完了した移行リネージを開くには、BigQuery Migration API を使用して次の curl コマンドを実行します。
  curl \
  -H "Content-Type:application/json" \
  -H "Authorization:Bearer " -X GET https://bigquerymigration.googleapis.com/v2/projects/PROJECT_ID/locations/LOCATION/workflows/WORKFLOW_ID
次のように置き換えます。
PROJECT_ID:Cloud de Confiance プロジェクトのプロジェクト ID。LOCATION: 処理ロケーション。この値はeuまたはusにする必要があります。WORKFLOW_ID: トレースされたリネージのワークフロー ID。
出力メッセージの taskResult.translationTaskResult.consoleUri フィールドに含まれているリンクに移動します。
移行リネージを操作する
以降のセクションでは、移行リネージを使用してソースデータとデータベースを操作する方法について説明します。
移行リネージの用語を理解する
移行リネージでは、次の用語が使用されます。
| 利用規約 | 説明 |
|---|---|
| スクリプト | リネージの構築中に取り込まれたデータベース ログに表示される SQL スクリプトやその他のプログラム。スクリプトはステートメントで構成されます。最も一般的なのは単一の SQL ステートメントです。 |
| ノード | リネージグラフの頂点。これらはテーブルと列で構成されます。 |
| テーブル | リレーションとも呼ばれ、通常のテーブル、ビュー、構造化ファイル、その他のテーブルのようなリソースが含まれます。 |
| 列 | 属性とも呼ばれます。テーブル列、ビュー プロジェクション、疑似列、ファイルやその他のリソースの列のようなフィールド、構造体フィールドなどのサブ列が含まれます。 |
| エッジ | リネージノード間の接続。これらのノードを読み取りまたは書き込みするスクリプトを実行するパイプラインによるインタラクションを示します。エッジには、エッジが派生したときのタイムスタンプ、述語、その他のメタデータがアノテーションとして付加されます。エッジで別のノードに隣接しているノードは、直接接続と呼ばれます。2 つのノード間のエッジのパスは、間接接続と呼ばれます。 |
| リネージエッジ | ソースノードがターゲット ノードのデータに影響を与えた FROM、WHERE、GROUP BY などの句に含まれていたことを示す方向エッジ。 |
| ユーザーとパイプライン | スクリプトを実行したユーザーと内容に関する、ソース データベースから提供されるメタデータ ラベル。リネージ エンジンに固有の意味はありませんが、スクリプトをオリジン別にグループ化するために使用されます。 |
以降のセクションでは、移行リネージのさまざまなページについて説明します。
ランディング ページを確認する
リネージの移行のランディング ページには、リネージジョブの ID、名前でリネージ オブジェクトを検索するための検索フィールド、関心のあるリネージ オブジェクトをハイライト表示する候補リストが表示されます。このページには、移行リネージ全体のテーブル、パイプライン、ユーザーの合計数も表示されます。
特定のテーブル、ビュー、列に移動するには、検索フィールドでオブジェクトを検索するか、ランディング ページで提案されたオブジェクトのいずれかをクリックします。
ノードページを確認する
移行リネージのノードを確認するには、次のいずれかのタブをクリックします。
[Data Flow] タブ
[データフロー] タブには、リネージグラフの一部が視覚的に表示されます。これは、リネージ サービスでテーブルまたは列を初めて表示したときに表示されるデフォルトのページです。このグラフは、データがソースシステム内をどのように移動するかを可視化します。このグラフのノードはテーブルまたはビューを表し、ノード間のエッジは左側のノードから右側のノードに流れるデータを表します。
データフロー グラフの各テーブルには、非修飾名が表示されます。データベースとスキーマの接頭辞を含むテーブルの完全修飾名を表示するには、ノードの上にポインタを置いてツールチップを表示します。各テーブルは、ノードの縦棒で示されるスキーマを示します。リネージ内のすべてのスキーマはアルファベット順に並べ替えられ、色が割り当てられます。同じスキーマ内のテーブルには同じ色のバーがあり、名前が似ているスキーマ内のテーブルには同じ色のバーがあります。
各ノードには、ノードのプロパティを示すアイコンが表示されます。
- monitor: テーブルではなくビュー。
- cached: 常に完全に更新(切り捨て、書き換え)されるテーブル。このアイコンをクリックすると、このテーブルに隣接するスクリプトが表示されます。
- キャッシュ: 常に完全に更新されるとは限らないテーブル(切り捨てられてから書き換えられる)。アイコンをクリックすると、このテーブルに隣接するスクリプトが表示されます。
- timer: 存続期間が短いテーブル。アイコンにポインタを合わせると、テーブルが存在していた期間が表示されます。
- snowflake: 最終書き込みが 7 日以上前のテーブル。静的データまたは書き込み頻度の低いデータを含むテーブルであることを示します。
データフロー グラフのオブジェクトを確認するには、次の操作を行います。
- テーブル列のリストを表示するには、テーブルをクリックします。このビューには、各列の名前とデータ型が含まれます。これらは、提供されたメタデータ ダンプから決定されるか、クエリログに表示される SQL から推測されます。
- 列の列レベルのリネージグラフを表示するには、列をクリックします。列レベルのリネージグラフでは、エッジはターゲット列に影響するデータフローを表します。
エッジの詳細を表示するには、グラフ内のエッジをクリックします。このビューには、エッジを誘発した SQL スクリプトへのリンクが含まれています。
SQL ステートメントがターゲット ノードに挿入されるデータを計算しているときに、SQL ステートメントがソースノードを参照すると、ソースノードからターゲット ノードへのエッジが生成されます。通常、これにはソースからターゲットへのデータの転送が含まれますが、[データフロー] タブには、ソースノードがターゲットに影響する
WHERE句またはGROUP BY句で使用されている場合もエッジが表示されます。データ転送のみをフィルタするには、ツールバーの [データ以外のエッジを表示] ボタンを切り替えます。
[接続] タブ
リネージノードの [接続] タブには、リネージグラフ内の近くのノードのリストが表示されます。デフォルトでは、接続されたノードは、現在のノードからの最短パスの距離で並べ替えられます。現在のノードから到達するために必要なエッジが少ないノードが最初に表示されます。並べ替えは [並べ替え] オプションで変更できます。
接続リストには、デフォルトで現在のノードの上流(プロデューサー)ノードと下流(コンシューマー)ノードの両方が含まれます。このフィルタは、[タイプ] コントロールで変更できます。[距離] 列では、現在のノードの上流にあるノードは、現在のノードからそのノードへの最短の逆方向パスの距離とともに上向きの矢印で表示されます。同様に、現在のノードの下流にあるノードは、現在のノードからそのノードへの最短の順方向パスの距離とともに下向きの矢印で表示されます。ノードがサイクルの一部である場合、現在のノードの上流と下流の両方に存在することがあります。
表示されているすべてのノードを含むファイルをダウンロードするには、[ダウンロード] CSV をクリックします。
[Users(ユーザー)] タブ
ノードの [ユーザー] タブには、ノード、またはそのアップストリームまたはダウンストリームのノードを読み取りまたは書き込みするスクリプトを実行したユーザーが表示されます。デフォルトでは、最も多くのアクションを実行したユーザーが最初に表示されます。並べ替えは [並べ替え] オプションで変更できます。
表示されているすべてのユーザーを含むファイルをダウンロードするには、[download CSV] をクリックします。
[パイプライン] タブ
ノードの [パイプライン] タブには、ノードを読み取りまたは書き込みしたスクリプトを実行したパイプライン、またはそのアップストリームまたはダウンストリームのノードが表示されます。デフォルトでは、最も多くのアクションを実行したパイプラインが最初に表示されます。並べ替えは [並べ替え] オプションで変更できます。
表示されているすべてのパイプラインを含むファイルをダウンロードするには、[ダウンロード CSV] をクリックします。
コードタブ
ノードの [コード] タブには、そのノードからデータを読み取るか、そのノードにデータを書き込む入力ファイルに表示されるすべての SQL スクリプトが表示されます。ノードの言及は SQL テキストでハイライト表示されます。スクリプトをクリックすると、全文が表示されます。フィルタ設定を変更して、表示されるスクリプトのリストをフィルタできます。
表示されているすべてのスクリプトを含むファイルをダウンロードするには、[download CSV] をクリックします。
エッジページを確認する
リネージグラフでノードエッジを確認するには、次のいずれかのタブをクリックします。
[詳細] タブ
エッジの [詳細] タブには、エッジを誘発したスクリプトによって実行されたオペレーションを説明する述語とカテゴリが表示されます。
述語は、ハイフンで区切られた 3 つの部分からなるコードとして表記されます。最初の部分は、エッジのソースが関係であることを示す r か、エッジのソースが属性であることを示す a のいずれかです。2 番目の部分は、ソースノードがターゲット ノードのデータに影響を与えた方法を示す次のいずれかの略語です。
has: ソース関係にターゲット属性が含まれている。dat: ソースはデータをターゲットにコピーまたは転送します。res: ソースは、WHERE、HAVING、JOIN ONなどの句でターゲットのカーディナリティをフィルタリングまたは制限します。grp: ソースは、ターゲットに影響するGROUP BY句で使用されます。
3 番目の部分も r または a で、エッジのターゲットが関係か属性かを示します。
エッジのカテゴリには、次のものがあります。
dat述語:AGGREGATE: ソースは、ターゲットを書き込んだ集計計算で使用されました。EXACT_COPY: ソースのデータがターゲットに完全にコピーされました。FUNCTION: ソースがターゲットの計算に使用された。IDENTITY_COPY: ターゲットが計算されませんでした。ターゲットは、キャストや変換を行わないソースのリテラル コピーでした。PARTITION_PROMOTION: ターゲットには、ソースのパーティションをターゲットにプロモートした結果として、ソースのデータが含まれます。WEAK_COPY: ソースのデータがターゲットに少なくとも部分的にコピーされました。
res述語:FILTER: ソースは、ターゲットを書き込んだ比較で使用されました。KEY: ソースのデータが、ターゲットを書き込んだ結合比較のキーとして使用されました。
grp述語:GROUP: ソースのデータが、ターゲットに影響するGROUP BY句のキーとして使用されました。
コードタブ
エッジの [コード] タブには、そのエッジを誘導した SQL スクリプトが表示されます。エッジのソースノードとターゲット ノードは、SQL テキストで言及されている場所でハイライト表示されます。
次のステップ
- 移行評価を実行して、データ ウェアハウスの BigQuery への移行の実現可能性と潜在的なメリットを評価します。
- インタラクティブ SQL トランスレータ、Translation API、バッチ SQL トランスレータなどの SQL 変換サービスを使用して、SQL クエリから GoogleSQL(Gemini 拡張 SQL カスタマイズを含む)への変換を自動化します。