

您可以為代管執行個體群組 (MIG) 設定自動調度資源功能,根據負載的增減,自動新增或移除虛擬機器 (VM) 執行個體。不過,如果應用程式需要幾分鐘以上才能初始化,則新增執行個體來因應即時變更,可能無法快速提高應用程式的容量。舉例來說,如果負載大幅增加 (例如使用者早上剛起床時),應用程式在新例項上初始化時,部分使用者可能會遇到延遲。
您可以使用預測式自動調度資源功能,縮短初始化時間較長,且工作負載會隨著每日或每週週期可預測變化的應用程式回應時間。
啟用預測式自動調度資源後,Compute Engine 會根據 MIG 的歷來資料預測未來的負載,並在預測負載出現前水平擴展 MIG,以便在負載出現時,新執行個體已準備好提供服務。如果沒有預測型自動調度資源,自動配置器只能根據即時觀察到的負載變化,被動調度群組資源。啟用預測式自動調度資源功能後,自動配置器會同時使用即時資料和歷來資料,涵蓋目前和預測的負載。詳情請參閱「預測式自動調度資源的運作方式」和「確認預測式自動調度資源是否適合您的工作負載」。
事前準備
- 如要使用本指南中的指令列範例,請安裝 Google Cloud CLI 或啟動 Cloud Shell。
- 瞭解自動配置器的基本概念。
-
如果尚未設定驗證,請先完成設定。
驗證程序會確認您的身分,以便授予 Cloud de Confiance by S3NS 服務和 API 的存取權。如要從本機開發環境執行程式碼或範例,請選取下列其中一個選項,向 Compute Engine 進行驗證:
選取這個頁面上範例的預計用途分頁:
控制台
使用 Cloud de Confiance 控制台存取 Cloud de Confiance by S3NS 服務和 API 時,您不需要設定驗證機制。
gcloud
-
安裝 Google Cloud CLI,然後 使用聯合身分登入 gcloud CLI。登入後,執行下列指令來初始化 Google Cloud CLI:
gcloud init
-
- 設定預設區域和可用區。
REST
如要在本機開發環境中使用本頁的 REST API 範例,請使用您提供給 gcloud CLI 的憑證。
安裝 Google Cloud CLI,然後 使用聯合身分登入 gcloud CLI。
詳情請參閱 Cloud de Confiance 驗證說明文件中的「使用 REST 進行驗證」一節。
定價
預測式自動調度資源功能無須支付費用。不過,如果啟用預測式自動調度資源功能來提高可用性,則須支付 MIG 使用的 Compute Engine 資源費用。
限制
- 預測式自動調度資源功能僅適用於以 CPU 使用率做為調度指標。不支援 Cloud Load Balancing 或 Cloud Monitoring 指標。
- Compute Engine 需要 3 天的 CPU 自動調度資源記錄,才能產生預測結果。
- 預測結果是根據每週和每日的負載模式計算得出。 Compute Engine 不會預測每月、每年或一次性事件,也不會預測短於 10 分鐘的負載模式。您可以透過排程式自動調度資源,為一次性或其他負載模式要求容量。
適合的工作負載
如果工作負載符合下列條件,預測式自動調度資源功能就能發揮最大效益:
- 應用程式初始化時間過長,例如您設定的初始化期間超過 2 分鐘。
- 工作負載會隨著每日或每週週期而有規律變化。
如果服務需要較長的初始化時間,使用者可能會在向外擴充事件後 (即新的 VM 已佈建但尚未提供服務時) 遇到服務延遲。預測式自動調度資源功能會考量應用程式的初始化時間,並在預測使用量增加前預先水平擴展,確保可用的服務執行個體數量足以達到目標使用率。
如要預覽預測式自動調度資源對群組的影響,請參閱「檢查預測式自動調度資源是否適合您的工作負載」。
啟用及停用預測式自動調度資源功能
根據 CPU 使用率調度資源時,您可以啟用預測式自動調度資源功能。 如要進一步瞭解如何設定以 CPU 為準的自動調度資源功能,請參閱「根據 CPU 使用率調度資源」。
如果 MIG 沒有自動配置器記錄,預測演算法可能需要 3 天才會影響自動配置器。在此期間,群組只會根據即時資料調整規模。3 天後,系統會開始根據預測結果調整群組規模。收集的歷史負載越多,預測型自動配置器就越能瞭解負載模式,預測結果也會越準確。Compute Engine 最多會使用 MIG 的 3 週負載記錄,提供給機器學習模型。
控制台
前往控制台的「Instance groups」(執行個體群組) 頁面。
在清單中,按一下現有 MIG 的名稱,開啟群組的總覽頁面。
按一下 [編輯]。
按一下「Group size & autoscaling」(群組大小和自動調度資源) 展開該部分,然後執行下列操作:
如果沒有自動調度資源設定,請按照下列步驟設定自動調度資源功能:
- 在「Autoscaling」(自動調度資源) 部分,按一下「Configure autoscaling」(設定自動調度資源功能)。 系統預設會新增 CPU 使用率信號。
- 指定您要讓自動配置器在這個群組中建立的執行個體數量下限與上限。
- 在「自動調度資源信號」部分,按一下 CPU 使用率信號。
- 視需要修改「Signal type」(信號類型) 和「Target CPU utilization」(目標 CPU 使用率)。
在「預測式自動調度資源」部分,選取「針對可用性進行最佳化」,即可啟用預測式自動調度資源功能。
- 或者,如要停用預測演算法,並僅使用即時自動配置器,請選取「Off」(關閉)。
按一下「完成」。
如果已設定依據 CPU 使用率自動調度資源,請按照下列步驟操作:
- 在「Autoscaling signals」(自動調度資源信號) 區段中,按一下 CPU 使用率信號。
- 在「預測式自動調度資源」部分,選取「針對可用性進行最佳化」,即可啟用預測式自動調度資源功能。
按一下「完成」。
在「Initialization period」(初始化期間) 部分,指定應用程式在新執行個體上初始化所需的時間。這項設定會通知預測式自動配置器,在預期負載出現前進一步水平擴展,以便在負載抵達時初始化應用程式。
按一下 [儲存]。
gcloud
設定或更新 MIG 的自動配置器時,請加入 --cpu-utilization-predictive-method 旗標,並設為下列其中一個值:
optimize-availability:啟用預測演算法none(預設):停用預測演算法
如果群組尚未啟用以 CPU 為準的自動調度資源功能,請務必啟用。
您可以使用 set-autoscaling 指令從頭設定群組的自動調度資源政策。舉例來說,下列指令說明如何使用以下設定來設定自動調度資源:
- 已啟用預測式自動調度資源功能。
- 目標 CPU 使用率為 75%。
- 執行個體數量上限設為 20。
- 初始化期間 (
--cool-down-period) 設為 5 分鐘。這項設定會通知預測式自動配置器,在預期負載出現前 5 分鐘水平擴展,以便在負載出現時初始化應用程式。
gcloud compute instance-groups managed set-autoscaling MIG_NAME \
  --cpu-utilization-predictive-method optimize-availability \
  --target-cpu-utilization 0.75 \
  --max-num-replicas 20 \
  --cool-down-period 300
如果群組已啟用以 CPU 為依據的自動調度資源功能,請使用 update-autoscaling 指令啟用預測演算法:
gcloud compute instance-groups managed update-autoscaling MIG_NAME \
  --cpu-utilization-predictive-method=optimize-availability
REST
建立或更新自動調整工具時,請在要求主體中加入 predictiveMethod 欄位,並使用下列其中一個值:
OPTIMIZE_AVAILABILITY:啟用預測演算法NONE(預設):停用預測演算法
如果群組沒有任何自動調度資源設定,請按照下列步驟操作:
- 區域性 MIG:呼叫
regionAutoscalers.insert方法 - 可用區 MIG:呼叫
autoscalers.insert方法
如果群組已有自動調度資源設定,請執行下列操作:
- 區域性 MIG:呼叫
regionAutoscalers.patch方法 - 可用區 MIG:呼叫
autoscalers.patch方法
如果群組尚未啟用以 CPU 為基礎的自動調度資源功能,請務必啟用。
舉例來說,下列要求會修補現有的自動調度資源,以啟用 CPU 自動調度資源功能,並採用下列設定:
- 已啟用預測式自動調度資源功能。
- 目標 CPU 使用率為 75%。
- 執行個體數量上限設為 20。
- 初始化期間 (
coolDownPeriodSec) 設為 5 分鐘。這項設定會通知預測式自動配置器,在預期負載出現前 5 分鐘水平擴展,以便在負載出現時初始化應用程式。
PATCH https://compute.googleapis.com/compute/v1/projects/PROJECT_ID/regions/REGION/autoscalers?autoscaler=AUTOSCALER_NAME

{
  "target": "https://compute.googleapis.com/compute/v1/projects/PROJECT_ID/regions/REGION/instanceGroupManagers/MIG_NAME",
  "autoscalingPolicy": {
    "cpuUtilization": {
       "utilizationTarget": 0.75,
       "predictiveMethod": "OPTIMIZE_AVAILABILITY"
     },
    "maxNumReplicas": 20,
    "coolDownPeriodSec": 300
  }
}
檢查是否已啟用預測式自動調度資源功能
如要查看 MIG 目前的自動調度資源設定,請參閱「取得 MIG 的屬性」。
設定預測式自動調度資源功能
如要進一步瞭解如何設定目標使用率、執行個體數量下限和上限,以及初始化期間,請參閱「依據 CPU 使用率調度資源」。設定這些選項後,預測自動調度資源功能會以您設定的目標使用率,維持群組內所有執行個體的使用率,並將使用率控制在群組的下限和上限之間,與即時自動調度資源功能運作方式相同。
使用初始化期間設定,將應用程式初始化所需的時間納入考量。這項設定會影響預測式自動配置器在預測負載增加前,預先啟動新執行個體的提前時間,確保應用程式在負載增加時能正常運作。
檢查預測式自動調度資源功能是否適合您的工作負載
如要瞭解預測式自動調度資源是否能提升應用程式的可用性,您可以比較群組目前的 CPU 自動調度資源設定與預測式自動調度資源的成效。您不需要啟用預測式自動調度資源功能,即可進行比較。
如要進一步瞭解適合預測式自動調度資源的工作負載,請參閱「適合的工作負載」。
檢查是否過載
當自動調度資源的 MIG 平均 CPU 使用率超過目標時,就會過度負載。如要查看自動調度資源設定是否導致 VM 在過去 7 天內過載,以及預測自動調度資源是否能減少過載,請完成下列步驟:
前往控制台的「Instance groups」(執行個體群組) 頁面。
按一下已設定 CPU 自動調度資源的現有 MIG。群組的總覽頁面隨即開啟。
按一下 [編輯]。
按一下「群組大小和自動調度」展開該部分。
在「自動調度資源」部分,展開「自動調度資源信號」下方的「CPU 使用率」部分,然後點選「瞭解預測式自動調度資源是否能提供最佳可用性」。
根據過去 7 天的資料,下表會顯示每日使用的 VM 數量,以及每日過載的 VM 數量:
- 目前的自動調度資源設定:顯示自動調度程式在過去 7 天的成效,並以自動調度程式的設定為準。
- 預測式自動調度資源功能設為「針對可用性進行最佳化」:顯示過去 7 天啟用預測式自動調度資源功能後,自動調度器會如何運作。
您可以使用「每日使用的 VM 數量」做為成本的代理指標。舉例來說,為了減少每日超載的 VM 數量,預測式自動配置器可能會提早建立 VM 並延長執行時間,進而產生額外費用。
監控及模擬預測式自動調度資源
您可以使用 Cloud Monitoring,以圖表呈現群組的歷史大小。監控圖表會顯示自動調度資源設定在一段時間內如何調度群組資源,以及預測式自動調度資源 (如已啟用) 如何調度群組資源。
如果群組已停用預測式自動調度資源功能,您可以使用這項工具模擬預測式自動調度資源,再啟用這項功能。
前往控制台的「Instance groups」(執行個體群組) 頁面。
按一下已設定 CPU 自動調度資源的現有 MIG。群組的總覽頁面隨即開啟。
按一下「監控」,即可查看與群組相關的圖表。
在第一個圖表中,按一下標題並選取「預測自動調度」。 這個檢視畫面會顯示群組的實際大小和預測大小。
您可以選取其他時間範圍,查看更多記錄,或放大需求成長的期間,瞭解預測自動調度功能如何影響預測負載前的群組大小。
預測式自動調度資源的運作方式
預測式自動調度器會根據指標的歷史趨勢,預測調度指標。預測結果每隔幾分鐘就會重新計算,因此自動調度器可以根據負載的最新變化,快速調整預測結果。預測式自動調度資源需要至少 3 天的記錄,才能判斷具代表性的服務使用情形模式,進而提供預測結果。Compute Engine 最多會使用 MIG 的 3 週負載記錄,提供給機器學習模型。
預測自動配置器會根據多項因素 (包括下列因素),計算達到使用率目標所需的 VM 數量:
- 預測的擴充指標未來值
- 縮放指標的目前值
- 對過往趨勢的信心,包括擴充指標的過往變化
- 設定的應用程式初始化期間,也稱為「初始化期間」
預測自動配置器會根據這些因素,在預期需求出現前水平擴展您的群組。
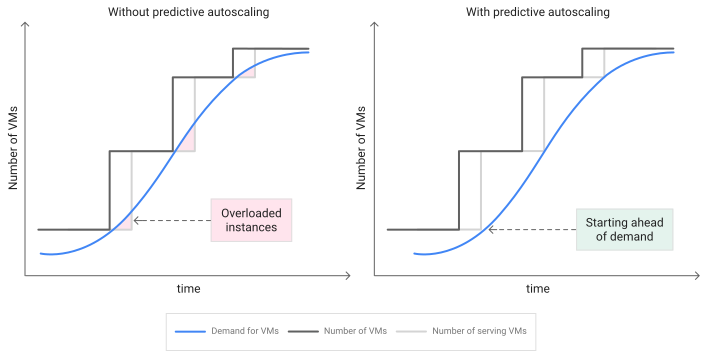
圖 1. 比較有和沒有預測自動調度資源的服務 VM。
圖 1 中的藍線顯示 VM 需求不斷增加。黑線顯示自動調度程式的回應:新增更多 VM。不過,如果應用程式的初始化時間較長,灰色線條會顯示新增的 VM 需要額外時間才能準備就緒,這可能會導致提供服務的 VM 不足以滿足需求。啟用預測式自動調度資源功能後,系統會考量預測的需求增加和應用程式初始化時間過長的問題:自動配置器會提早新增 VM,確保有足夠的 VM 提供服務。您可以設定「初始化期間」,決定要提前多久新增執行個體。
即時用量資料
預測式自動調度器無法根據歷來資料判斷未來所有用量變化模式,因此也會與即時資料順暢搭配運作。舉例來說,突發新聞事件可能會導致用量激增,而這無法單憑歷來資料預測。為因應這類無法預測的負載變化,預測式自動配置器會採取下列做法:
- 預測結果會不斷調整:系統每隔幾分鐘就會重新計算預測結果,以便納入最新資料。調整新模式的確切時間取決於新模式的可重複性,以及新模式與過去預測之間的差異大小等因素。
- 系統會根據即時資料調整:自動配置器會根據指標的即時值,建議執行個體數量,確保能滿足群組的目標使用率。如果即時信號的目前值大於預測值,系統會優先採用信號的目前值。因此,與未啟用預測自動調度資源功能的 MIG 相比,啟用這項功能的 MIG 一律有更多可用性。
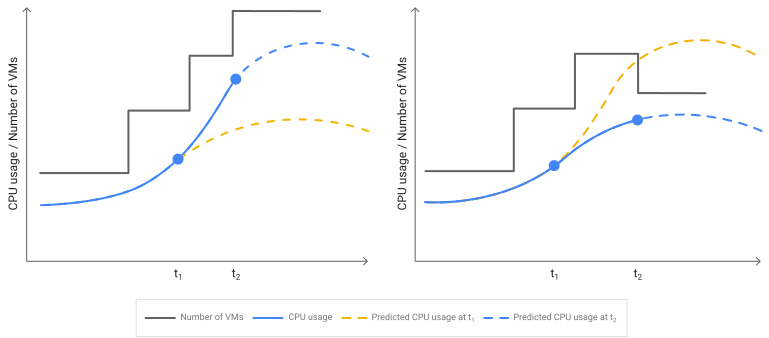
圖 2:兩張圖表會顯示預測值如何根據實際 CPU 使用率調整。
在圖 2 中,黃色虛線顯示 t1 的預測結果。但如藍色實線所示,實際 CPU 用量與預測值不同。左側圖表顯示實際 CPU 用量高於預測值。在右側圖表中,實際 CPU 用量低於預測值。藍色虛線代表調整後的預測結果。
短時間內無法預測的尖峰
系統會即時處理短暫、無法預測的高峰。自動配置器會根據指標目前的實際值,建立至少所需數量的執行個體,將使用率維持在設定的目標。不過,這些例項不會預先建立,如下圖所示。
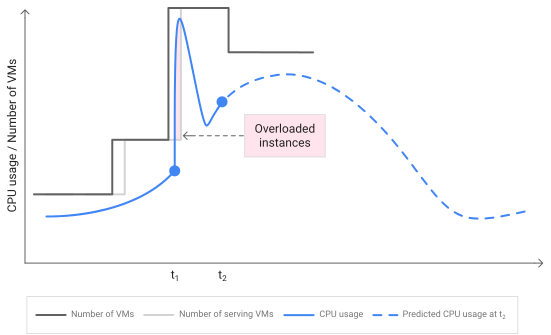
圖 3:短暫且無法預測的尖峰會導致自動配置器即時反應。
在圖 3 中,藍色實線代表實際 CPU 用量。無法預測 CPU 使用率何時會突然飆升。由於自動配置器會持續監控即時資料,因此會新增執行個體來因應尖峰流量。實心黑線:說明自動調度器因應尖峰流量,被動新增 VM。灰色實線代表服務 VM 數量。由於應用程式的初始化時間,灰線會落後於黑線。在這種情況下,群組會暫時超載。
突然下降
另一種無法預測的用量變化是突然下降,例如應用程式堆疊部分發生故障,導致用量下降。發生這種情況時,執行個體數量一開始會遵循預測。不過,隨著時間推移,預測會根據低於預測的用量進行調整,進而縮減規模。這項調整的確切時間取決於多項因素,包括:過去模式的發生頻率、下降時間長度,以及下降幅度。
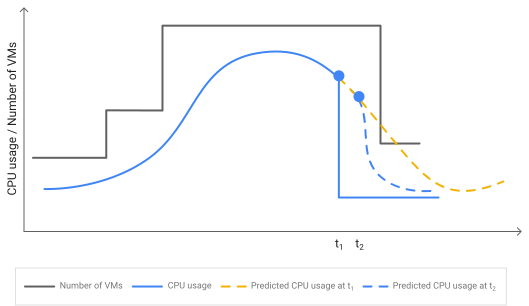
圖 4:如果突然下滑,預測式自動調度器就會變更預測結果。
在圖 4 中,黃色虛線代表 t1 的預測結果。但實際 CPU 用量 (以藍色實線表示) 低於預測值。藍色虛線代表更新後的預測值,系統在觀察到用量低於預測值後,會自動調整這個值。因此,自動配置器會在標準穩定期過後移除執行個體。
歷來資料
預測式自動配置器需要至少 3 天的歷史負載資料,才能開始預測。如果新的 MIG 缺少歷來資料,Compute Engine 會使用即時資料反應式地調度群組,直到有足夠的歷來資料為止。3 天後,隨著 Compute Engine 收集更多用量資料,預測結果會更準確。
如果您透過建立新的 MIG 並刪除舊 MIG 的方式更新應用程式 (例如藍綠部署),則新的 MIG 需要 3 天的歷來負載資料,預測自動調度資源功能才能再次開始產生預測。如要保留各 MIG 的載入記錄,以便在建立新 MIG 時立即開始預測,請與我們聯絡,索取加入私人預先發布版的說明。
後續步驟
- 瞭解如何管理自動調度器。
- 瞭解自動配置器如何做出決策。
- 瞭解如何使用多個自動調度資源信號來調度群組。