

In diesem Dokument werden die Netzwerkbandbreitenfunktionen und -konfigurationen für Compute Engine-Instanzen mit angehängten GPUs beschrieben. Hier finden Sie Informationen zur maximalen Netzwerkbandbreite, zu den Anordnungen der Netzwerkkarten (NICs) und zu den empfohlenen VPC-Netzwerkeinstellungen für verschiedene GPU-Maschinentypen, einschließlich der Serien A5X, A4X Max, A4X, A4, A3, A2, G4, G2 und N1. Wenn Sie diese Konfigurationen verstehen, können Sie die Leistung Ihrer verteilten Arbeitslasten in Compute Engine optimieren.
Übersicht
Die folgende Tabelle enthält einen allgemeinen Vergleich der Netzwerkfunktionen für GPU-Maschinentypen.
| Maschinentyp | GPU-Modell | Maximale Gesamtbandbreite | GPU-zu-GPU-Netzwerktechnologie |
|---|---|---|---|
| A5X | NVIDIA Vera Rubin-Superchips | 7.200 Gbit/s | GPUDirect RDMA |
| A4X Max | NVIDIA GB300 Ultra-Superchips | 3.600 Gbit/s | GPUDirect RDMA |
| A4X | NVIDIA GB200-Superchips | 2.000 Gbit/s | GPUDirect RDMA |
| A4 | NVIDIA B200 | 3.600 Gbit/s | GPUDirect RDMA |
| A3 Ultra | NVIDIA H200 | 3.600 Gbit/s | GPUDirect RDMA |
| A3 Mega | NVIDIA H100 80 GB | 1.800 Gbit/s | GPUDirect-TCPXO |
| A3 High | NVIDIA H100 80 GB | 1,000 Gbit/s | GPUDirect-TCPX |
| A3 Edge | NVIDIA H100 80 GB | 600 Gbit/s | GPUDirect-TCPX |
| G4 | NVIDIA RTX Pro 6000 | 400 Gbit/s | – |
| A2 Standard und A2 Ultra | NVIDIA A100 40 GB, NVIDIA A100 80 GB | 100 Gbit/s | – |
| G2 | NVIDIA L4 | 100 Gbit/s | – |
| N1 (T4, V100) | NVIDIA T4, NVIDIA V100 | 100 Gbit/s | – |
| N1 (P4) | NVIDIA P4 | 32 Gbit/s | – |
GPUDirect RDMA- und MRDMA-Funktionen
Bei bestimmten beschleunigungsoptimierten Maschinentypen verwendet Cloud de Confiance by S3NS MRDMA als Netzwerkschnittstellenimplementierung für die GPU-zu-GPU-Netzwerkkommunikation, die GPUDirect RDMA unterstützt.
GPUDirect RDMA ist eine NVIDIA-Technologie, die es einer Netzwerkkarte (NIC) ermöglicht, über PCIe direkt auf den GPU-Speicher zuzugreifen, wobei die Host-CPU und der Systemspeicher umgangen werden. Diese Peer-to-Peer-Kommunikation zwischen NIC und GPU reduziert die Latenz für die GPU-zu-GPU-Kommunikation zwischen Knoten erheblich.
MRDMA ist die Netzwerkschnittstellenimplementierung, die auf den Maschinentypen A5X, A4X Max, A4X, A4 und A3 Ultra verwendet wird, um GPUDirect RDMA-Funktionen bereitzustellen. MRDMA basiert auf NVIDIA ConnectX-NICs und wird auf eine der folgenden Arten bereitgestellt:
- Virtuelle MRDMA-Funktionen (VFs): werden in den Serien A3 Ultra, A4 und A4X verwendet.
- Physische MRDMA-Funktionen (PFs): werden in den Serien A5X und A4X Max verwendet.
MRDMA-Funktionen und Tools für das Netzwerkmonitoring
Die Maschinentypen A4X, A4 und A3 Ultra implementieren ein leistungsstarkes GPU-zu-GPU-Netzwerk mithilfe von MRDMA-VFs (Virtual Functions). Da es sich um virtualisierte Entitäten handelt, sind bestimmte Monitoring-Funktionen auf Hardwareebene im Vergleich zu physischen Funktionen (PFs) eingeschränkt.
Bei MRDMA-VFs werden standardmäßige physische Portzähler (z. B. solche, die auf _phy enden) in der Ausgabe von ethtool -S angezeigt, aber während der Netzwerkaktivität nicht aktualisiert. Dies ist ein Merkmal der MRDMA-VF-Architektur. Wenn Sie die Netzwerkleistung auf diesen Schnittstellen genau verfolgen möchten, sehen Sie sich die Einträge in der vPort-Zählertabelle anstelle der Zählertabelle für physische Ports an.
Die Maschinentypen A5X und A4X Max verwenden MRDMA-PFs. Im Gegensatz zu den MRDMA-VF-basierten Maschinentypen unterstützen A5X und A4X Max die gesamte Palette an physischen Portzählern für GPU-Netzwerke.
Netzwerkkonzepte für GPU-Maschinentypen prüfen
Im folgenden Abschnitt finden Sie Informationen zur Netzwerkanordnung und Bandbreitengeschwindigkeit für jeden GPU-Maschinentyp.
Maschinentypen A5X, A4X Max und A4X
Die Maschinenserien A5X, A4X Max und A4X sind für anspruchsvolle, umfangreiche, verteilte KI-Arbeitslasten konzipiert. Der Hauptunterschied zwischen diesen Serien besteht in den angehängten Beschleunigern und der Netzwerkhardware, wie in der folgenden Tabelle beschrieben:
| Funktion | A5X-Maschinenserie | A4X Max-Maschinenserie | A4X-Maschinenserie |
|---|---|---|---|
| Angeschlossene Hardware | NVIDIA Vera Rubin-Superchips | NVIDIA GB300 Ultra-Superchips | NVIDIA GB200-Superchips |
| GPU-zu-GPU-Netzwerk | 8 NVIDIA ConnectX-9 (CX-9) SuperNICs, die eine Bandbreite von 6.400 Gbit/s in einer schienenausgerichteten Topologie mit 8 Ebenen bieten: Jede GPU hat zwei 800-Gbit/s-NICs, die jeweils in vier 200-Gbit/s-Ports aufgeteilt sind. Die acht Ports jeder GPU sind mit acht separaten Netzwerkebenen verbunden. | 4 NVIDIA ConnectX-8 (CX-8) SuperNICs,die eine Bandbreite von 3.200 Gbit/s in einer 8-Wege-Rail-Aligned-Topologie bieten | 4 NVIDIA ConnectX-7-Netzwerkkarten (CX-7) mit einer Bandbreite von 1.600 Gbit/s in einer 4-Wege-Rail-Aligned-Topologie |
| Implementierung von GPU-zu-GPU-Netzwerken | 32 physische MRDMA-Funktionen (PFs), konfiguriert als 4 PFs pro NIC | 8 physische MRDMA-Funktionen (PFs), konfiguriert als 2 PFs pro NIC | 4 virtuelle MRDMA-Funktionen (VFs), konfiguriert als 1 VF pro NIC |
| Hostnetzwerk (Titanium) | 2 Titanium-Smart-NICs mit einer Bandbreite von 800 Gbit/s | 2 Titanium-Smart-NICs mit einer Bandbreite von 400 Gbit/s | 2 Titanium-Smart-NICs mit einer Bandbreite von 400 Gbit/s |
| Maximale Netzwerkbandbreite insgesamt | 7.200 Gbit/s | 3.600 Gbit/s | 2.000 Gbit/s |
Mehrstufige Netzwerkarchitektur
A5X-, A4X Max- und A4X-Compute-Instanzen verwenden eine mehrschichtige, hierarchische Netzwerkarchitektur mit einem Rail-Design, um die Leistung für verschiedene Kommunikationstypen zu optimieren. In dieser Topologie stellen Instanzen Verbindungen über mehrere unabhängige Netzwerkebenen her, die als Rails bezeichnet werden.
- A5X-Instanzen verwenden eine schienenausgerichtete 8-Ebenen-Topologie: Jede GPU hat zwei 800-Gbit/s-CX-9-SuperNICs, die jeweils in vier 200-Gbit/s-Ports aufgeteilt sind. Die acht Ports jeder GPU sind mit acht separaten Netzwerkebenen verbunden.
- A4X Max-Instanzen verwenden eine 8-Wege-Rail-Aligned-Topologie, bei der jede der vier 800-Gbit/s-ConnectX-8-Netzwerkkarten mit zwei separaten 400-Gbit/s-Rails verbunden ist.
- A4X-Instanzen verwenden eine 4-Wege-Rail-Aligned-Topologie, bei der jede der vier ConnectX-7-NICs mit einer separaten Rail verbunden ist.
Die Netzwerkschichten für diese Maschinentypen sind:
Knoteninterne und subblockinterne Kommunikation (NVLink): Eine Hochgeschwindigkeits-NVLink-Struktur verbindet GPUs für eine Kommunikation mit hoher Bandbreite und niedriger Latenz. Diese Fabric verbindet alle GPUs innerhalb einer einzelnen Instanz und erstreckt sich über einen Subblock, der aus 18 A5X-, A4X Max- oder A4X-Instanzen (insgesamt 72 GPUs) besteht. So können alle 72 GPUs in einem Subblock so kommunizieren, als wären sie in einem einzigen, großen GPU-Server.
Kommunikation zwischen Subblöcken (ConnectX-NICs mit RoCE): Um Arbeitslasten über einen einzelnen Subblock hinaus zu skalieren, verwenden diese Maschinen NVIDIA ConnectX-NICs. Diese NICs verwenden RDMA-RoCE (Remote Direct Memory Access over Converged Ethernet), um eine Kommunikation mit hoher Bandbreite und niedriger Latenz zwischen Unterblöcken zu ermöglichen. So können Sie große Trainingscluster mit Tausenden von GPUs erstellen.
Hostnetzwerk (Titanium Smart NICs): Zusätzlich zu den spezialisierten GPU-Netzwerken hat jede Instanz zwei Hostnetzwerkschnittstellen, die eine kombinierte Bandbreite von 800 Gbit/s auf A5X-Instanzen oder 400 Gbit/s auf A4X Max- und A4X-Instanzen bieten. Die Host-Netzwerkschnittstellen werden für Speicher, Verwaltung und die Verbindung zu anderen Cloud de Confiance by S3NS -Diensten oder dem öffentlichen Internet verwendet.
A5X-Architektur
Die A5X-Architektur verwendet NVIDIA Vera Rubin-Superchips. Jede Instanz bietet acht NVIDIA ConnectX-9-SuperNICs (CX-9) mit 800 Gbit/s, zwei pro GPU. Jede SuperNIC hat vier 200-Gbit/s-Ports und wird der Instanz als vier MRDMA-PFs angezeigt, was 32 MRDMA-PFs und 6.400 Gbit/s GPU-zu-GPU-Bandbreite entspricht. Jede Instanz enthält außerdem zwei Titanium-Smart-NICs mit 400 Gbit/s, die eine Host-Netzwerkbandbreite von 800 Gbit/s bieten.
A4X Max-Architektur
Die A4X Max-Architektur basiert auf NVIDIA GB300 Ultra-Superchips. Ein wichtiges Merkmal dieses Designs ist die direkte Verbindung der vier NVIDIA ConnectX-8-SuperNICs (CX-8) mit 800 Gbit/s zu den GPUs. Jede ConnectX-8 ist eine Dual-Port-Netzwerkkarte, die der Instanz als zwei physische Funktionen (PFs) zur Verfügung gestellt wird. Diese NICs sind Teil einer 8-Wege-Rail-Aligned-Netzwerktopologie, bei der jede NIC mit zwei separaten 400-Gbit/s-Rails verbunden ist. Dieser direkte Pfad ermöglicht RDMA und bietet eine hohe Bandbreite und niedrige Latenz für die GPU-zu-GPU-Kommunikation über verschiedene Unterblöcke hinweg. Diese Compute Engine-Instanzen enthalten auch leistungsstarke lokale SSDs, die an die ConnectX-8-NICs angehängt sind und den PCIe-Bus für einen schnelleren Datenzugriff umgehen.
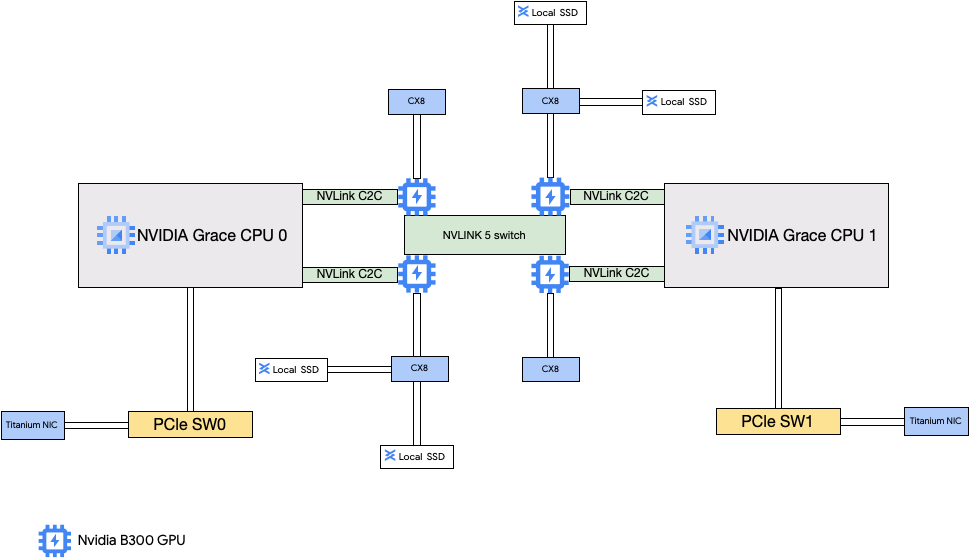
A4X-Architektur
Die A4X-Architektur verwendet NVIDIA GB200-Superchips. In dieser Konfiguration sind die vier NVIDIA ConnectX-7-Netzwerkkarten (CX-7) mit der Host-CPU verbunden. Diese Einrichtung bietet ein leistungsstarkes Netzwerk für die GPU-zu-GPU-Kommunikation zwischen Unterblöcken.

VPC-Netzwerkkonfiguration (Virtual Private Cloud) für A5X, A4X Max und A4X
Wenn Sie die vollen Netzwerkfunktionen dieser Maschinentypen nutzen möchten, müssen Sie VPC-Netzwerke erstellen und an Ihre Instanzen anhängen. Wenn Sie alle verfügbaren NICs verwenden möchten, müssen Sie VPC-Netzwerke so erstellen:
Für die Titanium Smart NICs sind reguläre VPC-Netzwerke erforderlich:
- A5X: zwei reguläre VPC-Netzwerke. A5X-Instanzen verwenden den Intel IDPF LAN PF-Gerätetreiber und unterstützen IPv4-, IPv6- und BYOIP-Adressen (Bring Your Own IP). BYOIP-externe IPv6-Subnetzbereiche werden jedoch nur für VM-Instanzen unterstützt.
- A4X Max: ein reguläres VPC-Netzwerk mit zwei Subnetzen. A4X Max-Instanzen verwenden den Intel IDPF LAN PF-Gerätetreiber und unterstützen mehrere Netzwerkschnittstellen im selben VPC-Netzwerk.
- A4X: zwei reguläre VPC-Netzwerke. A4X-Instanzen verwenden die Netzwerkschnittstelle Google Virtual NIC (gVNIC).
Ein VPC-Netzwerk mit einem RoCE-Netzwerkprofil ist für die ConnectX-NICs erforderlich, wenn Sie Cluster mit mehreren A5X-, A4X Max- oder A4X-Subblöcken erstellen. Wenn Sie einen einzelnen Subblock verwenden, können Sie dieses VPC-Netzwerk weglassen, da die NVLink-Fabric mit mehreren Knoten die direkte GPU-zu-GPU-Kommunikation übernimmt.
- Erstellen Sie für A5X- und A4X Max-Bare-Metal-Instanzen ein RoCE-VPC-Netzwerk für Bare-Metal-Instanzen (
roce-metal), das automatisch ein einzelnes IPv6-Subnetz für alle MRDMA-Netzwerkschnittstellen (32 auf A5X, 8 auf A4X Max) bereitstellt. - Erstellen Sie für A4X-VM-Instanzen ein RoCE-VPC-Netzwerk für VM-Instanzen (
roce) und erstellen Sie dann manuell vier reine IPv4-Subnetze in diesem Netzwerk, ein Subnetz für jede Netzwerk-Rail.
- Erstellen Sie für A5X- und A4X Max-Bare-Metal-Instanzen ein RoCE-VPC-Netzwerk für Bare-Metal-Instanzen (
Informationen zum Einrichten dieser Netzwerke finden Sie in der AI Hypercomputer-Dokumentation in den folgenden Leitfäden:
- Wenden Sie sich für A5X-Instanzen an Ihr Account-Management-Team, um Kapazität zu reservieren und eine Anleitung zum Erstellen von Instanzen und Clustern zu erhalten.
- Informationen zu A4X Max-Instanzen finden Sie unter VPC-Netzwerke für A4X Max erstellen.
- Informationen zu A4X-Instanzen finden Sie unter VPC-Netzwerke für A4X erstellen.
Maschinentypen A5X, A4X Max und A4X
A5X
| Maschinentyp | vCPU Anzahl | Instanzarbeitsspeicher (GB) | Verbundene lokale SSD (GiB) | Anzahl der physischen NICs | Maximale Netzwerkbandbreite (Gbit/s) | Anzahl der NVIDIA Rubin-GPUs | GPU-Speicher (GB HBM4) |
|---|---|---|---|---|---|---|---|
a5x-highgpu-4g-metal |
176 | 1.440 | 48.000 | 10 | 7.200 | 4 | 1.152 |
Für die obige Tabelle gelten die folgenden Hinweise:
- vCPU-Anzahl: Bei A5X-Bare-Metal-Instanzen entspricht die vCPU-Anzahl von 176 den 176 physischen CPU-Kernen auf zwei 88-Kern-Sockeln auf der NVIDIA Vera-CPU-Plattform.
- Maximale Netzwerkbandbreite: Die maximale Bandbreite für ausgehenden Traffic darf die angegebene Zahl nicht überschreiten. Die tatsächliche Bandbreite für ausgehenden Traffic hängt von der Ziel-IP-Adresse und anderen Faktoren ab. Weitere Informationen zur Netzwerkbandbreite finden Sie unter Netzwerkbandbreite.
- GPU-Arbeitsspeicher: GPU-Arbeitsspeicher ist der Speicher auf einem GPU-Gerät, in dem temporäre Daten gespeichert werden. Er ist vom Arbeitsspeicher der Instanz getrennt und wurde speziell für die höheren Bandbreitenanforderungen grafikintensiver Arbeitslasten entwickelt.
A4X Max
| Maschinentyp | vCPU Anzahl | Instanzarbeitsspeicher (GB) | Verbundene lokale SSD (GiB) | Anzahl der physischen NICs | Maximale Netzwerkbandbreite (Gbit/s) | Anzahl der NVIDIA GB300-GPUs | GPU-Speicher (GB HBM3e) |
|---|---|---|---|---|---|---|---|
a4x-maxgpu-4g-metal |
144 | 960 | 12.000 | 6 | 3.600 | 4 | 1.116 |
Für die obige Tabelle gelten die folgenden Hinweise:
- vCPU-Anzahl: Eine vCPU ist als einzelner Hardware-Hyper-Thread auf einer der verfügbaren CPU-Plattformen implementiert.
- Maximale Netzwerkbandbreite: Die maximale Bandbreite für ausgehenden Traffic darf die angegebene Zahl nicht überschreiten. Die tatsächliche Bandbreite für ausgehenden Traffic hängt von der Ziel-IP-Adresse und anderen Faktoren ab. Weitere Informationen zur Netzwerkbandbreite finden Sie unter Netzwerkbandbreite.
- GPU-Arbeitsspeicher: GPU-Arbeitsspeicher ist der Speicher auf einem GPU-Gerät, der zum temporären Speichern von Daten verwendet werden kann. Er ist vom Arbeitsspeicher der Instanz getrennt und wurde speziell für die höheren Bandbreitenanforderungen grafikintensiver Arbeitslasten entwickelt.
A4X
| Maschinentyp | vCPU Anzahl | Instanzarbeitsspeicher (GB) | Verbundene lokale SSD (GiB) | Anzahl der physischen NICs | Maximale Netzwerkbandbreite (Gbit/s) | Anzahl der NVIDIA GB200-GPUs | GPU-Speicher (GB HBM3e) |
|---|---|---|---|---|---|---|---|
a4x-highgpu-4g |
140 | 884 | 12.000 | 6 | 2.000 | 4 | 744 |
Für die obige Tabelle gelten die folgenden Hinweise:
- vCPU-Anzahl: Eine vCPU ist als einzelner Hardware-Hyper-Thread auf einer der verfügbaren CPU-Plattformen implementiert.
- Maximale Netzwerkbandbreite: Die maximale Bandbreite für ausgehenden Traffic darf die angegebene Zahl nicht überschreiten. Die tatsächliche Bandbreite für ausgehenden Traffic hängt von der Ziel-IP-Adresse und anderen Faktoren ab. Weitere Informationen zur Netzwerkbandbreite finden Sie unter Netzwerkbandbreite.
- GPU-Arbeitsspeicher: GPU-Arbeitsspeicher ist der Speicher auf einem GPU-Gerät, der zum temporären Speichern von Daten verwendet werden kann. Er ist vom Arbeitsspeicher der Instanz getrennt und wurde speziell für die höheren Bandbreitenanforderungen grafikintensiver Arbeitslasten entwickelt.
A4- und A3-Ultra-Maschinentypen
An die A4-Maschinentypen sind NVIDIA B200-GPUs und an die A3 Ultra-Maschinentypen NVIDIA H200-GPUs angehängt.
Diese Maschinentypen bieten acht NVIDIA ConnectX-7-Netzwerkkarten (CX-7) und zwei Google Virtual NICs (gVNIC). Die acht CX-7-Netzwerkkarten bieten eine Netzwerkbandbreite von insgesamt 3.200 Gbit/s. Diese NICs sind nur für die GPU-zu-GPU-Kommunikation mit hoher Bandbreite vorgesehen und können nicht für andere Netzwerkanforderungen wie den öffentlichen Internetzugriff verwendet werden. Wie im folgenden Diagramm dargestellt, ist jede CX-7-Netzwerkkarte einer GPU zugeordnet, um den uneinheitlichen Arbeitsspeicherzugriff (NUMA) zu optimieren. Alle acht GPUs können über die NVLink-Bridge, die sie miteinander verbindet, schnell miteinander kommunizieren. Die beiden anderen gVNIC-Netzwerkkarten sind intelligente Netzwerkkarten, die eine zusätzliche Netzwerkbandbreite von 400 Gbit/s für allgemeine Netzwerkanforderungen bieten. Zusammen bieten die Netzwerkkarten eine maximale Netzwerkbandbreite von insgesamt 3.600 Gbit/s für diese Maschinen.
Das leistungsstarke GPU-zu-GPU-Netzwerk auf A4- und A3 Ultra-Instanzen wird mithilfe von MRDMA-Virtual Functions (VFs) für jede der acht ConnectX-7-NICs implementiert.

Wenn Sie diese mehreren NICs verwenden möchten, müssen Sie drei VPC-Netzwerke (Virtual Private Cloud) erstellen:
- Zwei reguläre VPC-Netzwerke: Jede gVNIC muss an ein anderes VPC-Netzwerk angehängt werden.
- Ein RoCE-VPC-Netzwerk: Alle acht CX-7-NICs nutzen dasselbe RoCE-VPC-Netzwerk.
Informationen zum Einrichten dieser Netzwerke finden Sie in der AI Hypercomputer-Dokumentation unter VPC-Netzwerke erstellen.
A4
| Maschinentyp | vCPU Anzahl | Instanzarbeitsspeicher (GB) | Verbundene lokale SSD (GiB) | Anzahl der physischen NICs | Maximale Netzwerkbandbreite (Gbit/s) | Anzahl der NVIDIA B200 Blackwell-GPUs | GPU-Speicher (GB HBM3e) |
|---|---|---|---|---|---|---|---|
a4-highgpu-8g |
224 | 3.968 | 12.000 | 10 | 3.600 | 8 | 1.440 |
Für die obige Tabelle gelten die folgenden Hinweise:
- vCPU-Anzahl: Eine vCPU ist als einzelner Hardware-Hyper-Thread auf einer der verfügbaren CPU-Plattformen implementiert.
- Maximale Netzwerkbandbreite: Die maximale Bandbreite für ausgehenden Traffic darf die angegebene Zahl nicht überschreiten. Die tatsächliche Bandbreite für ausgehenden Traffic hängt von der Ziel-IP-Adresse und anderen Faktoren ab. Weitere Informationen zur Netzwerkbandbreite finden Sie unter Netzwerkbandbreite.
- GPU-Arbeitsspeicher: GPU-Arbeitsspeicher ist der Speicher auf einem GPU-Gerät, der zum temporären Speichern von Daten verwendet werden kann. Er ist vom Arbeitsspeicher der Instanz getrennt und wurde speziell für die höheren Bandbreitenanforderungen grafikintensiver Arbeitslasten entwickelt.
A3 Ultra
| Maschinentyp | vCPU Anzahl | Instanzarbeitsspeicher (GB) | Verbundene lokale SSD (GiB) | Anzahl der physischen NICs | Maximale Netzwerkbandbreite (Gbit/s) | Anzahl der NVIDIA H200-GPUs | GPU-Speicher (GB HBM3e) |
|---|---|---|---|---|---|---|---|
a3-ultragpu-8g |
224 | 2.952 | 12.000 | 10 | 3.600 | 8 | 1128 |
Für die obige Tabelle gelten die folgenden Hinweise:
- vCPU-Anzahl: Eine vCPU ist als einzelner Hardware-Hyper-Thread auf einer der verfügbaren CPU-Plattformen implementiert.
- Maximale Netzwerkbandbreite: Die maximale Bandbreite für ausgehenden Traffic darf die angegebene Zahl nicht überschreiten. Die tatsächliche Bandbreite für ausgehenden Traffic hängt von der Ziel-IP-Adresse und anderen Faktoren ab. Weitere Informationen zur Netzwerkbandbreite finden Sie unter Netzwerkbandbreite.
- GPU-Arbeitsspeicher: GPU-Arbeitsspeicher ist der Speicher auf einem GPU-Gerät, der zum temporären Speichern von Daten verwendet werden kann. Er ist vom Arbeitsspeicher der Instanz getrennt und wurde speziell für die höheren Bandbreitenanforderungen grafikintensiver Arbeitslasten entwickelt.
A3 Mega-, High- und Edge-Maschinentypen
An diese Maschinentypen sind H100-GPUs angehängt. Jeder dieser Maschinentypen hat eine feste GPU-Anzahl, eine feste Anzahl von vCPUs und eine feste Arbeitsspeichergröße.
- A3-VMs mit einer einzelnen NIC: Für A3-VMs mit 1 bis 4 angehängten GPUs ist nur eine einzelne physische Netzwerkkarte (NIC) verfügbar.
- A3-VMs mit mehreren NICs: Für A3-VMs mit 8 angehängten GPUs sind mehrere physische NICs verfügbar. Für diese A3-Maschinentypen werden die NICs auf einem PCIe-Bus (Peripheral Component Interconnect Express) so angeordnet:
- Für den Maschinentyp „A3 Mega“ ist eine NIC-Anordnung von 8+1 verfügbar. Bei dieser Anordnung teilen sich 8 NICs denselben PCIe-Bus und 1 NIC befindet sich auf einem separaten PCIe-Bus.
- Für den Maschinentyp „A3 High“ ist eine NIC-Anordnung von 4+1 verfügbar. Bei dieser Anordnung teilen sich 4 NICs denselben PCIe-Bus und eine NIC befindet sich auf einem separaten PCIe-Bus.
- Für den Maschinentyp A3 Edge ist eine NIC-Anordnung von 4+1 verfügbar. Bei dieser Anordnung teilen sich 4 NICs denselben PCIe-Bus und eine NIC befindet sich auf einem separaten PCIe-Bus. Diese 5 NICs bieten eine Netzwerkbandbreite von insgesamt 400 Gbit/s pro VM.
NICs, die denselben PCIe-Bus verwenden, haben eine uneinheitliche Ausrichtung des Arbeitsspeicherzugriffs (NUMA) von einer NIC pro zwei NVIDIA H100-GPUs. Diese NICs sind ideal für die dedizierte GPU-zu-GPU-Kommunikation mit hoher Bandbreite. Die physische NIC, die sich auf einem separaten PCIe-Bus befindet, ist ideal für andere Netzwerkanforderungen. Eine Anleitung zum Einrichten von Netzwerken für A3 High- und A3 Edge-VMs finden Sie unter MTU-Netzwerke im Jumbo Frame einrichten.
A3 Mega
| Maschinentyp | vCPU Anzahl | Instanzarbeitsspeicher (GB) | Verbundene lokale SSD (GiB) | Anzahl der physischen NICs | Maximale Netzwerkbandbreite (Gbit/s) | Anzahl der NVIDIA H100-GPUs | GPU-Arbeitsspeicher (GB HBM3) |
|---|---|---|---|---|---|---|---|
a3-megagpu-8g |
208 | 1.872 | 6.000 | 9 | 1.800 | 8 | 640 |
A3 High
| Maschinentyp | vCPU Anzahl | Instanzarbeitsspeicher (GB) | Verbundene lokale SSD (GiB) | Anzahl der physischen NICs | Maximale Netzwerkbandbreite (Gbit/s) | Anzahl der NVIDIA H100-GPUs | GPU-Arbeitsspeicher (GB HBM3) |
|---|---|---|---|---|---|---|---|
a3-highgpu-1g |
26 | 234 | 750 | 1 | 25 | 1 | 80 |
a3-highgpu-2g |
52 | 468 | 1.500 | 1 | 50 | 2 | 160 |
a3-highgpu-4g |
104 | 936 | 3.000 | 1 | 100 | 4 | 320 |
a3-highgpu-8g |
208 | 1.872 | 6.000 | 5 | 1.000 | 8 | 640 |
A3 Edge
| Maschinentyp | vCPU Anzahl | Instanzarbeitsspeicher (GB) | Verbundene lokale SSD (GiB) | Anzahl der physischen NICs | Maximale Netzwerkbandbreite (Gbit/s) | Anzahl der NVIDIA H100-GPUs | GPU-Arbeitsspeicher (GB HBM3) |
|---|---|---|---|---|---|---|---|
a3-edgegpu-8g |
208 | 1.872 | 6.000 | 5 | 600 (asia-south1 und northamerica-northeast2) oder 400 (alle anderen A3 Edge-Regionen) |
8 | 640 |
Für die obige Tabelle gelten die folgenden Hinweise:
- vCPU-Anzahl: Eine vCPU ist als einzelner Hardware-Hyper-Thread auf einer der verfügbaren CPU-Plattformen implementiert.
- Maximale Netzwerkbandbreite: Die maximale Bandbreite für ausgehenden Traffic darf die angegebene Zahl nicht überschreiten. Die tatsächliche Bandbreite für ausgehenden Traffic hängt von der Ziel-IP-Adresse und anderen Faktoren ab. Weitere Informationen zur Netzwerkbandbreite finden Sie unter Netzwerkbandbreite.
- GPU-Arbeitsspeicher: GPU-Arbeitsspeicher ist der Speicher auf einem GPU-Gerät, der zum temporären Speichern von Daten verwendet werden kann. Er ist vom Arbeitsspeicher der Instanz getrennt und wurde speziell für die höheren Bandbreitenanforderungen grafikintensiver Arbeitslasten entwickelt.
A2-Maschinentypen
Jeder A2-Maschinentyp hat eine feste Anzahl von angehängten NVIDIA A100-GPUs mit 40 GB oder NVIDIA A100-GPUs mit 80 GB. Jeder Maschinentyp hat außerdem eine feste Anzahl an vCPUs und eine feste Arbeitsspeichergröße.
A2-Maschinenserien sind in zwei Typen verfügbar:
- A2 Ultra: Bei diesen Maschinentypen sind A100-GPUs mit 80 GB und eine lokale SSD angehängt.
- A2 Standard: An diese Maschinentypen sind A100-GPUs mit 40 GB angehängt.
A2-Ultra
| Maschinentyp | vCPU Anzahl | Instanzarbeitsspeicher (GB) | Verbundene lokale SSD (GiB) | Maximale Netzwerkbandbreite (Gbit/s) | Anzahl der NVIDIA A100-GPUs mit 80 GB | GPU-Speicher (GB HBM2e) |
|---|---|---|---|---|---|---|
a2-ultragpu-1g |
12 | 170 | 375 | 24 | 1 | 80 |
a2-ultragpu-2g |
24 | 340 | 750 | 32 | 2 | 160 |
a2-ultragpu-4g |
48 | 680 | 1.500 | 50 | 4 | 320 |
a2-ultragpu-8g |
96 | 1.360 | 3.000 | 100 | 8 | 640 |
A2-Standard
| Maschinentyp | vCPU Anzahl | Instanzarbeitsspeicher (GB) | Unterstützung lokaler SSDs | Maximale Netzwerkbandbreite (Gbit/s) | Anzahl der NVIDIA A100-GPUs mit 40 GB | GPU-Arbeitsspeicher (GB HBM2) |
|---|---|---|---|---|---|---|
a2-highgpu-1g |
12 | 85 | Ja | 24 | 1 | 40 |
a2-highgpu-2g |
24 | 170 | Ja | 32 | 2 | 80 |
a2-highgpu-4g |
48 | 340 | Ja | 50 | 4 | 160 |
a2-highgpu-8g |
96 | 680 | Ja | 100 | 8 | 320 |
a2-megagpu-16g |
96 | 1.360 | Ja | 100 | 16 | 640 |
Für die obige Tabelle gelten die folgenden Hinweise:
- vCPU-Anzahl: Eine vCPU ist als einzelner Hardware-Hyper-Thread auf einer der verfügbaren CPU-Plattformen implementiert.
- Maximale Netzwerkbandbreite: Die maximale Bandbreite für ausgehenden Traffic darf die angegebene Zahl nicht überschreiten. Die tatsächliche Bandbreite für ausgehenden Traffic hängt von der Ziel-IP-Adresse und anderen Faktoren ab. Weitere Informationen zur Netzwerkbandbreite finden Sie unter Netzwerkbandbreite.
- GPU-Arbeitsspeicher: GPU-Arbeitsspeicher ist der Speicher auf einem GPU-Gerät, der zum temporären Speichern von Daten verwendet werden kann. Er ist vom Arbeitsspeicher der Instanz getrennt und wurde speziell für die höheren Bandbreitenanforderungen grafikintensiver Arbeitslasten entwickelt.
G4-Maschinentypen
Beschleunigungsoptimierte G4-Maschinentypen verwenden NVIDIA RTX PRO 6000 Blackwell Server Edition-GPUs (nvidia-rtx-pro-6000) und eignen sich für NVIDIA Omniverse-Simulationsarbeitslasten, grafikintensive Anwendungen, Videotranscodierung und virtuelle Desktops. G4-Maschinentypen bieten im Vergleich zu Maschinentypen der A-Serie auch eine kostengünstige Lösung für die Ausführung von Single-Host-Inferenz und Modellabstimmung.
Sie können auch Titanium-SSD-Laufwerke hinzufügen, wenn Sie eine G4-Instanz erstellen. Informationen zur Anzahl der Laufwerke, die Sie anhängen können, finden Sie unter Maschinentypen, bei denen Sie eine bestimmte Anzahl von lokalen SSD-Laufwerken auswählen müssen. Informationen zu Einschränkungen für Maschinentypen finden Sie unter G4-Einschränkungen.
| Maschinentyp | vCPU Anzahl | Instanzarbeitsspeicher (GB) | Maximal unterstützte Titanium-SSD (GiB) | Anzahl der physischen NICs | Maximale Netzwerkbandbreite (Gbit/s) | Anzahl der NVIDIA RTX PRO 6000-GPUs | GPU-Speicher (GB GDDR7) |
|---|---|---|---|---|---|---|---|
g4-standard-6 |
6 | 22 | 0 | 1 | 20 | 1/8 | 12 |
g4-standard-12 |
12 | 45 | 375 | 1 | 20 | 1/4 | 24 |
g4-standard-24 |
24 | 90 | 750 | 1 | 20 | 1/2 | 48 |
g4-standard-48 |
48 | 180 | 1.500 | 1 | 50 | 1 | 96 |
g4-standard-96 |
96 | 360 | 3.000 | 1 | 100 | 2 | 192 |
g4-standard-192 |
192 | 720 | 6.000 | 1 | 200 | 4 | 384 |
g4-standard-384 |
384 | 1.440 | 12.000 | 2 | 400 | 8 | 768 |
Für die obige Tabelle gelten die folgenden Hinweise:
- vCPU-Anzahl: Eine vCPU ist als einzelner Hardware-Hyper-Thread auf einer der verfügbaren CPU-Plattformen implementiert.
- Maximale Netzwerkbandbreite: Die maximale Bandbreite für ausgehenden Traffic darf die angegebene Zahl nicht überschreiten. Die tatsächliche Bandbreite für ausgehenden Traffic hängt von der Ziel-IP-Adresse und anderen Faktoren ab. Weitere Informationen zur Netzwerkbandbreite finden Sie unter Netzwerkbandbreite.
- GPU-Arbeitsspeicher: GPU-Arbeitsspeicher ist der Speicher auf einem GPU-Gerät, der zum temporären Speichern von Daten verwendet werden kann. Er ist vom Arbeitsspeicher der Instanz getrennt und wurde speziell für die höheren Bandbreitenanforderungen grafikintensiver Arbeitslasten entwickelt.
G2-Maschinentypen
An beschleunigungsoptimierte G2-Maschinentypen sind NVIDIA L4-GPUs angehängt. Sie eignen sich ideal für kostenoptimierte Inferenz-, grafikintensive und Hochleistungs-Computing-Arbeitslasten.
Jeder G2-Maschinentyp hat auch einen Standardarbeitsspeicher und einen benutzerdefinierten Arbeitsspeicherbereich. Der benutzerdefinierte Arbeitsspeicherbereich definiert die Größe des Arbeitsspeichers, den Sie Ihrer Instanz für jeden Maschinentyp zuweisen können. Sie können beim Erstellen einer G2-Instanz auch lokale SSD-Laufwerke hinzufügen. Informationen zur Anzahl der Laufwerke, die Sie anhängen können, finden Sie unter Maschinentypen, bei denen Sie eine bestimmte Anzahl von lokalen SSD-Laufwerken auswählen müssen.
Um die höheren Netzwerkbandbreitenraten (50 Gbit/s oder höher) für die meisten GPU-Instanzen zu erhalten, wird die Verwendung von Google Virtual NIC (gVNIC) empfohlen. Weitere Informationen zum Erstellen von GPU-Instanzen, die gVNIC verwenden, finden Sie unter GPU-Instanzen mit höheren Bandbreiten erstellen.
| Maschinentyp | vCPU Anzahl | Standard-Instanzarbeitsspeicher (GB) | Benutzerdefinierter Instanzarbeitsspeicherbereich (GB) | Maximal unterstützte lokale SSD (GiB) | Maximale Netzwerkbandbreite (Gbit/s) | Anzahl der NVIDIA L4-GPUs | GPU-Speicher (GB GDDR6) |
|---|---|---|---|---|---|---|---|
g2-standard-4 |
4 | 16 | 16 bis 32 | 375 | 10 | 1 | 24 |
g2-standard-8 |
8 | 32 | 32 bis 54 | 375 | 16 | 1 | 24 |
g2-standard-12 |
12 | 48 | 48 bis 54 | 375 | 16 | 1 | 24 |
g2-standard-16 |
16 | 64 | 54 bis 64 | 375 | 32 | 1 | 24 |
g2-standard-24 |
24 | 96 | 96 bis 108 | 750 | 32 | 2 | 48 |
g2-standard-32 |
32 | 128 | 96 bis 128 | 375 | 32 | 1 | 24 |
g2-standard-48 |
48 | 192 | 192 bis 216 | 1.500 | 50 | 4 | 96 |
g2-standard-96 |
96 | 384 | 384 bis 432 | 3.000 | 100 | 8 | 192 |
Für die obige Tabelle gelten die folgenden Hinweise:
- vCPU-Anzahl: Eine vCPU ist als einzelner Hardware-Hyper-Thread auf einer der verfügbaren CPU-Plattformen implementiert.
- Maximale Netzwerkbandbreite: Die maximale Bandbreite für ausgehenden Traffic darf die angegebene Zahl nicht überschreiten. Die tatsächliche Bandbreite für ausgehenden Traffic hängt von der Ziel-IP-Adresse und anderen Faktoren ab. Weitere Informationen zur Netzwerkbandbreite finden Sie unter Netzwerkbandbreite.
- GPU-Arbeitsspeicher: GPU-Arbeitsspeicher ist der Speicher auf einem GPU-Gerät, der zum temporären Speichern von Daten verwendet werden kann. Er ist vom Arbeitsspeicher der Instanz getrennt und wurde speziell für die höheren Bandbreitenanforderungen grafikintensiver Arbeitslasten entwickelt.
N1- + GPU-Maschinentypen
Bei N1-VM-Instanzen für allgemeine Zwecke, an die T4- und V100-GPUs angeschlossen sind, können Sie basierend auf der Kombination aus GPU und Anzahl der vCPUs eine maximale Netzwerkbandbreite von bis zu 100 Gbit/s erhalten. Informationen zu allen anderen N1-GPU-Instanzen finden Sie unter Übersicht.
Lesen Sie den folgenden Abschnitt, um die maximale Netzwerkbandbreite zu berechnen, die für Ihre T4- und V100-Instanzen basierend auf dem GPU-Modell, der vCPU und der GPU-Anzahl verfügbar ist.
Weniger als 5 vCPUs
Für T4- und V100-Instanzen mit maximal 5 vCPUs steht eine maximale Netzwerkbandbreite von 10 Gbit/s zur Verfügung.
Mehr als 5 vCPUs
Bei T4- und V100-Instanzen mit mehr als 5 vCPUs wird die maximale Netzwerkbandbreite anhand der Anzahl der vCPUs und GPUs für diese VM berechnet.
Um die höheren Netzwerkbandbreitenraten (50 Gbit/s oder höher) für die meisten GPU-Instanzen zu erhalten, wird die Verwendung von Google Virtual NIC (gVNIC) empfohlen. Weitere Informationen zum Erstellen von GPU-Instanzen, die gVNIC verwenden, finden Sie unter GPU-Instanzen mit höheren Bandbreiten erstellen.
| GPU-Modell | Anzahl der GPUs | Berechnung der maximalen Netzwerkbandbreite |
|---|---|---|
| NVIDIA V100 | 1 | min(vcpu_count * 2, 32) |
| 2 | min(vcpu_count * 2, 32) |
|
| 4 | min(vcpu_count * 2, 50) |
|
| 8 | min(vcpu_count * 2, 100) |
|
| NVIDIA T4 | 1 | min(vcpu_count * 2, 32) |
| 2 | min(vcpu_count * 2, 50) |
|
| 4 | min(vcpu_count * 2, 100) |
MTU-Einstellungen und GPU-Maschinentypen
Wenn Sie den Netzwerkdurchsatz erhöhen möchten, legen Sie für Ihre VPC-Netzwerke einen höheren Wert für die maximale Übertragungseinheit (MTU) fest. Höhere MTU-Werte steigern die Paketgröße und reduzieren den Paketheader-Overhead, wodurch der Nutzlastdatendurchsatz erhöht wird.
Für GPU-Maschinentypen empfehlen wir die folgenden MTU-Einstellungen für Ihre VPC-Netzwerke.
| GPU-Maschinentyp | Empfohlene MTU (in Byte) | |
|---|---|---|
| Reguläres VPC-Netzwerk | RoCE-VPC-Netzwerk | |
|
8896 | 8896 |
|
8244 | – |
|
8896 | – |
Beachten Sie beim Festlegen des MTU-Werts Folgendes:
- 8192 entspricht zwei 4-KB-Seiten.
- 8244 wird in A3 Mega-, A3 High- und A3 Edge-VMs für GPU-NICs empfohlen, bei denen die Headeraufteilung aktiviert ist.
- Verwenden Sie den Wert 8896, sofern in der Tabelle nicht anders angegeben.
GPU-Maschinen mit hoher Bandbreite erstellen
Verwenden Sie eine der folgenden Methoden, um GPU-Instanzen mit höheren Netzwerkbandbreiten zu erstellen, je nach Maschinentyp:
Informationen zum Erstellen von A2-, G2- und N1-Instanzen, die höhere Netzwerkbandbreiten verwenden, finden Sie unter Höhere Netzwerkbandbreite für A2-, G2- und N1-Instanzen verwenden. Zum Testen oder Prüfen der Bandbreitengeschwindigkeit für diese Maschinen können Sie den Benchmarking-Test verwenden. Weitere Informationen finden Sie unter Netzwerkbandbreite prüfen.
Informationen zum Erstellen von A3 Mega-Instanzen mit höherer Netzwerkbandbreite finden Sie unter A3 Mega-Slurm-Cluster für ML-Training bereitstellen. Zum Testen oder Prüfen der Bandbreitengeschwindigkeit für diese Maschinen können Sie einen Benchmarking-Test verwenden. Folgen Sie dazu der Anleitung unter Netzwerkbandbreite prüfen.
Informationen zu A3 High- und A3 Edge-Instanzen, die höhere Netzwerkbandbreiten verwenden, finden Sie unter A3-VM mit aktiviertem GPUDirect-TCPX erstellen. Zum Testen oder Prüfen der Bandbreitengeschwindigkeit für diese Maschinen können Sie den Benchmarking-Test verwenden. Weitere Informationen finden Sie unter Netzwerkbandbreite prüfen.
Bei anderen beschleunigungsoptimierten Maschinentypen sind keine Maßnahmen erforderlich, um eine höhere Netzwerkbandbreite zu verwenden. Wenn Sie eine Instanz wie beschrieben erstellen, wird bereits eine hohe Netzwerkbandbreite verwendet. Informationen zum Erstellen von Instanzen für andere beschleunigungsoptimierte Maschinentypen finden Sie unter VM mit angehängten GPUs erstellen.
Nächste Schritte
- Weitere Informationen zu GPU-Plattformen
- Instanzen mit angehängten GPUs erstellen
- Höhere Netzwerkbandbreite verwenden
- GPU-Preisübersicht